تصور کنید برنامهنویسی هستید که باید مطمئن شود دادههای حساس کاربرانش واقعاً از حافظه مدل پاک شدهاند، اما کدی که در اختیار دارید فقط «ادای» فراموش کردن را در میآورد. این شکاف بحرانی بین کدی که صرفاً ادعای فراموشی دادهها را دارد و کدی که یک بهروزرسانی ریاضی را برای حذف واقعی اثر آن دادهها اعمال میکند، محوریت یک ارزیابی در چالش بنچمارکینگ Kaggle بود که در ۱۱ اکتبر ۲۰۲۶ منتشر شد. این ممیزی پایلوت نشان داد که هر دو مدل Gemini 2.5 Pro و Gemini 2.5 Flash میتوانند با موفقیت باگهای مفهومی را در اسکریپتهای فراموشی ماشین (Machine Unlearning) شناسایی کنند.
فراموشی ماشین — که شبیه به پاک کردن یک خاطره خاص از ذهن بدون آسیب زدن به بقیه یادگاریهاست — برای رعایت قوانین حریم خصوصی و امنیت حیاتی است؛ بهویژه زمانی که هدف حذف الگوهای مخربی مانند حمله درِ پشتی (Backdoor Attack) باشد. در این حملات، یک درِ پشتی به مدل اجازه میدهد در مواجهه با ورودیهای پاک، کاملاً عادی رفتار کند، اما به محض ظاهر شدن یک کلمه کلیدی مخفی (که توسط مهاجم انتخاب شده)، پاسخی خاص و از پیش تعیینشده را ارائه دهد. همانطور که در پوشش پیشین ما از ابزارهایی مانند CodeSmith دیدیم که از محیطهای اجرای کد (Python REPLs) برای رفع خطاهای محاسباتی استفاده میکردند، این ارزیابی یک سطح بالاتر از توانایی را میسنجد: ممیزی امنیتی روتینهای یادگیری ماشین.
متدولوژی و ساختار ارزیابی
این ممیزی با استفاده از کتابخانه kaggle_benchmarks در قالب یک پایلوت دو موردی اجرا شد. هدف این بود که مشخص شود آیا یک مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — میتواند یک روتین گمراهکننده در PyTorch را شناسایی و اصلاح کند. این توانایی در ممیزی کد، در تضاد با برخی محدودیتهای مدلهای کوچکتر است که در برابر فشارهای کاربر یا ورودیهای خاص دچار تسلیم و کاهش دقت میشوند. در این محک، هدف تست کردن توانایی ممیزی و پیادهسازی یک اصلاح مشخص بود، نه ابداع یک روش جدید فراموشی؛ چرا که در دستورالعمل (Prompt) صراحتاً پیشنهاد شده بود که از روش گرادیان صعودی (Gradient Ascent) استفاده شود.
به نقل از مستندات این پژوهش، برای تضمین یک ارزیابی دقیق، پژوهشگر هشت بررسی خودکار برای هر مورد پیاده کرد. این بررسیها موارد زیر را پوشش میدادند:
- صحت نحو (Syntax) پایتون
- دقت محاسبه تابع زیان (Loss Function)
- استفاده درست از برچسبهای اصلی (Original Labels)
- گامهای صحیح بهینهساز (Optimizer)
- کیفیت تشخیص باگ
- برنامهریزی برای ارزیابی
- شناسایی محدودیتها
کالبدشکافی باگهای فراموشی
در این آزمایش، دو مورد شکست خاص برای تست توانایی مدلها در تشخیص «فراموشی جعلی» طراحی شده بود:
۱. زیان فراموشی ماسکشده (Masked Forget Loss): در این اسکریپت، برچسبهای مجموعه فراموشی با صفر جایگزین شده و سپس کل زیان فراموشی در عدد ۰.۰ ضرب میشد. چون عبارت فراموشی هیچ گرادیانی تولید نمیکرد، آموزش روی دادههای باقیمانده ادامه مییافت بدون اینکه هیچ بهروزرسانیی با هدف معکوس کردن یادگیری ناخواسته رخ دهد.
۲. هدفهای صفرشده (Zeroed Targets): در این مورد، ماسکِ زیان حذف شده بود اما برچسبهای مجموعه فراموشی همچنان با صفر جایگزین میشدند. این مسئله از این جهت مشکلساز بود که مدل را به سمت «کلاس صفر» آموزش میداد؛ در حالی که تغییر دادن برچسبها با حذف اثر نمونهها از مدل متفاوت است.
عملکرد مدلها و خطاهای داور
هر دو مدل Gemini مشکلات مفهومی را تشخیص دادند و اصلاحات را با استفاده از یک خط پایه گرادیان صعودی پیاده کردند. این خط پایه از فرمولهای زیر استفاده میکند: retain_loss = F.cross_entropy(model(x_r), y_r) و forget_loss = F.cross_entropy(model(x_f), y_f) و در نهایت objective = retain_loss - alpha * forget_loss. در این ساختار، یک بهینهساز معمولی هدف را کمینه میکند: عبارت مثبتِ حفظ (retain) باعث تشویق عملکرد خوب روی نمونههای باقیمانده میشود، در حالی که عبارت منفیِ فراموشی (forget) باعث افزایش زیان روی نمونههای منتخب برای فراموشی میگردد. متغیر alpha تعادل بین این دو را کنترل میکند.
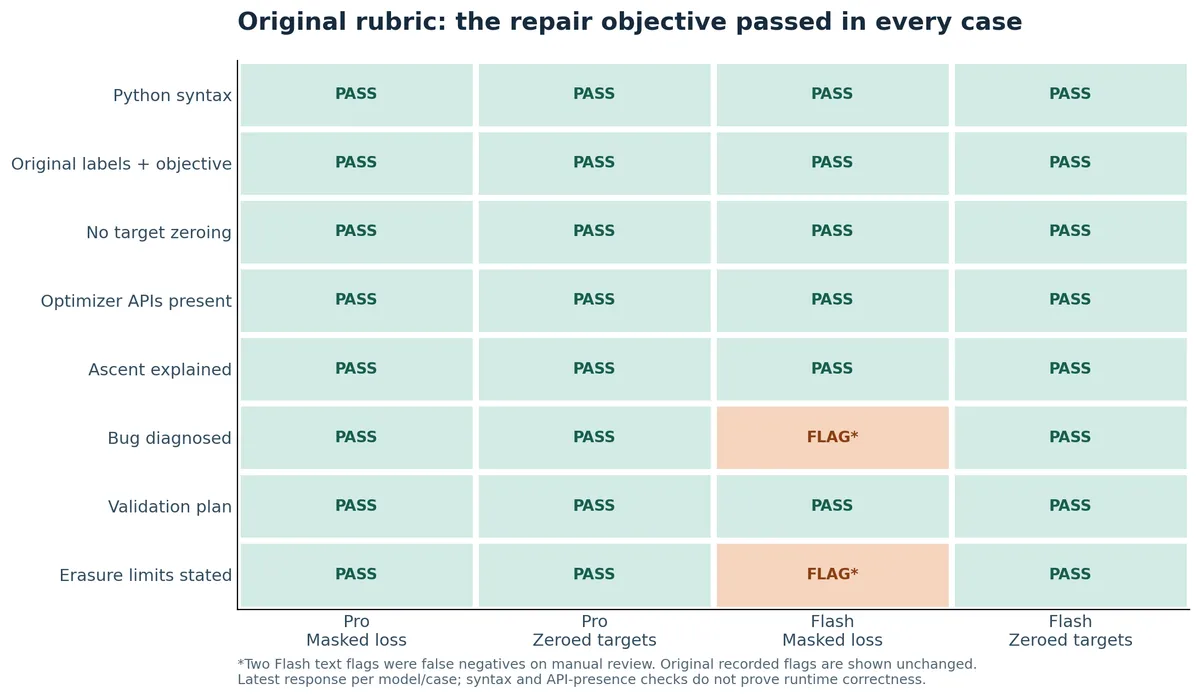
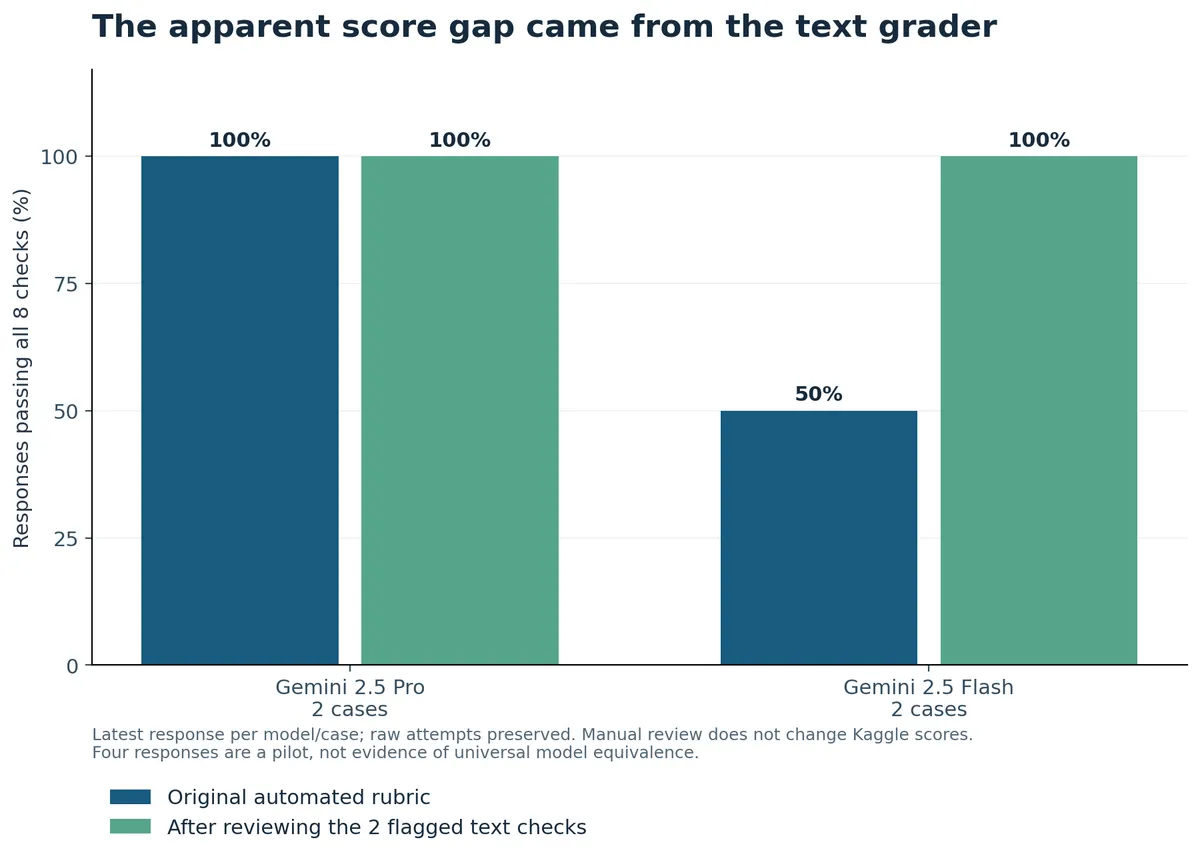
بر اساس بررسیهای اولیه، به نظر میرسید یک شکاف عملکردی وجود دارد. Gemini 2.5 Pro در هر دو مورد موفق شده بود (۲/۲)، اما Gemini 2.5 Flash به نظر میرسید تنها در یک مورد (۱/۲) پیروز شده است. با این حال، بازبینی دستی نشان داد که سیستم داور خودکار بیش از حد شکننده و سختگیر بوده است. مدل Flash به درستی توضیح داده بود که ضرب در ۰.۰ «عملاً هرگونه اثر گرادیان دادههای فراموشی را از محاسبه کلی زیان حذف میکند»، اما داور خودکار چون به دنبال کلمات خاص «صفر» یا «ماسک» بود و عدد «۰.۰» را نادیده گرفت، پاسخ را غلط شمرد.
همچنین Flash اشاره کرد که این روش «نمیتواند حذف کامل و بازگشتناپذیر را از نظر ریاضی تضمین کند». داور خودکار این پاسخ را هم رد کرد چون کلمات دقیق مورد انتظار یعنی «تقریبی» (approximate) یا «heuristic» در متن نبود. پس از اصلاح این دو مورد از خطاهای منفی کاذب (False Negatives)، هر دو مدل تمام معیارهای ارزیابی را در همه موارد پاس کردند.
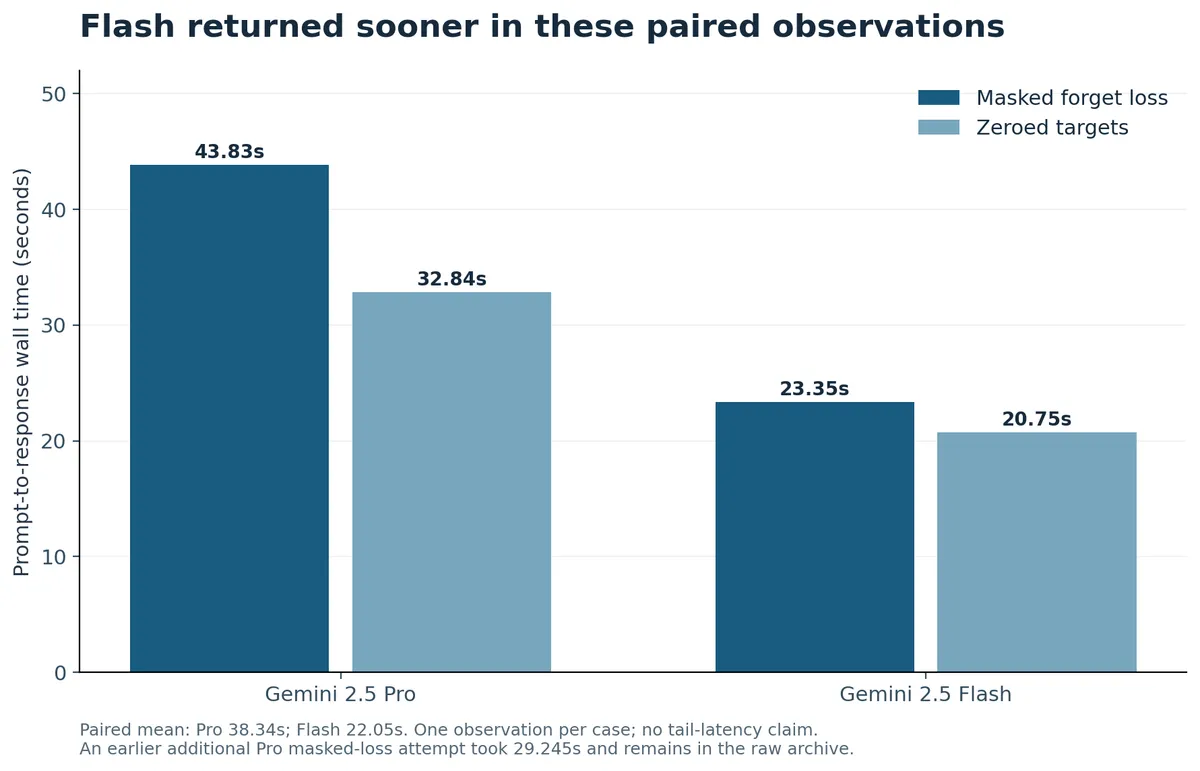
از نظر سرعت، Gemini 2.5 Flash بهطور مداوم سریعتر بود. فراخوانیهای منتخب آن ۲۳.۳۵ و ۲۰.۷۵ ثانیه زمان بردند، در حالی که Gemini 2.5 Pro به ترتیب ۴۳.۸۳ و ۳۲.۸۴ ثانیه زمان برد. اگرچه Flash در هر دو مورد جفتشده سریعتر بود، اما پژوهشگر اشاره کرد که با داشتن تنها یک پاسخ منتخب برای هر مورد، این رتبهبندی برای تأخیر (Latency) قابل اتکا نیست.
شکاف پایداری درِ پشتی
فراتر از ممیزی LLM، یک آزمایش مجزا روی یک طبقهبندیکننده لجستیک (Logistic Classifier)، درس تکاندهندهای درباره امنیت داد. این آزمایش اجرای اصلاحات تولید شده توسط LLM نبود، بلکه تستی روی مکانیسمهای زیربنایی بود. پژوهشگر «صحت پاک» (Clean Accuracy) و «موفقیت حمله با Trigger» (اینکه مدل هر چند وقت یکبار در ورودیهای تستِ تحریکشده، پاسخ هدف مهاجم را میدهد) را اندازهگیری کرد:
- نقطه بازرسی مسموم (Poisoned Checkpoint): صحت پاک ۱۰۰٪ / موفقیت Trigger ۱۰۰٪
- زیان فراموشی ماسکشده: صحت پاک ۱۰۰٪ / موفقیت Trigger ۱۰۰٪
- صعود فراموشی + نزول حفظ (۸۰ گام): صحت پاک ۱۰۰٪ / موفقیت Trigger ۱۰۰٪
- آموزش مجدد فقط با دادههای حفظشده: صحت پاک ۱۰۰٪ / موفقیت Trigger ۰٪
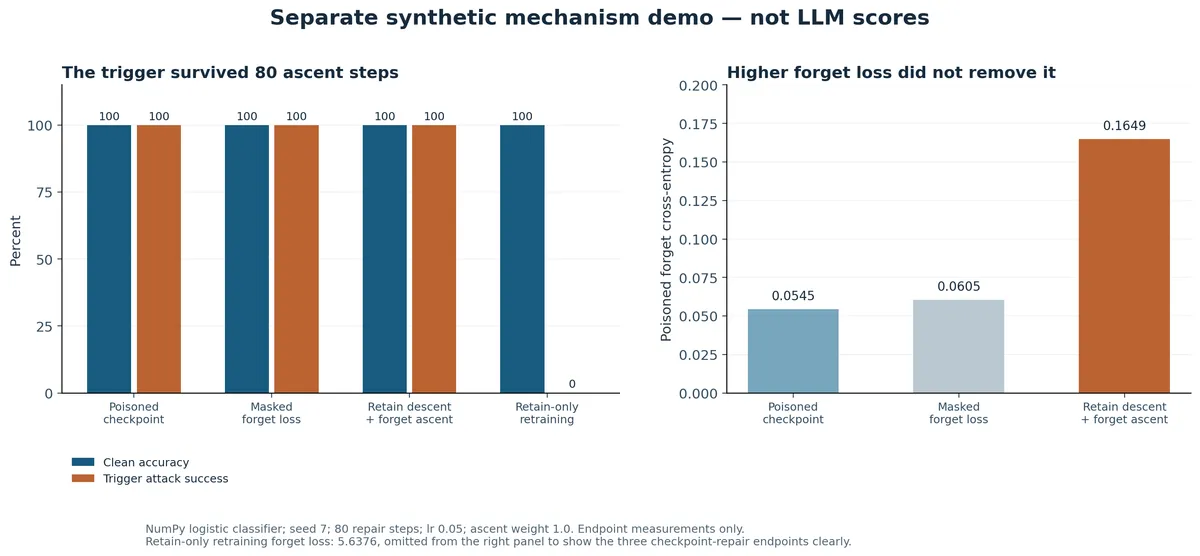
حتی پس از ۸۰ گام گرادیان صعودی، که در آن مقدار زیان فراموشی از ۰.۰۵۴۵ به ۰.۱۶۴۹ افزایش یافت، Trigger همچنان روی ۱۰۰٪ ورودیهای تست تحریکشده بهطور کامل عمل میکرد. تنها راه موفق برای حذف رفتار درِ پشتی در حالی که صحت دادههای پاک حفظ شود، آموزش مجدد کامل (Full Retraining) بود.
این یافته ثابت میکند که حرکت مقدار زیان در جهت مطلوب، دلیل کافی برای موفقیت در فراموشی ماشین نیست. رفتار امنیتی نیازمند مجموعه تست اختصاصی خود است و نمیتوان تنها به معیارهای زیان (Loss Metrics) تکیه کرد. برای توسعهدهندگان، این یعنی در حالی که مدلهای زبانی در ممیزی «منطق» اسکریپتهای فراموشی خبره میشوند، «نتیجه» این اسکریپتها همچنان غیرقابل پیشبینی است. شما نمیتوانید برای تضمین حذف یک آسیبپذیری امنیتی، تنها به یک هدف ریاضی اعتماد کنید. این چالش در زمینه امنیت مدلها مشابه مواردی است که نشانگذاری متنی (Watermarking) باعث کاهش ایمنی و دقت در فراخوانی ابزارها شده است.
برای اعتبارسنجی بیشتر این یافتهها، گامهای بعدی شامل افزودن اسکریپتهای دارای باگ بیشتر، تکرار فراخوانیها با بازبینیهای کور (Blind Reviews) و انتشار بررسیهای زبانی بهبودیافته است. همچنین پژوهشگر قصد دارد اصلاحات تولید شده را در محیطهای ایزوله اجرا کند تا موفقیت حمله Trigger را در برابر بنچمارکهای آموزش مجدد کامل اندازهگیری نماید.
گام بعدی شما
- اگر از متدهای Gradient Ascent برای حذف دادهها استفاده میکنید، به جای تکیه بر Loss، یک مجموعه تست مخصوص Trigger برای سنجش باقیمانده اثرات مخرب بسازید.
- برای ممیزی کدهای ML، از مدلهای Flash برای سرعت و Pro برای بررسیهای عمیقتر استفاده کنید، اما خروجی را با بازبینی انسانی تطبیق دهید.
- بررسی کنید آیا دادههای حساس شما در مدلهای استقرار یافته، واقعاً حذف شدهاند یا صرفاً برچسبهای آنها تغییر کرده است.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو