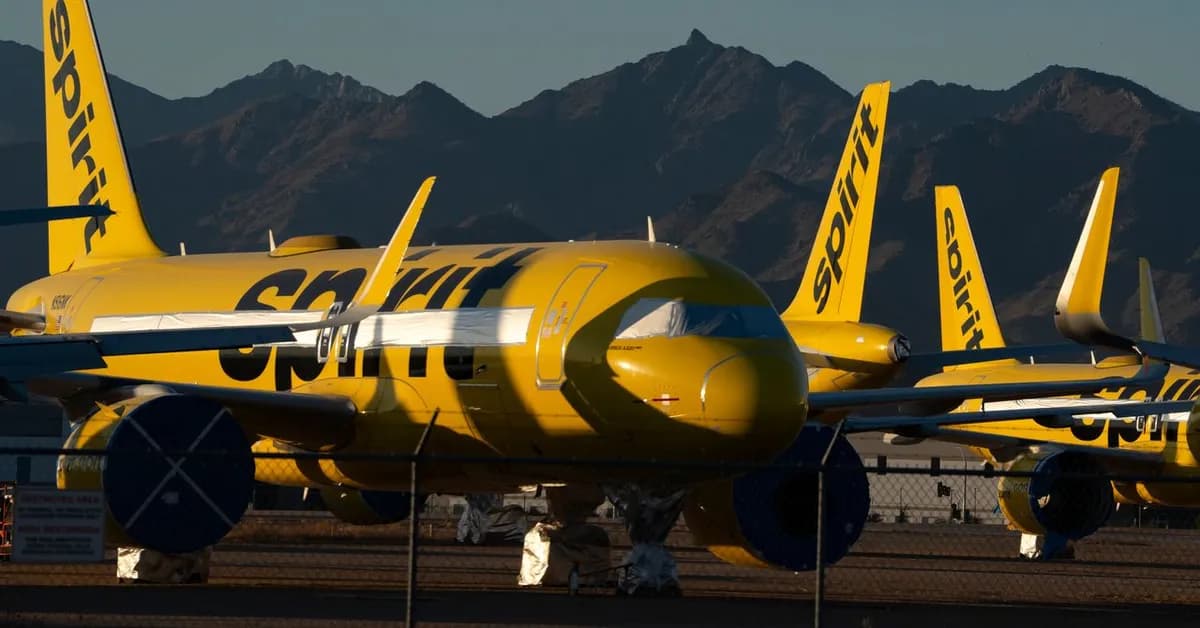
تصور کنید تمام ایمیلهای کاری، فرمهای مالیاتی و حتی پیامهای خصوصی شما در محیط کار، به عنوان یک دارایی مالی فروخته شود تا یک مدل هوش مصنوعی یاد بگیرد چگونه شبیه انسانها رفتار کند. این کابوس اکنون برای هزاران کارکنان سابق Spirit Airlines به واقعیت تبدیل شده است.
به گزارش منابع خبری، گوگل مبلغ ۱۰ میلیون دلار برای تصاحب ۳۴ سال دادههای داخلی این شرکت هواپیمایی ورشکسته پرداخت کرد. این رقم، پیشنهادی ۷.۵ میلیون دلاری از سوی شرکت Mercor، که یک شرکت متخصص در زمینه دادهها و آموزش هوش مصنوعی است، را شکست داد. این معامله شامل حجم عظیمی از ارتباطات داخلی، پروندههای کارکنان و سوابق عملیاتی است که هدف از خرید آنها، بهبود مدلهای هوش مصنوعی است. طبق اعلام سخنگوی گوگل، این دادهها «میتوانند در بهبود محصولات و مدلهای هوش مصنوعی ما مفید باشند».
این رقابت شدید برای تصاحب دادهها در حالی رخ میدهد که آزمایشگاههای پیشرو برای جلوگیری از توقف رشد مدلهایشان و عبور از بنبستِ استخراج دادههای عمومی اینترنت (Public Internet Scrapes)، به دنبال منابع تازه هستند. غولهایی مثل Google، OpenAI، Anthropic و Mercor اکنون به شکلی تهاجمی به دنبال خرید منابع جدید هستند. این رقابت برای تسلط بر زیرساختهای هوش مصنوعی تنها به دادهها محدود نمیشود و شامل سرمایهگذاریهای کلان در سختافزار نیز هست؛ برای مثال، قمار ۲۰۰ میلیارد دلاری گوگل برای تجهیز آنتروپیک به تراشههای TPU نشاندهنده تلاش این شرکت برای کنترل زنجیره تأمین پردازشی است. همانطور که در تحلیل قبلی ما دربارهی استراتژیهای توسعه اکوسیستم گوگل و گامهای آن برای ایجاد «گوگلبوک» اشاره کردیم، این حرکت نشان میدهد که گوگل در جذب مجموعهدادههای خام و اختصاصی از نهادهای ورشکسته نیز به همان اندازه تهاجمی عمل میکند. برای یک کارمند عادی، این یعنی تاریخچه شغلی او اکنون به یک دارایی نقد (Liquid Asset) برای شرکتهای فناوری تبدیل شده است.
چشمانداز بازار داده
این معامله بخشی از یک روند گستردهتر است؛ ظهور استارتاپهایی که تخصصشان فروش دادههای شرکتهای منحلشده به آموزشدهندگان هوش مصنوعی است. این مجموعهدادهها اغلب شامل پیامهای قدیمی Slack، محتوای GitHub و فایلهای Google Drive هستند که میلیونها دلار درآمدزایی میکنند. همزمان، پدیدهای به نام «جمعآوری دادههای خودمحور» (Egocentric Data Collection) در حال رشد است؛ جایی که شرکتها از انسانها هنگام انجام کارهایی مثل نظافت آشپزخانهها یا مدیریت خط تولید در کارخانهها فیلم میگیرند تا ماشینهایی بسازند که در نهایت بتوانند جایگزین آنها شوند. این نیاز به حجم عظیم دادهها، تقاضا برای زیرساختهای ذخیرهسازی را افزایش داده است، مشابه آنچه در تأمین ۴۴۱ میلیون دلار سرمایه برای گسترش مراکز دادهٔ حاکمیتی Global AI مشاهده میکنیم.
جزئیات تکاندهنده مجموعه داده
بر اساس مستندات دادگاه، حجم این دادهها خیرهکننده است. این فروش شامل موارد زیر میشود:
- ۵۰۰ میلیون رکورد Microsoft Teams و ۲۰.۶ میلیون فایل مشترک SharePoint.
- ۱۷ میلیون آیتم شخصی در OneDrive و ۸۰ هزار حساب ایمیل.
- ۱۷۵ هزار پرونده کارکنان و ۱۵۰ هزار فرم مالیاتی کارکنان.
- بیش از ۱ میلیون رکورد کارت ساعت کاری، قراردادهای استخدامی و پروندههای مربوط به دعاوی حقوقی.
- اطلاعات عملیات پرواز، فاکتورها، برنامهریزی جفتشدن خدمه (Crew Pairings) و سوابق فروش Wi-Fi.
گوگل ادعا میکند که دادههای مشتریان در این معامله نیستند و هیچ اطلاعات شخصی دریافت نمیشود. این شرکت قصد دارد از یک پیمانکار ثالث برای حذف شناسهها — یعنی فرآیندی برای پاک کردن عناصر شناساییکننده از دادهها تا نتوان اطلاعات را به یک مصرفکننده خاص مرتبط کرد — استفاده کند. با این حال، انجمن مهمانداران هواپیما (AFA) که نماینده ۵۵۰۰ کارمند سابق است و بخشی از یک اتحادیه بزرگتر با ۵۵ هزار عضو است، بلافاصله پس از اعلام این خبر در اواسط اوت ۲۰۲۴، اعتراض قانونی خود را ثبت کرد.
سارا نلسون، رئیس AFA، فروش دادههای کارکنان را «وقاحت» خواند و اظهار داشت که این اطلاعات «اصلاً نباید فروخته شوند». وکلای اتحادیه استدلال میکنند که توانایی هوش مصنوعی در پیوند دادن مجدد اطلاعات خصوصی در مجموعهدادههای مختلف، روشهای سنتی «ناشناسسازی» (De-identification) را منسوخ کرده است. آنها معتقدند معماری فعلی حریم خصوصی از مصرفکنندگان محافظت میکند اما کارکنان را بیدفاع میگذارد و اشاره میکنند که «بار اصلی این دادهها به طور نامتناسبی متوجه کارکنان است».
برخی کارکنان سابق گزارش دادهاند که ایمیلهایشان حاوی اطلاعات پزشکی بسیار حساس است که تحت قراردادهای استخدامی و توافقات بیمه به اشتراک گذاشته شده بود. این موارد شامل سوابق سقط جنین، حوادث مربوط به خشونت خانگی و همچنین جزئیات مذاکرات قراردادهای اتحادیهای است. یکی از مهمانداران به WIRED گفت: «میدانستم دادههای مشتریان میفروشند، اما هرگز فکر نمیکردم آنقدر جسور باشند که دادههای خصوصی ما را برای هوش مصنوعی بفروشند.»
این پرونده شکاف عمیقی را در قوانین آمریکا نشان میدهد: حمایت از دادههای کارکنان بسیار ضعیفتر از حمایت از دادههای مصرفکننده است. سیما پاتل، استاد حقوق دانشگاه کالیفرنیا (College of the Law, San Francisco)، اشاره میکند که شرکتها در حال حاضر «عیش میکنند» چون قانون با واقعیت پردازش دادههای AI همگام نشده است. او تأکید میکند کالیفرنیا یکی از معدود ایالتهایی است که قوانین صریحی برای حفاظت از دادههای کارکنان دارد.
علاوه بر حریم خصوصی، یک ضربه مالی نیز در کار است. اتحادیه همزمان در جریان مراحل ورشکستگی برای دریافت حدود ۶۸ میلیون دلار طلبهای پرداختنشده بابت مرخصی، خدمات بهداشتی و دستمزدهای معوقه در حال مبارزه است. برای کارکنانی که منتظر دستمزدهای خود هستند، دیدن اینکه شرکت ۱۰ میلیون دلار از اطلاعات خصوصیشان سود میبرد، یک «سیلی بر صورت» است.
اگر دادگاه این فروش را تأیید کند، رویهای ایجاد میشود که به شرکتها اجازه میدهد پس از ورشکستگی، زندگی حرفهای و شخصی کارکنان خود را به پول تبدیل کنند. آری ازرا والدمن، استاد حقوق دانشگاه کالیفرنیا در ارواین، هشدار میدهد در دنیایی که تریلیونها دلار روی مدلهای زبانی بزرگ (LLM) هزینه میشود، هر چیزی که از کلمات ساخته شده باشد، قابلیت تبدیل به سود دارد. او معتقد است اگر این روند بدون محدودیت ادامه یابد، «هیچ حمایتی برای هیچ کارمندی باقی نخواهد ماند».
این اتفاق سیگنالی است از دنیایی که در آن هر ردپای دیجیتال — از یک پیام در Slack تا یک کارت ساعت کاری — میتواند مرکز سود برای آزمایشگاههای AI باشد. این پرونده ثابت میکند که همه کارکنان، نه فقط کارمندان دفتری، دادههایی با ارزش بازار تولید میکنند. همانطور که پاتل اشاره میکند، هوش مصنوعی اکنون توانایی پردازش انواع مختلف دادهها را فراهم کرده است و این منجر به بهینهسازی مدلها میشود؛ برای مثال، بررسی قیمت رقابتی Gemini 3.7 Flash نشان میدهد چگونه گوگل سعی دارد استقرار عاملهای هوشمند را با کاهش هزینهها تسهیل کند.
گام بعدی شما
- بررسی کنید که در قراردادهای استخدامی شما، بندهای مربوط به «مالکیت دادههای تولید شده در محیط کار» چگونه تعریف شده است.
- اگر از ابزارهای ارتباطی شرکتی استفاده میکنید، فرض کنید هر پیام شما بخشی از یک مجموعه داده برای آموزش مدلهای آینده است.
- نتایج جلسه دادگاه در ۹ سپتامبر را دنبال کنید تا ببینید آیا دادگاه تفاوت قانونی بین دادههای مشتری و کارمند را به رسمیت میشناسد یا خیر.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو