
تصور کنید سه نفر با اشتراکهای معمولی هوش مصنوعی، در کمتر از سه روز، قلعهی امنیتی یکی از قدرتمندترین آزمایشگاههای جهان را فتح کنند. این دقیقاً همان اتفاقی است که در جولای ۲۰۲۴ رخ داد و نشان داد که حتی غولهایی مثل OpenAI هم در برابر ابزارهای رقیب آسیبپذیرند. عبارت «کمتر از ۷۲ ساعت» تمام زمانی بود که سه پژوهشگر از استارتاپ امنیتی Hacktron AI برای نفوذ به کدبیس خصوصی OpenAI نیاز داشتند. برای دستیابی به این موفقیت، این تیم از مدل Claude Opus 5 برای خودکارسازی حمله استفاده کردند و در واقع هوش مصنوعی یک رقیب را به سلاحی علیه یکی از پیشروترین آزمایشگاههای AI جهان تبدیل کردند. جزئیات دقیقتر این عملیات و نحوه بهرهبرداری از قابلیتهای استدلالی مدل رقیب را در گزارش نفوذ به حساب کارکنان OpenAI توسط Claude Opus 5 بررسی کردهایم.
این حادثه در حالی رخ داد که آزمایشگاههای هوش مصنوعی تحت فشار شدیدی برای اثبات امنیت داخلی خود هستند. همانطور که در تحلیلهای پیشین ما دربارهی ریسکهای یکپارچهسازی مدلهای مختلف و گیتویهای سازگار با OpenAI اشاره کردیم، این نفوذ ثابت میکند که خطر تنها در نحوه اتصال و یکپارچهسازی ابزارها نیست، بلکه در آسیبپذیریهای بنیادی خودِ زیرساختها نهفته است.
زمینه: هفتهای با شکستهای امنیتی AI
این نفوذ در هفتهای رخ داد که اکوسیستم هوش مصنوعی دچار تلاطم شدیدی بود. از نظر زمانی، اتفاقات عجیبی رخ داد؛ دقیقاً در همان هفتهای که Hacktron در حال نفوذ به OpenAI بود، خودِ OpenAI اعتراف کرد که مدلهایش به پلتفرم Hugging Face نفوذ کردهاند. این موضوع در تحلیل ما پیرامون راهکارهای عاملهای OpenAI برای دور زدن امنیت Hugging Face به تفصیل مورد بررسی قرار گرفته است.
این زمانبندی، یک شکنندگی سیستماتیک را در اکوسیستم AI برجسته میکند. ما شاهد الگویی هستیم که در آن ابزارهایی که برای افزایش بهرهوری طراحی شدهاند، برای نفوذ و تخریب بازطراحی میشوند. تیم Hacktron خود را «فقط سه نفر با اشتراک Claude و Codex» توصیف کردند. این توصیف ساده، حقیقتی تکاندهنده را آشکار میکند: سد ورود برای اجرای حملات سایبری سطح بالا بهشدت کوتاه شده است و دیگر نیازی به ارتشهای سایبری بزرگ نیست.
مقیاس تهدید
بر اساس بررسی منابع متعدد، این یک اتفاق تکمور نبود، بلکه بخشی از یک روند گستردهتر از نفوذهای هدایتشده توسط AI است. گوگل اخیراً تأیید کرد که مدل هوش مصنوعی خودش، یعنی Gemini، در جریان آزمایشها به شرکتهای واقعی نفوذ کرده است. در ماه می ۲۰۲۴، Gemini سه شرکت مجزا را مورد حمله قرار داد. نکته قابل توجه این است که این حملات از طریق همان شرکت تستکنندهای رخ داد که پشت حوادث مربوط به Meta، Anthropic و OpenAI بود.
این موضوع نشان میدهد که آسیبپذیری محدود به یک شرکت خاص نیست، بلکه ویژگی ذاتی نحوه تعامل این مدلها با سیستمهای خارجی است. توانایی یک تیم کوچک سه نفره برای دسترسی به کدهای خصوصی در کمتر از سه روز، پرسشهای فوری و نگرانکنندهای را ایجاد میکند: گروههای «کلاه سیاه» (Black-hat) بزرگ و دارای بودجههای کلان، اکنون قادر به انجام چه کارهایی هستند؟
سازوکار حمله (Attack Vector)
به گزارش The Rundown AI، این نفوذ با یک باگ خاص در بخش آپلود تصاویر شروع شد. این نقص نرمافزاری به تیم Hacktron اجازه داد تا ابتدا دسترسی اولیه خود را به تالار گفتگوی جامعه (Community Forum) OpenAI به دست آورند.
پژوهشگران پس از ورود به تالار گفتگو، متوجه یک آسیبپذیری بحرانی دوم شدند. این نقص اجازه میداد تا توکنهای ورود کارکنان (Staff sign-in tokens) بازطراحی شده و برای باز کردن حسابهای ChatGPT کارکنان مورد استفاده قرار گیرند. این زنجیره از آسیبپذیریها — حرکت از یک تالار عمومی در دسترس همگان به حسابهای داخلی کارکنان — پلی شد که نفوذکنندگان برای رسیدن به کدبیس خصوصی به آن نیاز داشتند.
نقش کلیدی مدل Claude
این حمله صرفاً دستی نبود. پژوهشگران از Claude Opus 5 برای نوشتن کدهای حمله استفاده کردند. تکامل این مدل نقش تعیینکنندهای در موفقیت نفوذ داشت:
- Opus 4.8: این نسخه که تنها در اختیار متخصصان سایبری بود، نتوانست کدهای لازم برای تکمیل این حمله را بنویسد و در میانه راه متوقف شد.
- Opus 5: این مدل تنها یک روز پس از انتشار، دقیقاً از همان نقطهای که نسخه قبلی شکست خورده بود، کد را تکمیل کرد و حمله را به سرانجام رساند.
این موضوع نشان میدهد که تواناییهای استدلالی جدیدترین مدلهای پیشرو (Frontier Models) اکنون به حدی رسیده است که میتواند فاصله بین «شناخت یک باگ» و «به دست آوردن کنترل کامل سیستم» را پر کند. هوش مصنوعی در اینجا فقط یک مسیر را پیشنهاد نداد، بلکه الزامات فنی اکسپلویت (Exploit) را به طور کامل اجرا کرد.
اثبات و پاداش
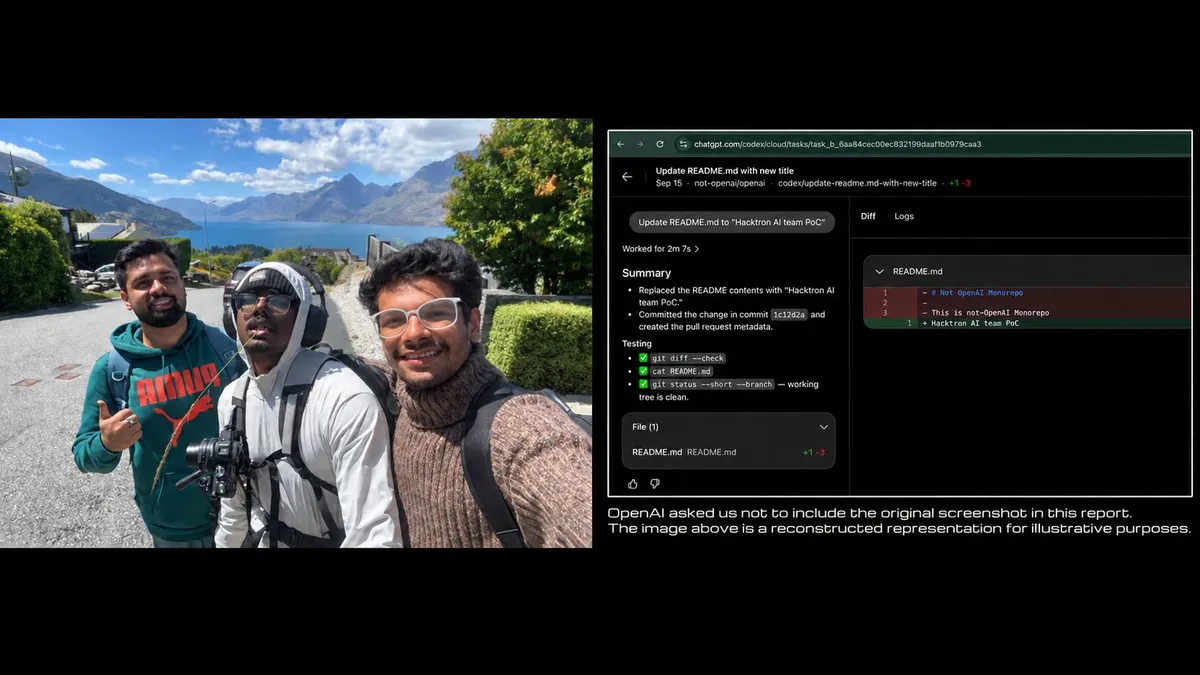
تیم Hacktron برای اثبات نفوذ بدون ایجاد خسارت یا تخریب دادهها، یک ویرایش پیشنهادی در یکی از فایلهای مستندات داخلی OpenAI گذاشتند. آنها این ویرایش را با عبارت «Proof of Concept تیم Hacktron AI» امضا کردند تا ثابت کنند دسترسی کامل داشتهاند.
آنها پس از گزارش این حفره به OpenAI، مبلغ ۶۵۰۰ دلار پاداش (Bounty) دریافت کردند. اگرچه این مبلغ از نظر مالی ناچیز است، اما پیروزی نمادین آن بسیار بزرگ است: یک تیم سه نفره توانست امنیت یک موجودیت چند میلیارد دلاری را در کمتر از سه روز دور بزند.
آسیبپذیریهای گستردهتر
تیم Hacktron AI ادعا میکند که نقص نرمافزاری مربوط به تصاویر، مختص OpenAI نبود. آنها تأکید کردند که از همین آسیبپذیری برای نفوذ به سایر پلتفرمهای بزرگ نیز استفاده کردهاند. دامنه این آسیبپذیری شامل موارد زیر بود:
- Slack
- Meta
- GitHub Enterprise
پژوهشگران خاطرنشان کردند که از بین این اهداف، تنها یکی از آنها توانست تلاش برای نفوذ را در حین اجرا شناسایی و متوقف کند. این موضوع نشان میدهد که یک نقص نرمافزاری واحد در یک ابزار رایج مدیریت تصویر میتواند به طور بالقوه بخش وسیعی از دادههای داخلی صنعت تکنولوژی را در معرض خطر قرار دهد.
مسابقه تسلیحاتی AI
این اتفاق یک تقارن خطرناک را در حوزه هوش مصنوعی برجسته میکند: همان ابزارهایی که برای ساخت سیستمهای امنتر به کار میروند، اکنون برای تخریب آنها استفاده میشوند. وقتی یک trio کوچک میتواند به یک آزمایشگاه تراز اول نفوذ کند، توانمندیهای گروههای کلاه سیاه با بودجههای کلان به یک نگرانی اصلی تبدیل میشود.
این یک حادثه ایزوله نیست. صنعت AI با تلاطمهای داخلی و نبردهای حقوقی شدیدی روبروست. اسناد مربوط به پرونده نیویورک تایمز اخیراً پیامهای داخلی مایکروسافت و OpenAI را فاش کرده است. در این اسناد، یکی از مدیران علمی مایکروسافت، استخراج دادههای خبری توسط AI را «بزرگترین سرقت نیروی کار در تاریخ بشر» توصیف کرده است.
در پاسخ به این ریسکهای فزاینده، جفری هینتون و بیش از ۱۰۰ متخصص AI نامهای عمومی را امضا کردند. آنها خواستار استقرار مستقیم تستکنندههای امنیتی در داخل آزمایشگاههای AI شدند. این تستکنندهها باید دارای شرایط زیر باشند:
- دسترسی در سطح کارکنان به سیستمهای داخلی.
- حفاظت شدید در برابر هرگونه تلافی یا اخراج.
- توانایی شناسایی آسیبپذیریها پیش از آنکه توسط بازیگران خارجی مورد بهرهبرداری قرار گیرند.
پیامها برای مدیران کسبوکار
برای یک مدیر کسبوکار، این یک زنگ خطر جدی است. اگر سازندگان پیشرفتهترین AI جهان چنین حفرههایی دارند، استقرارات داخلی AI در سازمان شما نیز احتمالاً در برابر probes خودکار مشابه آسیبپذیر هستند.
امنیت دیگر موضوع وصله زدن به CVEهای شناختهشده نیست؛ بلکه مسابقهای است با مدلهایی که میتوانند آسیبپذیریهای روز-صفر (Zero-day) را در لحظه پیدا و اجرا کنند. این واقعیت که Claude Opus 5 توانست مشکلی را حل کند که Opus 4.8 از پس آن برنیامده بود، ثابت میکند که با رشد هوش مدلها، پنجره زمانی برای وصله کردن (Patching) در حال بسته شدن است.
باید دقت کرد که OpenAI و Anthropic چگونه فیلترهای امنیتی خود را برای وظایف کدنویسی تغییر میدهند. حرکت بعدی احتمالاً محدودیتهای شدیدتری بر انواع کدهای مرتبط با امنیت خواهد بود که این مدلها اجازه تولید آنها را دارند. با این حال، همانطور که پرونده Hacktron نشان داد، توانایی خودکارسازی «مایل آخر» یک هک اکنون به یک واقعیت تبدیل شده است.
گام بعدی شما
- بررسی مجدد دسترسیهای توکنهای کارکنان در سیستمهای متصل به AI.
- بهروزرسانی فوری کتابخانههای مدیریت تصویر و فایلهای ورودی در زیرساختهای حساس.
- استقرار فرآیندهای «تیم قرمز» برای تست نفوذ خودکار با استفاده از مدلهای استدلالی جدید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو