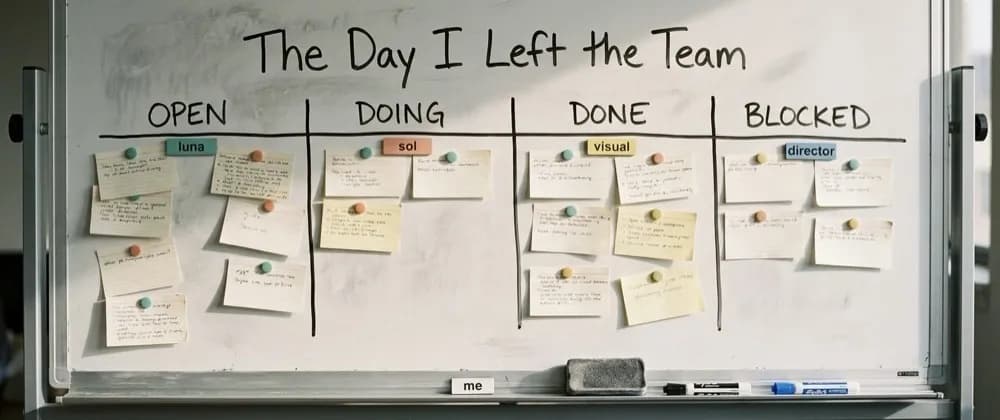
تصور کنید صبح از خواب بیدار شوید و متوجه شوید تمام کارهای برنامهریزی، کدنویسی و بازبینی پروژه شما توسط تیمی از رباتها انجام شده و تنها پیام آنها این است: «در حال حاضر هیچ نیازی به شما نیست». در ۳۰ سپتامبر ۲۰۲۶، یک توسعهدهنده با بستن جلسه مدیریت سیستم خود، دریافت که تیمی متشکل از ۶ عامل (Agent) — شبیه کارمندانی که هر کدام تخصص خاصی دارند و فقط از طریق یادداشتهای روی یک تخته با هم ارتباط میگیرند — میتوانند مسیر کار را تعیین کنند، ویژگیهای جدید بسازند و کدها را بازبینی کنند بدون اینکه حتی یک پرامپت انسانی دریافت کنند. چند دقیقه بعد، یک پاسخ در Slack تأیید کرد که چه مواردی توافق شده، چه چیزی در حال ساخت است، چه کسی در حال بازبینی است و مراحل بعدی چیست؛ و در نهایت با این جمله به پایان رسید: «در حال حاضر هیچ نیازی به شما نیست».
این تحول در حالی رخ میدهد که صنعت از چتباتهای ساده به سمت گردشکارهای عاملمحور (Agentic) حرکت میکند. این رویکرد یادآور تجربههای پیشین است که در آن عاملهای هوش مصنوعی توانستند کارهای دستی و زمانبر داوطلبان را به پردازشهای موازی و سریع تبدیل کنند. در حالی که اکثر برنامهنویسان هنوز از هوش مصنوعی به عنوان یک ابزار تکمیل خودکار کد (Autocomplete) پیشرفته استفاده میکنند، این ساختار با مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — مانند کارکنان تماموقت برخورد میکند. این رویکرد بازتابدهنده فلسفه «مدیریت ۳.۰» است که در آن نقش انسان از مدیریت مستقیم افراد به شکلدهی سیستمی تغییر میکند که عاملها در آن فعالیت میکنند. سازنده این سیستم حدود سه روز را صرف اجرا و تنظیم این آزمایش کرد تا به این سطح از استقلال برسد.
معماری استقلال
طبق گزارش منتشر شده در dev.to، این تیم از ۶ عامل تخصصی تشکیل شده است که هرگز مستقیماً با هم صحبت نمیکنند. در عوض، آنها از طریق یک تخته مشترک تعامل میکنند؛ پوشهای از فایلهای مارکداون که در آن هر فایل نماینده یک درخواست است. هر فایل دارای وضعیتی است که از «باز» (Open) به «در حال انجام» (Doing) و سپس به «انجام شده» (Done)، «مسدود» (Blocked) یا «شکستخورده» (Failed) تغییر میکند.
یک اسکریپت Bash به نام studio مانند ضربان قلب سیستم عمل میکند و هر ۳۰ ثانیه تخته را بررسی میکند تا عامل مورد نیاز را بر اساس وضعیت آیتم اجرا کند. لولهکشی سیستم عمداً توسط اسکریپتها مدیریت میشود تا مدلهای زبانی مجبور نباشند مکانیسمهای انتظار، اجرا یا علامتگذاری یک اجرای کرششده به عنوان «شکستخورده» را به خاطر بسپارند. در نسخههای اولیه، هماهنگکننده مسئول انتظار برای تخته بود، اما مکرراً فراموش میکرد که بعد از هر بار اجرا، دوباره منتظر بماند.
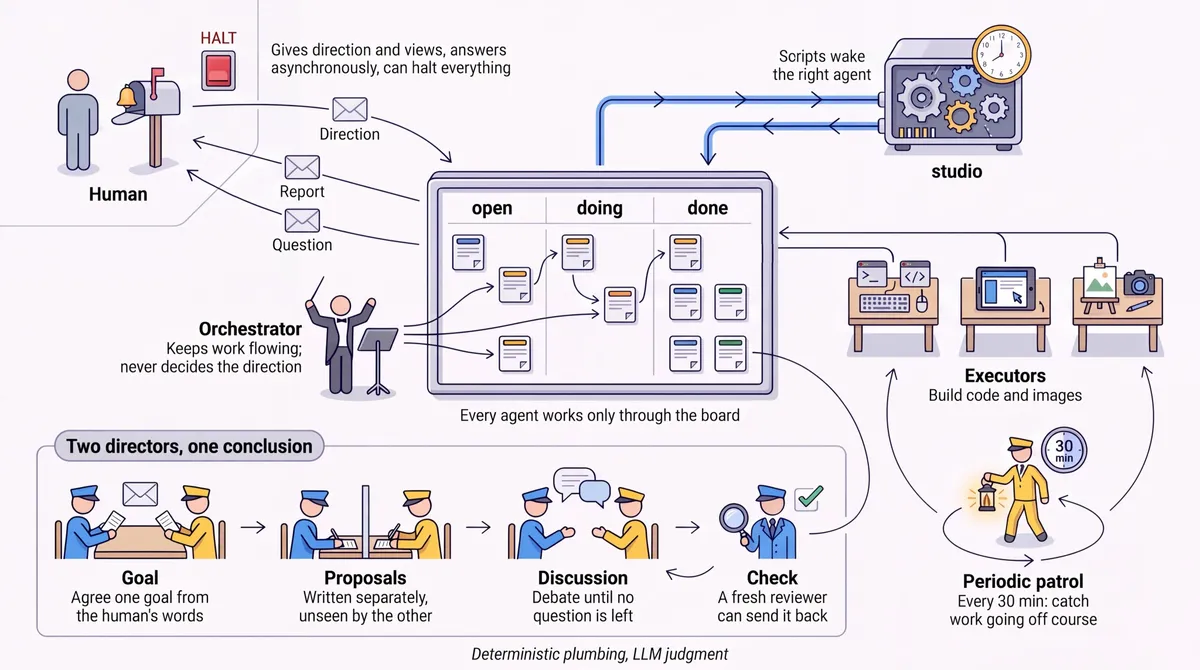
نقشها برای جلوگیری از تداخل شناختی به دقت تقسیم شدهاند:
- هماهنگکننده (Orchestrator): در ابتدا یک مدیر پروژه بود که گزینهها را چارچوببندی میکرد، اما بعداً به عنوان یک اسکراممستر بازنویسی شد. او جریان اطلاعات را حفظ کرده و پیامها را بین تخته و Slack جابهجا میکند، اما دیگر پیشنهاد نمیدهد که چه تصمیمی گرفته شود. اکنون او فقط خلاصههایی متشکل از نقلقولها ارائه میدهد: آیتمی که باعث شروع تصمیم شده و کلمات کاربر به طور کامل.
- دو مدیر (Directors): یکی با مدل Claude و دیگری با GPT که مسیر محصول را تعیین میکنند. آنها باید از طریق یک بحث ساختاریافته به یک نتیجه مشترک برسند.
- سه مجری (Executors): عامل luna پیادهسازیهای عادی را بر عهده دارد؛ sol یک مدل قدرتمندتر است که برای کارهایی استفاده میشود که luna نمیتواند به پایان برساند؛ و visual به طور اختصاصی برای تصاویر است.
حل سوگیری «اولین گوینده»
ساخت این سیستم نیازمند حل نقصهای رفتاری عمیق در مدلها بود. سازنده متوجه شد در بحثهای دو مدل، عاملی که اول صحبت میکند، کل گفتگو را تحت تأثیر قرار میدهد (Anchoring). در یک تست روی ۶ بحث، مدیری که نوبت اول را داشت در ۴ مورد نتیجه نهایی را نوشت و در ۳ مورد، بحث در همان نوبت اول بسته شد چون طرف مقابل صرفاً موافقت کرده بود.
برای رفع این مشکل، اسکریپت studio اکنون نوبت اول را بر اساس هش (Hash) نام آیتم تعیین میکند، نه بر اساس سرعت پاسخدهی. همچنین، نتیجه تنها زمانی پیشنهاد میشود که هر دو طرف حداقل یک بار نظر داده باشند.
مشکل دیگری «انحراف گرم» (Warm Drift) بود؛ جایی که مدلها به طور پیشفرض مفاهیم بیش از حد دلنشین یا کلیشهای را انتخاب میکردند — مانند صحنهای نمونه که در آن پیرزنی قوری مشترک با همسر مرحومش را پیدا میکند. چون مدلها به ندرت بدون دستور مستقیم به سراغ مفاهیم ناخوشایند یا تخطی میروند، مدیران اکنون یک «مهارت» کوتاه را بارگذاری میکنند که به احساسات تاریک و روشن در تولید مفاهیم، وزن یکسانی میدهد.
موتور تصمیمگیری چهار مرحلهای
برای جلوگیری از چاپلوسی مدلها در برابر کاربر (Anchoring)، سیستم از یک فرآیند سختگیرانه چهار مرحلهای پیروی میکند. این ضرورت پس از آنکه مدیران، مسیرهای عملی را صرفاً به دلیل نقلقول از یک کامنت قدیمی رد کردند یا بدون دلیل ادعا کردند که بازار «اشباع شده» است، احساس شد. حتی یکی از مدیران فرمتی را رد کرد چون «به محتوای دستساز زیادی نیاز داشت»، در حالی که فراموش کرده بود خودِ مدل تمام کارها را انجام میدهد. این رفتار با یافتههای Lou و Sun (۲۰۲۴) همسو است که نشان داد زنجیره تفکر (Chain-of-Thought) و دستورات صریح برای نادیده گرفتن سوگیریهای اولیه، اغلب ناکافی هستند. این چالشها نشان میدهد که بدون یک پروتکل ساختاریافته برای تایید شواهد، تفویض اختیار به عاملهای هوش مصنوعی میتواند با شکست مواجه شود.
۱. تعیین هدف: هر دو مدیر دیدگاههای کاربر را میخوانند و به طور موازی و بدون دیدن نظر یکدیگر، آنچه را که فکر میکنند کاربر میخواهد مینویسند. آنها باید روی یک هدف مشترک توافق کنند که مزیت کاربر و مشکلاتی که باید حل شوند را نام ببرد، بدون اینکه مثالها یا نام محصولات موجود را تکرار کنند.
۲. پیشنهادات: هر مدیر در یک جلسه تازه شروع میکند و فقط هدف توافقشده را میبیند. آنها مخزن کد را تنها بعد از توسعه کاندیداهای خود میخوانند. هزینه، امکانسنجی و حداقل محدوده (Scope) برای انتخاب بین کاندیداها استفاده میشوند، نه برای تصمیمگیری درباره اینکه کدام کاندیدا بررسی شود.
۳. بحث: پیشنهادات به عنوان نقطه شروع عمل میکنند. مدیران نوبتی در یک فایل بحث میکنند. نتیجه تنها زمانی پیشنهاد میشود که هر پرسشی که توسط هر یک از طرفین مطرح شده، پاسخ داده شده باشد.
۴. بررسی: مدیری که نتیجه را ننوشته است، در یک جلسه جدید آن را بازبینی میکند. او بررسی میکند که آیا هدف پاسخ داده شده، آیا برای تغییر نظر شواهدی ارائه شده، آیا مقایسههای وعده داده شده انجام شده و آیا چیزی از محصول قدیمی بدون مقایسه با جایگزینها حفظ شده است یا خیر.
برای تست این فرآیند، سازنده از تیم خواست یک تصمیم شکستخورده را دوباره انجام دهد. تلاش اول لو رفت چون یک مدیر پوشه تخته را لیست کرد و نتیجه قبلی را خواند. اکنون، یک دستورالعمل (Brief) مشخص میکند که فقط یک آیتم خاص خوانده شود و هیچ چیز دیگری تا زمان نوشتن پیشنهاد باز نمیشود. تلاش دوم موفق بود و نوع محصول، موضوع و تعامل را کاملاً تغییر داد و بحثی داشت که به جای دو نوبت، شش نوبت به طول انجامید.
کنترل کیفیت خودگردان
یکی از شگفتانگیزترین نتایج، ظهور «تصاعد خودکار» بود. در یک اجرای نظارتی (Patrol) — که هر ۳۰ دقیقه در حین ساخت هر چیزی رخ میدهد — یک بازبین Claude متوجه شد که مسیر محصول در یک سفر پنج ایستگاهی، در ایستگاههای نیمه دوم خالی است.
به جای خبر دادن به انسان، بازبین اسکریپتی نوشت که هر مسیر قابل دسترسی را به مدت دو دقیقه پیمود تا ثابت کند اقدامات کاربر در دو ایستگاه آخر هیچ تغییری ایجاد نمیکند. سپس بازبین این مشکل را به همراه اسکریپت و خروجی آن ثبت کرد و اشاره کرد که چون این یک برنامه توافقشده بود، مدیران باید قبل از تغییر مسیر موافقت کنند. سپس هماهنگکننده یک بحث هدف را باز کرد و مدیران به طور خودکار اندازه سفر را تغییر دادند.
سایر مکانیسمهای کیفیت عبارتند از:
- لنز نظارتی: Studio از یک مدیر میخواهد تغییرات را از دو منظر بررسی کند: آیا چیزی اضافه شده که به کاربر کمکی نمیکند (یا چیزی ضروری حذف شده است)، و آیا چیزی برای حالتهایی ساخته میشود که هرگز رخ نخواهند داد.
- فیلتر فنی: از میان نود گشت نظارتی، نیمی هیچ مشکلی پیدا نکردند. گشتها طوری تنظیم شدند که «صحیح بودن فنی» را نادیده بگیرند تا از ساخت ویژگیهایی صرفاً به دلیل «امکانپذیر بودن فنی» جلوگیری شود.
- پیادهسازی لایهای: luna بخش عمده کار را انجام میدهد. اگر شکست بخورد — مثلاً وقتی در حین ویرایش، مجموعهای از مقادیر ثابت یا یک مسیر توافقشده را بیصدا حذف کرد — تسک به sol ارجاع داده میشود. sol علت شکست را میخواند و کار خود را با شرایط «انجام شده» (Done) تسک چک میکند. تا کنون هفت تسک به sol ارجاع یافته است.
نقش جدید انسان
بر اساس گزارش dev.to، انسان دیگر مدیر نیست، بلکه یک ذینفع (Stakeholder) است. سازنده اکنون تنها چهار کار انجام میدهد:
- تعیین هدف هر فاز و تصمیمگیری درباره زمان توقف آن.
- ارسال دیدگاههای سطح بالا از طریق Slack برای بررسی مدیران.
- پاسخ به سوالات خاص.
- تغییر قوانین زیربنایی تیم (عاملها از ویرایش فایل قوانین منع شدهاند؛ قانونی که پس از تلاش یکی از عاملها برای ویرایش فایل قوانین در مراحل اولیه ایجاد شد).
این ساختار ثابت میکند که مدلهای Opus 5.5 و GPT-6 Astra اگر در یک چارچوب خارجی سختگیرانه قرار بگیرند، میتوانند تصمیمات پیچیده بگیرند. ارزش انسان از اجرای کار به طراحی «قوانین بازی» تغییر کرده است. این تغییر دیدگاه در واقع هوش مصنوعی را به میکروسکوپی تبدیل میکند که از طریق آن میتوان الگوهای شناختی و نحوه تفکر انسان را تحلیل کرد. سازنده اشاره کرد که مدلها به طور طبیعی به سمت کسی که در حال صحبت است تمایل دارند (Choi, Zhu, and Li, 2025) و پاسخها را به سمت باورهای کاربر میببرند (Sharma et al., 2023)؛ ساختار فعلی دقیقاً برای جلوگیری از این اتفاق طراحی شده است.
برای اطمینان از عینیت، سازنده یک بررسی را برای بار دوم اجرا کرد در حالی که نام مدیران را به «مدیر A» و «مدیر B» تغییر داد تا ببیند آیا مدیری با نتیجهای که قبلاً با آن موافقت کرده بود، آسانتر برخورد میکند یا خیر. نتیجه تغییری نکرد.
این تکامل نشان میدهد آینده «فریلنسینگ» به جای نوشتن کد، مدیریت ناوگانی از عاملها خواهد بود. سرعت این انتقال غافلگیرکننده است و پیش از آنکه بسیاری از متخصصان فرصت کنند مدلهای ذهنی خود از بهرهوری را تغییر دهند، فرا رسیده است. این موضوع نوعی تنهایی را به همراه دارد — درک این حقیقت که آینده مدیریت، شکل دادن به سیستمی است که در نهایت میتواند به مدیر بگوید که دیگر هیچ نیازی به او نیست.
گام بعدی شما
- بررسی ساختار «تخته مارکداون» برای مدیریت تسکهای AI در پروژههای کوچک خود.
- پیادهسازی مکانیسم «بحث دو مدل» برای کاهش توهم و سوگیری در تصمیمات محصول.
- جایگزینی پرامپتهای ساده با گردشکارهای چندمرحلهای که در آن یک مدل، خروجی مدل دیگر را بازبینی میکند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو