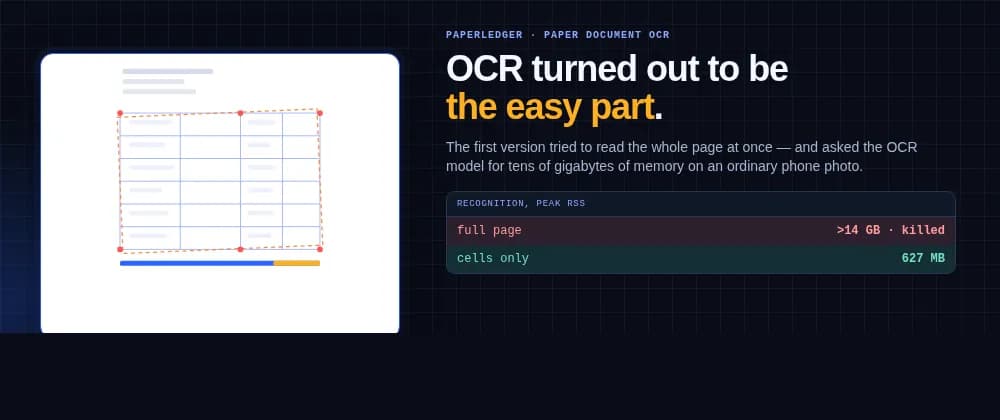
تصور کنید برای خواندن یک عکس ۵ مگابایتی از یک فاکتور، سیستم شما ۴۴ گیگابایت رم درخواست کند و سپس با خطای کمبود منابع کاملاً متوقف شود. این کابوس فنی دقیقاً همان چیزی بود که در توسعه PaperLedger رخ داد؛ ابزاری برای استخراج خودکار نرخهای مالیات بر ارزش افزوده (VAT) از فرمهای استاندارد فاکتورهای روسی.
بسیاری از گردشکارهای مدرن نویسهخوانی نوری (OCR) — شبیه به کسی که سعی میکند تمام صفحات یک کتاب را همزمان در ذهن نگه دارد تا یک کلمه را پیدا کند — بر شبکههای عصبی سنگین متکی هستند که چیدمان و متن را همزمان شناسایی میکنند. طبق گزارشهای فنی این پروژه، این رویکرد باعث میشود با افزایش رزولوشن تصویر، مصرف حافظه بهصورت نمایی رشد کند. همانطور که در تحلیلهای قبلی ما درباره بهینهسازی مدلهای بینایی اشاره کردیم، عدم تطبیق مدل با هندسه سند منجر به شکست عملیاتی میشود. این چالشها در مقایسه با مدلهای بینایی جدیدتر که سعی دارند استخراج سند را سادهتر کنند، نشاندهنده اهمیت تفکیک لایههای پردازش در سیستمهای سنتی است.
در معماری اولیه، از PaddleOCR برای شناسایی جدول و استخراج متن استفاده شده بود. طبق مستندات پروژه، سیستم ابتدا پیشپردازش OpenCV را اجرا میکرد و سپس دو بار کل صفحه را میخواند: یک بار برای ساختار جدول و بار دیگر برای متن. توسعهدهنده ابتدا تصور کرد کاهش اندازه تصویر مشکل را حل میکند و ضلع بلندتر را به ۲۶۰۰ پیکسل محدود کرد، اما باز هم در اسناد واقعی، سیستم کرش میکرد.
برای عیبیابی، آزمایشهایی با محدودیت سختگیرانه حافظه اجرا شد. در یک مورد، تصویری با ابعاد ۱۴۶۲ در ۲۶۰۰ پیکسل باعث شد مصرف حافظه بلافاصله از ۱۴ گیگابایت فراتر رود و سیستم توسط سیستمعامل متوقف شود. ریشه مشکل در افزونگی بود؛ چندین مدل سنگین همزمان کل صفحه را پردازش میکردند و حافظه عظیمی را صرف تحلیل فضاهای سفید و خالی میکردند تا فقط سه ستون داده را پیدا کنند.
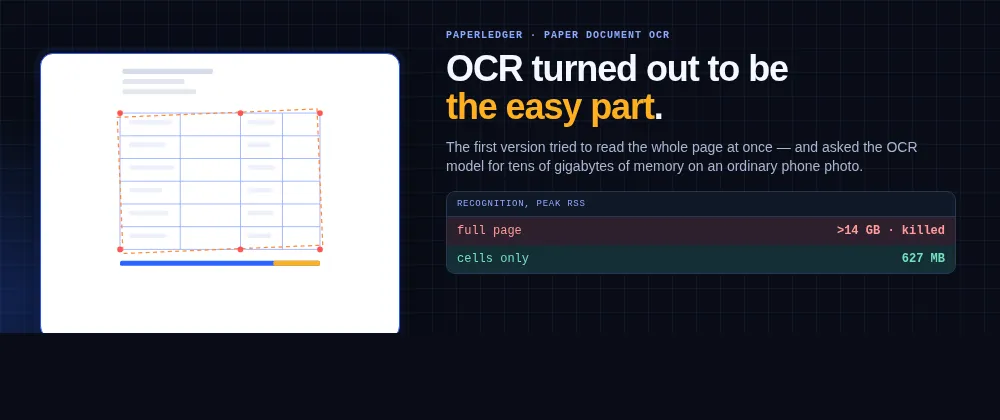
برای حل این بحران، یک خط لوله «درشت به ریز» پیادهسازی شد. به جای دادن کل صفحه به شبکه عصبی (Neural Network) — که شبیه نقشه مترویی است که سیگنال را از ورودی به جواب میرساند — سیستم اکنون این مراحل را طی میکند:
- هندسه کمکیفیت: استفاده از یک کپی کوچک از تصویر برای یافتن مختصات فیزیکی جدول.
- همراستاسازی شبکه: استفاده از تشخیصدهنده قطعات خط (LSD) برای یافتن شبکه واقعی جدول به جای لبههای کاغذ.
- برش هدفمند: برش سلولهای کوچک و دقیق از تصویر اصلی با رزولوشن بالا.
- شناسایی مجزا: مدل OCR فقط این تکههای کوچک را پردازش میکند و هرگز با کل صفحه مواجه نمیشود.
این تغییر استراتژیک، اوج مصرف حافظه را از ۴۴ گیگابایت به حدود ۶۲۷ مگابایت کاهش داد.
یکی از چالشهای اصلی، مشکل «شیء مرجع» بود. در ابتدا لبه کاغذ به عنوان مرجع استفاده میشد، اما چون لبه کاغذ همیشه موازی با جدول چاپشده نیست، خطاهای شدیدی رخ میداد. توسعهدهنده با الهام از یک پروژه شناسایی سودوکو، مرجع را از لبه کاغذ به خودِ شبکه جدول تغییر داد. نتایج نشان داد که همراستاسازی بر اساس شبکه جدول، خطای مکانیابی را به ۰.۲۶ پیکسل رساند، در حالی که همراستاسازی بر اساس لبه کاغذ حتی از «هیچ کاری نکردن» بدتر بود.
پس از تثبیت حافظه، تمرکز روی دقت شد. یک خطای تکپیکسلی در کپی کوچک میتوانست باعث حذف یک رقم در تصویر اصلی شود. برای حل این موضوع، یک پنجره جستوجوی ۱۰ پیکسلی در تصویر اصلی اضافه شد تا خطوط چاپشده دقیقاً پیدا شوند. این کار نرخ برشهای ناقص را از ۶۷ مورد به ۳ مورد در ۸۴ تصویر کاهش داد.
سایر یافتههای کلیدی عبارت بودند از:
- باینریسازی: این مرحله برای هندسه مفید بود اما دقت شناسایی را کاهش داد؛ مدل با تصاویر خاکستری بهتر عمل میکرد.
- سلول در برابر نوار: خواندن سلولهای مجزا ترجیح داده شد تا خطای یک سلول، تحلیل سلولهای همسایه را خراب نکند.
- ردیفهای بلند: برای سلولهای بلند، برش دقیق دور اجزای متصلِ جوهر، دقت را از ۷۶ به ۸۲ مورد در ۸۳ سند افزایش داد.
همچنین محدودیتهای دامنه به رمزگشای مدل اضافه شد. برای مثال، در فیلدهای نرخ مالیات، فقط اعداد و علامت درصد مجاز بودند. از آنجا که نرخهای قانونی مالیات محدود هستند (مثلاً ۰٪، ۵٪، ۲۰٪)، سیستم احتمال هر گزینه قانونی را محاسبه کرده و محتملترین را انتخاب میکند. این کار باعث شد خطای خواندن «۱۰٪» به جای «۱۹٪» کاملاً برطرف شود.
در مواجهه با اسناد واقعی مانند یادداشتهای تحویل TORG-12 که دارای خمیدگی کاغذ بودند، سیستم با استفاده از یک شبکه ۳ در ۳ از مناطق مختلف صفحه، جهت درست سند را با دقت ۱۰۰٪ تشخیص داد. همچنین برای جلوگیری از «ردیفهای شبح» (جایی که خمیدگی کاغذ باعث ادغام دو ردیف میشود)، جستوجوی مرز ردیفها فقط در نوارهای عمودی ستونهای مورد نیاز انجام شد.
در نهایت با استفاده از مدل en_PP-OCRv3_mobile_rec و شتابدهنده MKL-DNN، تأخیر شناسایی هر سلول از ۱۵۵ میلیثانیه به ۴۴ میلیثانیه کاهش یافت. زمان کل پردازش هر سند بین ۲.۸۱ تا ۳.۱۹ ثانیه قرار گرفت و سیستم توانست ۱۳۵ از ۱۳۵ مقدار برچسبگذاری شده را بهدرستی استخراج کند.
گام بعدی شما
- اگر با مدلهای OCR سنگین در محیطهای با رم محدود مشکل دارید، ابتدا یک لایه هندسی ساده برای برش (Crop) نواحی مورد نیاز پیاده کنید.
- برای افزایش دقت در اسناد اداری، از «لیست سفید» (Whitelist) کاراکترها و دیکشنریهای احتمالی برای اصلاح خروجی مدل استفاده کنید.
- به جای تکیه بر لبههای سند برای همراستاسازی، از خطوط داخلی و شبکههای جدول به عنوان مرجع هندسی استفاده کنید.
اما بهینهسازیهای سختافزاری برای استقرار این مدلها در لبه (Edge) حتی جذابتر است — به تحلیل ما درباره رایانش لبه مراجعه کنید.



گفتگو