اگر امروز برای استخراج داده از فاکتورها یا رسیدها به اپراتورهای انسانی یا APIهای گرانقیمت متکی هستید، هزینههای شما قرار است به کسری از یک سنت برسد. Qwen3-VL 8B، مدل جدید علیبابا کلاد (Alibaba Cloud)، استدلال بصری با دقت بالا را از مراکز داده عظیم به اندازهای منتقل کرده است که روی یک کارت گرافیک تک-ایستگاه کاری (Workstation GPU) جای میگیرد. این مدل استانداردهای اتوماسیون اسناد را تغییر داده است.
برای یک دهه، کسبوکارها مجبور بودند بین اسکریپتهای شکننده نویسهخوانی نوری (OCR) — که شبیه به کسی است که حروف را میبیند اما معنای سند را نمیفهمد — و ورود دستی دادهها یکی را انتخاب کنند؛ زیرا مدلهای بینایی به توان پردازشی در مقیاس مراکز داده نیاز داشتند. در هر پشته تکنولوژی مدرنی، شغلی وجود دارد که در آن یک انسان باید به یک تصویر — مانند رسید، عکس انبار یا یک رگرسیون رابط کاربری (UI) — نگاه کند و آنچه را میبیند در یک فرم تایپ کند. همانطور که در تحلیل قبلی ما دربارهی Speko و گذار به سمت پشتههای هوش مصنوعی تخصصی اشاره کردیم، ظهور مدلهای بینایی-زبانی (VLM) کوچک اما توانمند، نقش «انسان در حلقه» برای خواندن رسیدها را به یک گزینه اختیاری تبدیل میکند.
به نقل از یک بررسی فنی منتشر شده در ۵ سپتامبر ۲۰۲۶، این مدل از طریق هاگینگ فیس (Hugging Face) با نام Qwen/Qwen3-VL-8B-Instruct در دسترس است. این ابزار صرفاً یک طبقهبندیکننده تصویر ساده نیست، بلکه یک موتور استدلالی است که چیدمان صفحه را میخواند و متن ساختاریافته تولید میکند. مدل ورودیهای متنی و تصویری را بهطور همزمان دریافت کرده و در قالب متن پاسخ میدهد؛ این قابلیت به مدل اجازه میدهد بهجای تشخیص ساده اشیا، درباره ساختار سند استدلال کرده و خروجیهای ساختاریافته بنویسد.
مشخصات فنی و قیمتگذاری
مهمترین ویژگی این مدل، پنجره زمینه (Context Window) — که مثل میز کاری است که جا برای صدها صفحه سند دارد، نه فقط یک ورق — با ظرفیت ۲۶۲,۱۴۴ توکن است. این ظرفیت به کاربران اجازه میدهد دهها صفحه اسکنشده یا توالی بلندی از اسکرینشاتهای رابط کاربری را بدون نیاز به تکهبندی (Chunking) دادهها، در یک درخواست واحد ارسال کنند. عدد ربع میلیون توکن، یک رقم کلیدی است که پردازش کل تستهای نرمافزاری یا اسناد چندصفحهای را در یک مرحله ممکن میسازد.
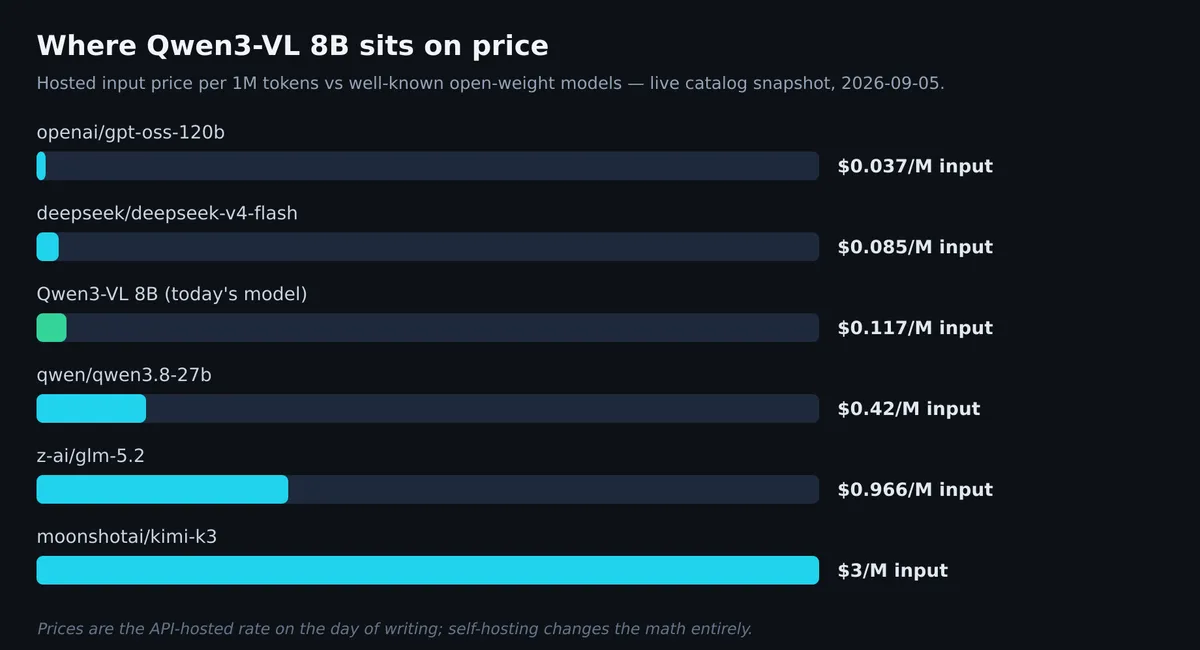
برای کاربرانی که از نقاط انتهایی میزبانیشده از طریق اوپنروتر (OpenRouter) استفاده میکنند، قیمتها بهشدت رقابتی و پایین است:
- توکنهای ورودی: ۰.۱۱۷ دلار بهازای هر میلیون توکن
- توکنهای خروجی: ۰.۴۵۵ دلار بهازای هر میلیون توکن
بررسی عملکرد در دنیای واقعی
تستهای زنده نشان میدهد این مدل در استخراج ساختاریافته عالی است اما با چالشهای زیرساختی روبروست. سه بررسی سریع روی نقطه انتهایی (Endpoint) زنده اجرا شد تا به عنوان یک «تست اولیه» (Smell Test) برای سنجش تواناییهای مدل عمل کند. این تستها روی سختافزارهای مسیریابیشدهای انجام شد که توسط تستکننده کنترل نمیشدند تا تصویری واقعی از تجربه استفاده از API ارائه دهند.
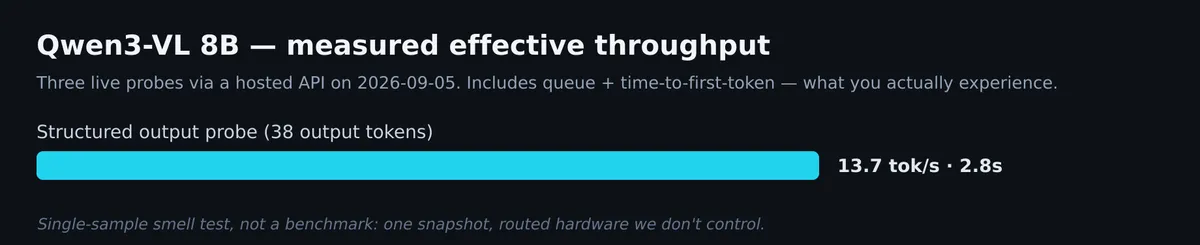
در یک آزمون موفق روی یک فاکتور، از مدل خواسته شد تا نام فروشنده، تاریخ و مبلغ کل را دقیقاً در قالب JSON استخراج کند. نتایج به شرح زیر بود:
- زمان کل (Wall-clock time): ۲.۸ ثانیه از ابتدا تا انتها
- توکنهای خروجی: ۳۸ توکن
- سرعت مؤثر: ۱۳.۷ توکن در ثانیه
- صحت: مدل یک JSON معتبر بدون هیچ مقدمه، علامتهای Markdown یا توضیحات اضافی برگرداند. مدل بهدرستی «مبلغ قابل پرداخت» (۴۴۵.۵۰ دلار) را شناسایی کرد و خطوط مربوط به مبالغ جزئی و مالیات را نادیده گرفت؛ موردی که معمولاً نقطه شکست در خط لولههای سادهتر است.
با این حال، این بررسیها مشکلات پایداری را نیز آشکار کرد. دو مورد از سه تسک — یک مسئله کدنویسی (ادغام بازههای همپوشان) و یک مسئله استدلالی ریاضی (مسئله پر و تخلیه پمپ) — با خطای HTTP 429 (محدودیت نرخ درخواست) مواجه شدند. این خطاها به ترتیب در ۰.۵ و ۰.۱ ثانیه رخ دادند، که نشان میدهد اینها درخواستهای رد شده از سمت ارائهدهنده بالادستی بودهاند و نه کندی خود مدل.
اینها سیگنالهای زیرساختی هستند، نه سیگنالهای مربوط به کیفیت مدل، اما به ما میگویند کاربرانی که حجم داده بالایی دارند باید میزبانی شخصی (Self-hosting) را اولویت دهند یا بودجهای برای تلاشهای مجدد (Retries) در نظر بگیرند. مدلی که هزینه توکن پایینی دارد، اگر در بازههای زمانی بحرانی برای پردازش دستهای دادهها در دسترس نباشد، عملاً رایگان نیست.
کاربردهای عملیاتی با اثر بالا
یک مدل ۸ میلیاردی با جایگزینی کارهای بصری «کمجذاب» سودآور میشود. این مدل با غولهای چندوجهی پیشرو در استدلالهای بصری پیچیده رقابت نمیکند، بلکه جایگزین خط لولههای «OCR بهعلاوه Regex» و تیمهای برونسپاری ورود داده میشود.
اتوماسیون اسناد
- خط لولههای رسید و فاکتور: وظیفه اصلی، تبدیل یک عکس یا PDF به JSON تایپشده است. با هزینه ۰.۱۱۷ دلار بهازای هر میلیون توکن ورودی، هزینه نهایی ناچیز است؛ و اگر مدل بهصورت محلی اجرا شود، هزینه تنها به برق مصرفی کاهش مییابد.
- اتوماسیون هزینهها: توانایی تشخیص قابل اعتماد «مبلغ قابل پرداخت» در مقابل «جمع جزئی»، سختترین بخش اتوماسیون هزینههاست. این دقیقاً همان «کار واقعی» است که یک مدل ۸ میلیاردی اکنون میتواند مدیریت کند.
کاربردهای صنعتی
- بازرسی کف کارخانه: مدل میتواند روی یک GPU تک-ایستگاه کاری مستقر شود تا فیدهای دوربین را تحلیل کند. مدل میتواند به سوالاتی مانند «آیا این قطعه نقص ظاهری دارد و در کجا قرار دارد» پاسخ دهد، بدون اینکه نیاز به یک رفتوبرگشت شبکهای به APIهای ابری باشد.
- محیطهای ایزوله (Air-Gapped): این قابلیت برای کارخانههای تولیدی که هیچ دسترسی به اینترنت ندارند و تمایلی هم به آن ندارند، حیاتی است و اجازه میدهد استنتاج (Inference) محلی جایگزین بینایی وابسته به ابر شود.
تضمین کیفیت نرمافزار
- تست UI و تریاژ: توسعهدهندگان میتوانند اسکرینشاتهای قبل و بعد از تغییرات یک اپلیکیشن وب را برای شناسایی رگرسیونهای بصری به مدل بدهند.
- تحلیل زمینهای: پنجره متنی ۲۶۲ هزار توکنی اجازه میدهد تمام اسکرینشاتها و لاگهای یک اجرای تست بهطور یکجا تحلیل شوند. این موضوع زمانی حیاتی است که یک باگ در تعامل بین دو صفحه مختلف وجود دارد، نه در یک تصویر واحد.
دسترسیپذیری و حریم خصوصی
- ابزارهای حریمخصوصیمحور: مدل میتواند تصاویر را توصیف کند، چیدمانهای متراکم UI را با صدای بلند بخواند یا فرمهای اسکنشده را برای صفحهخوانها تبدیل کند.
- مدیریت دادههای حساس: اجرای محلی مانع از ارسال فرمهای پزشکی حساس، مدارک شناسایی یا صورتحسابهای مالی به APIهای شخص ثالث میشود، که این یک محدودیت اصلی برای نرمافزارهای دسترسیپذیری است.
موازنه مقیاس و محدودیتها
اندازه کوچک مدل، محدودیتهایی هم به همراه دارد. در حالی که مدل فاکتورهای تمیز را بهخوبی پردازش میکند، ممکن است با اسناد متراکم و شلوغ دچار مشکل شود. نمونههایی از این دست شامل اسکرینشات یک صفحه گسترده (Spreadsheet) با ۵۰ ردیف یا یک قفسه انبار حاوی ۱۰۰ کالای مختلف (SKU) است. در این سناریوها، یک VLM ۸ میلیاردی بیشتر احتمال دارد فیلدهایی را که یک مدل بزرگتر میدید، حذف کند یا اشتباه بخواند. برای بهینهسازی این مدلها در محیطهای محدود، استفاده از روشهای کوانتش ترکیبی برای حفظ جزئیات تصویر راهکاری کلیدی برای کاهش افت دقت در مدلهای کوچک است.
این ورودیهای پیچیده بهجای اعتماد کورکورانه به JSON، نیازمند منطق اعتبارسنجی در مراحل بعدی (Downstream Validation) هستند. تست موفقی که ما انجام دادیم، یک فاکتور تکصفحه و تمیز با سه فیلد بود که نشاندهنده سادهترین نقطه از منحنی دشواری است.
دینامیک هزینهها نیز با طول خروجی تغییر میکند. از آنجایی که توکنهای تکمیل (Completion) تقریباً ۴ برابر گرانتر از توکنهای پرامپت هستند (۰.۴۵۵ در مقابل ۰.۱۱۷ دلار)، توصیفات طولانی در مقایسه با خروجیهای کوتاه JSON، هزینهها را بهطور قابل توجهی افزایش میدهند. علاوه بر این، ورودیهای تصویری توکنها را بهسرعت مصرف میکنند، به این معنی که پنجره زمینه بزرگ سریعتر از پرامپتهای متنی پر میشود.
این مدل با غولهای چندوجهی در زمینههای فلسفه یا هنر بصری پیچیده رقابت نمیکند؛ بلکه با تیمهای برونسپاری ورود داده و اسکریپتهای Regex رقابت میکند. اگر گلوگاه شما انسانی است که تصاویر را میخواند و دادههای ساختاریافته را تایپ میکند، یک VLM ۸ میلیاردی با وزنهای باز ارزش یک پروژه آزمایشی را دارد، زیرا بهاندازه کافی کوچک است که بهصورت محلی میزبانی شود و بهاندازه کافی ارزان است که در حجم بالا اجرا شود. مدل را بر اساس اسناد واقعی خودتان قضاوت کنید، نه بر اساس یک فاکتور تمیز؛ اما آن یک تست تمیزی که ما اجرا کردیم، دقیقاً همان کاری را که از آن خواسته شده بود انجام داد: خروجی JSON معتبر و انتخاب عدد درست از بین سه گزینه.
گام بعدی شما
- اگر از OCRهای سنتی استفاده میکنید، یک نمونه از سختترین اسناد خود را در مدل Qwen3-VL 8B تست کنید تا نرخ خطای آن را بسنجید.
- برای کاهش هزینهها و افزایش امنیت، استقرار مدل را بهصورت محلی روی GPUهای سری RTX 3090 یا 4090 بررسی کنید.
- خروجیهای مدل را با یک لایه اعتبارسنجی (Validation) ساده ترکیب کنید تا خطاهای احتمالی در اسناد شلوغ را بگیرید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو