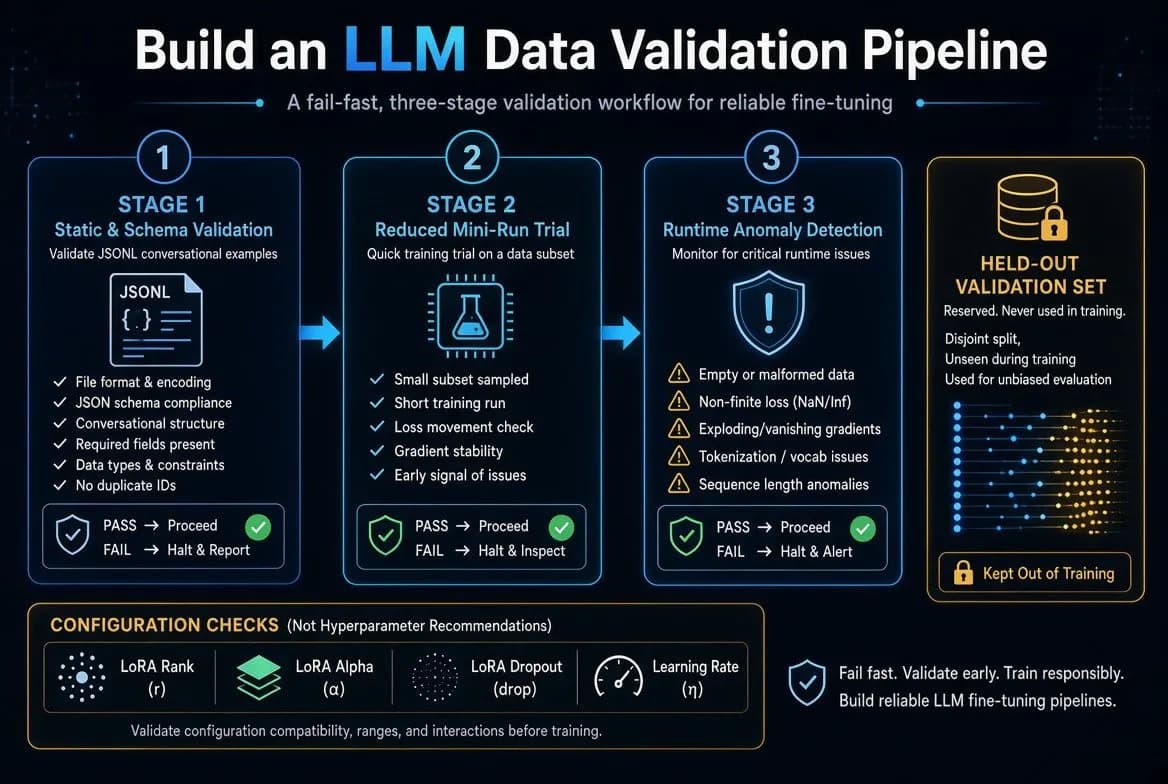
تصور کنید هزاران دلار هزینه پردازش ابری پرداخت کردهاید، اما یک خط اشتباه در فرمت JSON باعث میشود کل فرآیند آموزش مدل شما پس از چندین ساعت با خطا متوقف شود. برای جلوگیری از این کابوس مالی، Gate of AI راهنمای فنی جدیدی را منتشر کرده است که یک خط لولهی اعتبارسنجی «سریع-شکست» (Fail-Fast) را در سه مرحله برای رد کردن پیکربندیهای معیوب پیش از مصرف منابع GPU معرفی میکند. این آموزش بخشی از یک سری عمیق درباره «جریانهای کاری عاملمحور» (Agentic Workflows) در Gate of AI است که بر ساخت یک خط لوله اعتبارسنجی دادهها برای تنظیم دقیق مدلهای زبانی بزرگ (LLM) در سطح متوسط تمرکز دارد.
تنظیم دقیق (Fine-tuning) — که شبیه وقتی است که به یک پزشک عمومی، تخصص پوست میدهیم تا روی یک حوزه دقیق شود — در محیطهای عملیاتی دیگر یک دستور ساده نیست، بلکه یک خط لولهی پیچیده است و نباید به عنوان یک فرمان واحد در نظر گرفته شود. برای درک عمیقتر از زیرساختهای این مدلها، کالبدشکافی سازوکار مدلهای زبانی بزرگ دیدگاهی جامع درباره نحوه عملکرد این سیستمها ارائه میدهد. طبق اعلام Gate of AI، پیش از شروع محاسبات سنگین، تیمها باید سه مورد را تضمین کنند: صحت نحوی پیکربندی، ساختار مورد انتظار دادهها و توانایی مدل برای تکمیل یک اجرای کوتاه بدون شکستهای بدیهی. همانطور که در تحلیل قبلی ما دربارهی MLX و توانایی آن در تنظیم دقیق مدلهای ۳ میلیارد پارامتری در چند ثانیه اشاره کردیم، صنعت اکنون به سمت بررسیهای پیشپرواز (Pre-flight) سختگیرانهتر حرکت میکند. برای اکثر توسعهدهندگان، هزینه یک اجرای شکستخورده تنها صورتحساب ابری نیست، بلکه زمان از دست رفته برای عیبیابی دادههایی است که از همان ابتدا از نظر نحوی اشتباه بودهاند.
مکانیزم اعتبارسنجی پیشرونده
فلسفه اصلی این روش که بر اساس پژوهشهای FT-Dojo طراحی شده، اعتبارسنجی پیشرونده است. به این معنا که ابتدا ارزانترین بررسیها و سپس بررسیهای گرانتر اجرا میشوند. پیکربندیهایی که در هر مرحله شکست بخورند، بلافاصله رد میشوند تا منابع در یک اجرای کامل هدر نرود. این متد نسخهای مستقل از ارائهدهندگان است که مجموعهدادههای JSON Lines (JSONL) را بررسی کرده و ناهنجاریهای زمان اجرا را بدون ارسال داده به APIهای تجاری گزارش میکند.
مرحله اول، اعتبارسنجی استاتیک و طرحواره (Schema) است. این فرآیند تضمین میکند که مسیر ورودی وجود دارد و هر خط غیرخالی، یک JSON معتبر است. در این مرحله یک «قرارداد مجموعهداده» اجرا میشود: هر نمونه باید شامل یک آرایه پیامها با حداقل دو شیء باشد. هر پیام باید دارای یک نقش پشتیبانیشده (سیستمی، کاربر یا دستیار) و محتوای متنی غیرخالی باشد. نکته حیاتی این است که آخرین پیام حتماً باید پاسخ دستیار باشد. این رویکرد برای مقابله با خطاهای ساختاری است، مشابه آنچه در پشتهٔ چهارلایه برای حذف خطاهای JSON برای افزایش قابلیت اطمینان خروجیها بررسی شده است.
علاوه بر دادهها، این خط لوله ابرپارامترها (Hyperparameter) را نیز اعتبارسنجی میکند. مقادیر مربوط به رتبه لورا (LoRA)، آلفای مقیاسبندی، نرخ یادگیری (Learning Rate) و اندازه دسته (Batch Size) باید اعداد مثبت باشند. همچنین مقدار دراپاوت (Dropout) باید حداقل ۰ و کمتر از ۱ باشد. این بررسیها مانع از کرش کردن مدل به دلیل خطاهای نوع داده یا مقادیر ریاضی غیرممکن میشود. این اسکریپت تنها شکل فیلدها را تایید میکند و ادعایی درباره بهینه بودن مقادیر ندارد، زیرا پاسخ مهندسی درست، اعتبارسنجی هر پیکربندی کاندید و مقایسه آنها روی یک مجموعه اعتبارسنجی یکسان است.
پیشنیازهای فنی و راهاندازی
برای پیادهسازی این خط لوله، محیط زیر مورد نیاز است:
- پایتون ۳.۱۰ یا نسخههای جدیدتر.
- یک مجموعهداده JSONL شامل نمونههای گفتگو.
- یک مجموعه اعتبارسنجی (Validation Set) مجزا که با نمونههای آموزشی همپوشانی نداشته باشد.
- دانش پایه از JSON، اجرای خط فرمان و محیطهای مجازی پایتون.
این ابزار اعتبارسنجی بهگونهای طراحی شده است که تنها از کتابخانه استاندارد پایتون استفاده کند. این امر باعث میشود مرحله «سریع-شکست» پیش از نصب کل پشتهی آموزشی به راحتی اجرا شود. برای فاز آموزش واقعی، استفاده از Hugging Face Transformers API توصیه میشود، زیرا در مطالعهی تاییدشدهی ابرپارامترها از همین API برای مدیریت مدل، آموزش و اعتبارسنجی استفاده شده است.
پیادهسازی اجرای کوچک (Mini-Run)
پس از عبور از بررسیهای استاتیک، خط لوله یک «اجرای کوچک» را اجرا میکند. این یک آزمایش کوتاه روی نمونه کوچکی از دادهها (بهطور پیشفرض ۸ رکورد) است تا ناهنجاریهای زمان اجرا که تحلیل استاتیک قادر به شناسایی آنها نیست، کشف شوند. این مرحله مستقل از ارائهدهنده است و دادهای به APIهای تجاری ارسال نمیکند؛ این مرز به این دلیل حفظ شده است که فرمتهای خاص هر ارائهدهنده و صلاحیت مدلها خارج از محدوده این بررسی تاییدشده است.
بررسیهای کلیدی زمان اجرا عبارتند از:
- تشخیص مجموعهداده خالی: شناسایی دادههای خالی که در غیر این صورت منجر به یک حلقه آموزش تهی (Null Training Loop) میشوند.
- تایید محتوا: شناسایی نمونههایی که محتوای تولیدشده آنها صفر کاراکتر است (مجموع کاراکترها = ۰).
- پایداری تابع زیان: نظارت بر مقادیر غیرمتناهی تابع زیان (Loss Function) مانند NaN یا Infinity که نشانه انفجار گرادیان است.
این مرحله به عنوان آخرین دروازه عمل میکند. اگر اجرای کوچک شکست بخورد، سیستم یک خطای SystemExit(1) صادر کرده و فرآیند را پیش از رسیدن به خوشه GPU یا APIهای تجاری متوقف میکند. موفقیت در این مرحله به معنای عملکرد خوب مدل نیست، بلکه تنها نشان میدهد دادهها و پیکربندی از بررسیهای ساختاری ارزانقیمت و اجرای کوتاه عبور کردهاند.
مدیریت لورا و تعمیمپذیری
برای تنظیم کارآمد با پارامتر اندک، این راهنما بر استفاده از لورا (LoRA) تاکید میکند. لورا اکثر وزنهای پیشآموزشدیده را منجمد نگه میدارد و یک تجزیه کمرتبه (Low-rank decomposition) را معرفی میکند که به جای وزنهای اصلی، آموزش میبیند. مطالعهی ابرپارامترها نشان میدهد رتبه لورا، آلفای مقیاسبندی، دراپاوت و نرخ یادگیری مهمترین متغیرهای اثرگذار بر عملکرد نهایی در مراحل بعدی هستند.
برای اندازهگیری اینکه مدل واقعاً یاد میگیرد یا صرفاً دادهها را حفظ میکند، خط لوله تفکیک سختگیرانه بین مجموعهداده آموزشی و اعتبارسنجی را الزامی میکند. زیان (Loss) روی نمونههای آموزشی کمینه میشود و سپس روی دادههایی که در بهروزرسانی پارامترهای قابل آموزش شرکت نداشتند، محاسبه میگردد. این تفکیک شواهدی از تعمیمپذیری (Generalization) ارائه میدهد، نه اینکه مدل صرفاً نمونههای دیده شده را بازتولید کند.
بر اساس گزارش Gate of AI، تغییر نمونههای اعتبارسنجی بین آزمایشهای مختلف، مقایسه امتیازها را غیرممکن میکند. تنها راه قابل اعتماد برای تست ابرپارامترهایی مثل رتبه و آلفا، منجمد کردن مجموعه اعتبارسنجی در تمام اجراهای کاندید است. مجموعه اعتبارسنجی باید برای ارزیابی در دسترس بماند و نباید در دل دادههای آموزشی جذب شود.
بستر سختافزاری و زیرساختی
در محیط آزمایشی تاییدشده، از چهار GPU NVIDIA A100 با ۸۰ گیگابایت حافظه برای هر کارت، بهینهساز AdamW و اندازه دسته ۴ استفاده شده است. اگرچه اینها نقاط مرجع مفیدی برای بازتولید آزمایش هستند، اما راهنما هشدار میدهد که اینها الزامات جهانی نیستند. ظرفیت سختافزاری، طول توالی (Sequence Length)، اندازه مدل و نحوه پیادهسازی آموزش، تنظیمات نهایی هر پروژه را تعیین میکند.
برای کسانی که از Hugging Face Transformers API استفاده میکنند — که همان API مورد استفاده در مطالعه تاییدشده برای مدیریت مدل، آموزش و اعتبارسنجی بود — هدف این است که نقاط تصمیمگیری خط لوله مستقیماً به مقادیر واقعی زیان و گرادیان تولیدشده توسط فریمورک متصل شود.
بررسیهای سلامت زمان اجرا و بهینهسازی
بررسیهای زمان اجرا باید به دنبال شکستهایی باشند که اعتبارسنجی استاتیک نمیبیند. توصیفات FT-Dojo بهطور مشخص انفجار زیان، مجموعهدادههای خالی و گرادیانهای نامعتبر را به عنوان نمونههای اصلی ناهنجاریهای زمان اجرا معرفی میکند. یک ادغام آموزشی صحیح باید نقطه تصمیمگیری را به مقادیر واقعی زیان و گرادیان تولیدشده توسط فریمورک آموزش متصل کند.
اگر یک بررسی سلامت در طول اجرای کامل شکست بخورد، فرآیند باید فوراً متوقف شود. اگر مجموعهداده خالی بود، ساختار خروجی ناسازگار بود، زیان غیرمتناهی شد یا گرادیانها نامعتبر بودند، نباید یک فرآیند تکمیلشده را به عنوان یک آزمایش موفق تفسیر کنید. هدف از این طراحی مرحلهبندی شده، رد کردن سریع پیکربندیهای معیوب و ارائه تشخیصهای هدفمند در زمانی است که هنوز محاسبات کمی صورت گرفته است.
علاوه بر این، پژوهشهای تاییدشده بهینهسازی ابرپارامترهای جعبهسیاه با استفاده از NOMAD را توصیف میکنند. اگرچه این یک رویکرد بهینهسازی تجربی است، اما دلیلی برای نادیده گرفتن اعتبارسنجی نیست. هر پیکربندی پیشنهادی توسط یک بهینهساز باید پیش از مجوز آموزش گرانقیمت، از بررسیهای استاتیک ارزان و اجرای کوچک عبور کند.
اجرا و تایید نهایی
گزارشی که مقدار approved_for_full_run: true را نشان میدهد، تنها به معنای عبور از دروازههای محلی است و تضمینی برای کیفیت، ایمنی یا مفید بودن مدل نهایی نیست. پیش از آموزش کامل، توسعهدهندگان باید:
- نمونههای معرف را بهصورت دستی بازبینی کنند.
- تایید کنند که مجموعه اعتبارسنجی کاملاً مجزا است و با نمونههای آموزشی همپوشانی ندارد.
- پیادهسازی تنظیم دقیق انتخابشده را اجرا کنند.
- مدل حاصل را روی مجموعه اعتبارسنجی تغییرناپذیر ارزیابی کنند.
برای حفظ یک جدول آزمایش بازتولیدپذیر، توسعهدهندگان باید موارد زیر را برای هر کاندید ثبت کنند:
- نسخه مجموعهداده و شناسه مدل.
- رتبه لورا، آلفا، دراپاوت و نرخ یادگیری.
- اندازه دسته و تعداد گامهای آموزشی یا Epochها.
- زیان نهایی آموزش و زیان اعتبارسنجی.
نکته حیاتی این است که نباید اجراهایی را با هم مقایسه کرد که دادههای آموزشی یا اعتبارسنجی آنها بهطور همزمان تغییر کرده است. این چرخش به سمت مهندسی «سریع-شکست»، این فرض را که تنظیم دقیق یک فرآیند آزمون و خطا است، تغییر میدهد و آن را به یک خط لولهی مهندسی قابل تایید تبدیل میکند که در آن یکپارچگی دادهها پیش از ضرب اولین تنسور تضمین میشود.
توسعهدهندگان اکنون باید اسکریپتهای فعلی تنظیم دقیق خود را بازرسی کنند تا ببینند آیا شامل یک مجموعه اعتبارسنجی مجزا و بررسی طرحواره پیشپرواز هستند یا خیر. گام بعدی، ادغام این بررسیها در خط لولههای CI/CD است تا تضمین شود هیچ نسخهای از دادهها بدون عبور از دروازه اعتبارسنجی استاتیک، آموزش را آغاز نکند.
گام بعدی شما
- اسکریپتهای فعلی تنظیم دقیق خود را بررسی کنید تا مطمئن شوید مجموعه اعتبارسنجی مجزا و بررسی طرحواره پیشپرواز دارند.
- این بررسیها را در خط لولههای CI/CD ادغام کنید تا هیچ نسخهای از دادهها بدون عبور از دروازه استاتیک، آموزش را آغاز نکند.
- برای هر آزمایش، یک جدول ثبت دقیق از ابرپارامترها و نتایج زیان ایجاد کنید تا از تکرار خطاهای مشابه جلوگیری شود.
اما مدیریت حافظه در مدلهای بزرگتر چالشهای متفاوتی دارد — به تحلیل ما دربارهی تکنیکهای کوانتش وزنها مراجعه کنید.



گفتگو