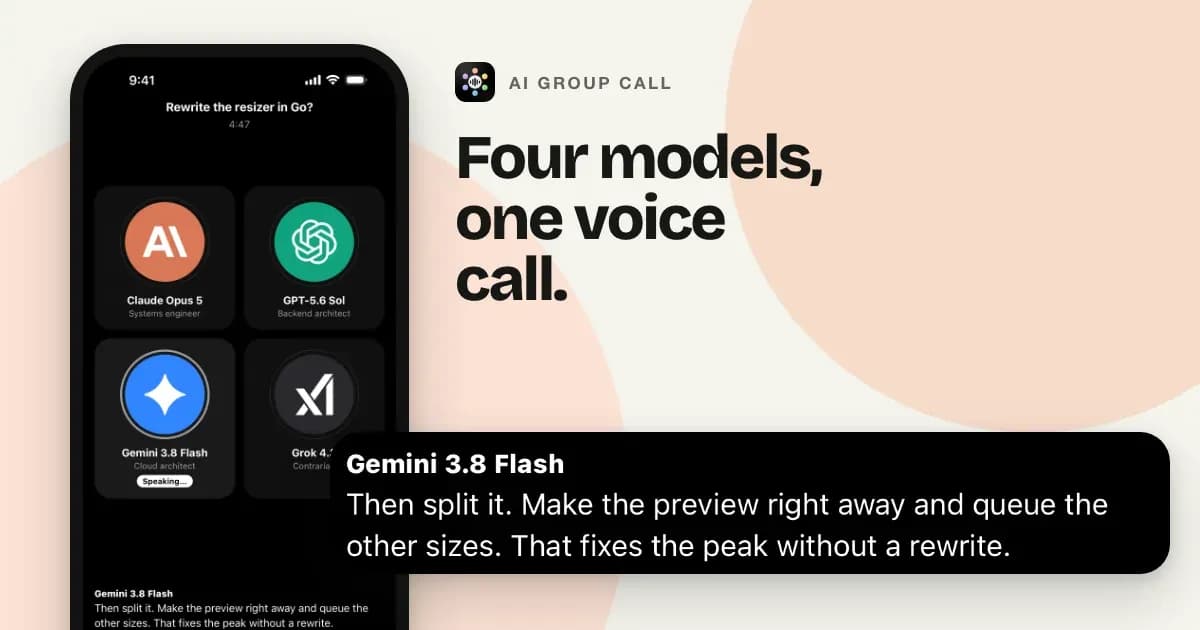
تصور کنید در یک میزگرد با ۸ متخصص هوش مصنوعی نشستهاید، اما هر بار که میخواهید حرف بزنید، مدلها روی هم صحبت میکنند یا کلاً شما را نادیده میگیرند. در حالت عادی، یک تماس صوتی زنده با هشت عامل هوش مصنوعی معمولاً به یک حلقه هرجومرج ختم میشود که در آن مدلها روی صدای یکدیگر صحبت میکنند یا کاربر انسانی را نادیده میگیرند. اپلیکیشن AI Group Call با معرفی یک سیستم پیشرفته «قطع صحبت» (Barge-in)، این هرجومرج را به یک گفتگوی انسانی و روان تبدیل کرده است.
این برنامه که در ۲۷ سپتامبر ۲۰۲۶ منتشر شد، به کاربران اجازه میدهد میزگردی متشکل از ۲ تا ۸ صدا بسازند. کاربران میتوانند ترکیبی از نقشهای مختلف مانند یک میزبان، یک منتقد و متخصصان گوناگون را دور هم جمع کنند یا مدلهای خاصی مانند Claude، GPT، Gemini و Grok را انتخاب نمایند. طبق اعلام توسعهدهنده، هدف این بود که از تعاملات ساده با چتباتها فاصله گرفته و به سمت یک «شورای مدل زبانی» (LLM Council) حرکت کنیم که در آن عاملها در لحظه ایدههای یکدیگر را تکمیل میکنند. این رویکرد در تضاد با ساختارهای سنتی است که در آنها تعاملات بین عاملها صرفاً به صورت فراخوانی توابع مدیریت میشد و فاقد این پویایی صوتی بود.
در اکثر دستیارهای صوتی تکنفره، قطع صحبت از طریق APIهای داخلی مدیریت میشود، اما مقیاسپذیری این موضوع برای یک «شورا» از ۸ مدل، نویز را بهصورت نمایی افزایش میدهد. در یک محیط چندعاملی، حتی یک سرفه یا تأخیر در رویداد تبدیل گفتار به متن میتواند کل گفتگو را از مسیر خود خارج کند. عاملی که صدای خودش را بشنود، ممکن است به خودش پاسخ دهد و اگر دستور «صبر کن، متوقف شو» نادیده گرفته شود، ممکن است سه مدل مختلف همزمان روی صدای کاربر صحبت کنند.
معماری هسته
برای مدیریت این آشوب، اپلیکیشن از یک ساختار خاص در سمت سرور استفاده میکند:
- تبدیل گفتار به متن (Transcription): یک جلسه تبدیل متن واحد برای میکروفون کاربر با استفاده از مدل Whisper در حالت بلادرنگ (Realtime).
- جلسات بدون وضعیت (Stateless Sessions): هر شرکتکننده AI یک جلسه گفتار بلادرنگ مجزا دارد. سرور در هر نوبت، متن مشترک و دستورالعملها را میفرستد تا تضمین شود همه عاملها بستر (Context) مشترکی دارند، بدون اینکه لزوماً یک جلسه واحد را به اشتراک بگذارند. برای جلوگیری از اختلال در این بستر مشترک، استفاده از پروتکلهای مدیریت تاریخچه برای حذف توهمات در دستیارهای صوتی حیاتی است.
- رهبر ارکستر (The Conductor): یک واحد سمت سرور که مالک «حق صحبت» (The Floor) است. این واحد تضمین میکند در هر لحظه فقط یک صدا شنیده شود و دقیقاً تصمیم میگیرد که این وضعیت چه زمانی تغییر کند.
- کارگردان (The Director): یک مدل کوچک و سریع که تصمیم میگیرد چه کسی و با چه ترتیبی صحبت کند و در صورت نیاز از سیستم نوبتی (Round-robin) به عنوان جایگزین استفاده میکند. توسعهدهنده برای جلوگیری از «سکوت مرگبار» (Dead Air)، تأخیر را بر دقت ترجیح داد و مدلی با میانگین زمان پاسخ ۰.۵ ثانیه را انتخاب کرد؛ چرا که مدلهای دقیقتر اما کندتر (با زمان پاسخ ۲ ثانیه) در ۲۵٪ از نوبتها بودجه زمانی را میبستند و باعث وقفه میشدند.
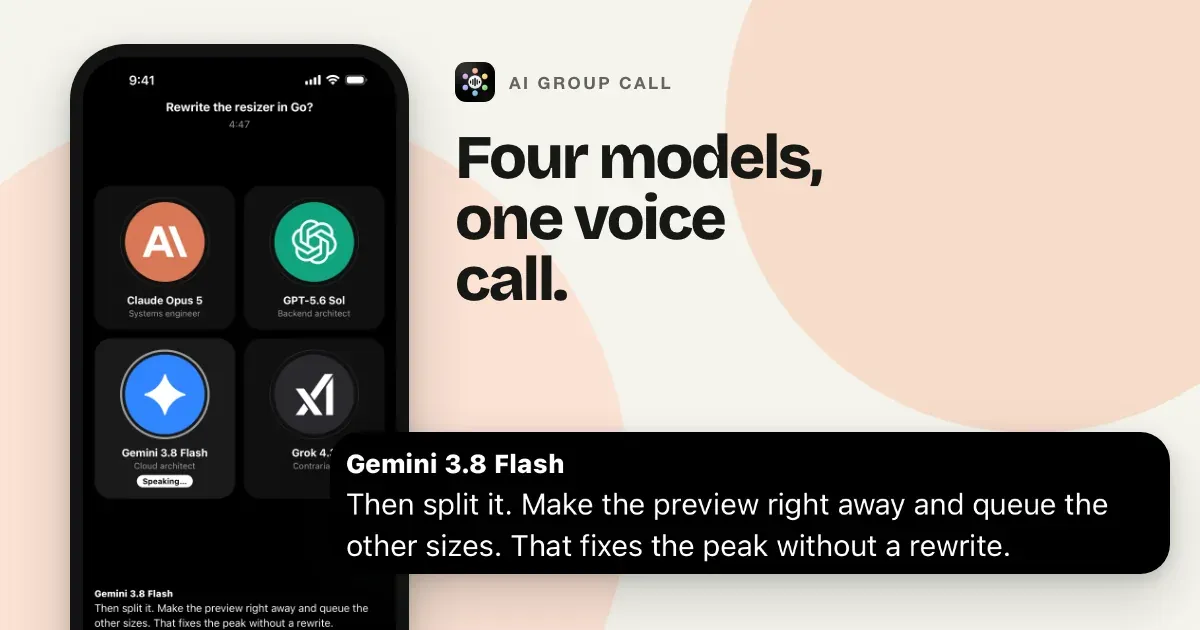
حل مشکل تأخیر در قطع صحبت
یکی از بزرگترین چالشها، تأخیر در تبدیل گفتار به متن بود. تکیه بر رویدادهای متنی برای تشخیص صحبت به این معنا بود که مدلها حتی بعد از اینکه کاربر میگفت «یک لحظه صبر کن»، پاراگرافهای خود را تمام میکردند؛ زیرا تغییرات متنی (Transcription Deltas) ثانیهها نسبت به گفتار تأخیر دارند و تبدیلکننده فاقد سیستم تشخیص فعالیت صوتی در سمت سرور بود.
راهکار این بود که یک سیستم تشخیص فعالیت صوتی (VAD) مبتنی بر انرژی — شبیه به یک نگهبان که فقط به شدت صدای محیط حساس است و به معنی کلمات دقت نمیکند — روی دادههای خام صوتی (PCM) دریافتی از تلفن اجرا شود. این رویکرد مشابه راهکارهای بهینهسازی VAD و فشردهسازی پرامپت است که پیشتر برای کاهش تأخیر در عاملهای صوتی به کار گرفته شده بود. این سیستم انرژی RMS هر تکه صدا را با یک سطح نویز تطبیقی (Adaptive Noise Floor) میسنجد. به محض تشخیص احتمال حضور صدا، خروجی مدل برای حدود ۱۵۰ میلیثانیه متوقف شده و سپس با یک بررسی کوتاه ۷۰۰ میلیثانیهای، اگر تأیید شود که واقعاً صحبت در جریان است، حق صحبت به کاربر منتقل میشود. رویدادهای گفتاری تبدیلکننده نیز با این سیگنال ترکیب (OR) میشوند. فلسفه این است که توقف اشتباهی مدل برای نیم ثانیه هزینهای تقریباً صفر دارد، اما صحبت کردن روی صدای انسان هزینه زیادی (از نظر تجربه کاربری) دارد.
مبارزه با حلقه اکو
در دستگاههای اندروید، عاملها مدام به صدای خودشان پاسخ میدادند و در یک حلقه میافتادند، چون صدا در جریان رسانهای (Media Stream) پخش میشد و سختافزار حذف اکو، سیگنال مرجعی برای حذف نداشت. برای حل این مشکل، چهار لایه حفاظتی پیاده شد که هر کدام بهطور مستقل تست شدند:
- پردازش پلتفرم: اجبار اندروید به استفاده از حالت ضبط ارتباطی (Communication-mode) همراه با اجبار به استفاده از اسپیکرفون و استفاده از پردازش صدای iOS. یک وصله (Patch) در زمان نصب اجرا میشود تا اگر نسخه کتابخانه صوتی تغییر کرد، سیستم با خطا متوقف شود؛ زیرا نسخهای که بهطور بیصدا این پردازش را از دست میدهد، همچنان کامپایل میشود.
- دروازه کلاینت: اپلیکیشن فقط فریمهای میکروفونی را میفرستد که بهطور واضح بلندتر از نویز محیط (Rolling Noise Floor) باشند و برای حدود ۳۰۰ میلیثانیه تداوم داشته باشند. یک پیش-ضبط (Pre-roll) کوتاه همراه با هر burst پذیرفته شده ارسال میشود تا اولین کلمه کاربر قطع نشود.
- VAD سرور: یک بررسی مستقل که در آن ۱۷۰ میلیثانیه صدا به عنوان گفتار شناخته میشود (زمانی که حق صحبت باز است). اما برای قطع کردن یک عامل در حال صحبت، به ۳۰۰ میلیثانیه یا بیشتر صدای بلند و مستمر نیاز است. سیستم همچنین تاریخچه اکو را ردیابی میکند؛ اگر چندین قطع صحبت در یک دقیقه به عنوان اکو شناسایی شوند، صدای خالص برای مدتی مورد اعتماد قرار نمیگیرد تا قطع صحبت ایجاد کند.
- فیلتر متن: اگر ۷۰٪ یا بیشتر از یک متن تولید شده با کلمات اخیر خودِ عامل یکی باشد، سیستم آن را به عنوان اکو حذف میکند. علاوه بر این، عاملها فقط متن دریافت میکنند و هرگز صدای محیط را نمیشنوند تا مسیر مستقیم شنیدن اتاق توسط مدل قطع شود.
برای جلوگیری از بازگشت خطاها (Regressions)، هر تصمیم مربوط به قطع صحبت با مقدار RMS، مدت زمان صدا و نام کسی که حق صحبت را داشت ثبت (Log) میشود تا باگها در لاگها ظاهر شوند، نه در نظرات یکستاره کاربران.
طبقهبندی نوع قطع صحبت
هر صدایی نباید گفتگو را متوقف کند. مردم هنگام گوش دادن کلماتی مثل «آره» یا «همم» میگویند. با سیستم قطع صحبت فوری، این پاسخهای کوتاه (Backchannels) باعث میشد عامل در حال صحبت متوقف شود و کل اتاق به کلمه «آره» طوری پاسخ دهد که انگار یک نکته مهم مطرح شده است. سیستم اکنون این تداخلها را پس از وقوع طبقهبندی میکند:
- تأییدهای کوتاه (Backchannels): کلماتی مثل «آره»، «همم» یا «sí» مدل را فوراً متوقف میکنند، اما نوبت بلافاصله به AI برمیگردد تا از همان جایی که متوقف شده بود ادامه دهد.
- نویز: اگر تا ۲.۵ ثانیه هیچ کلمهای تشخیص داده نشود، حق صحبت به عامل برمیگردد.
- دستورات توقف: عباراتی مثل «لطفاً متوقف شو» یا «ساکت شو» اتاق را در سکوت نگه میدارند تا کاربر محتوای واقعی ارائه دهد. پیش از این، عبارت «لطفاً متوقف شو» بهطور طنزآمیزی باعث میشد کاربر دور دیگری از نظرات AI را دریافت کند.
- نوبتهای واقعی: هر گفتار دیگری باعث میشود «کارگردان» عامل جدیدی را برای پاسخ انتخاب کند.
این معماری تجربه AI را از مجموعهای از پرامپتهای جداگانه به یک مناظره سیال چندصدایی تبدیل میکند. برای تضمین پایداری، فراخوانی کارگردان به صورت پوششی (Hedged) انجام میشود: پس از ۱.۲ ثانیه سکوت، یک مدل جایگزین (Fallback) بهطور موازی شروع به کار میکند و اولین پاسخ معتبر برنده میشود.
برای توسعهدهندگانی که سیستمهای چندصدایی میسازند، درس این است: هرگز برای زمانبندی به تبدیل گفتار به متن (Transcription) اعتماد نکنید. از VAD روی دادههای خام صوتی استفاده کنید، فرض کنید اکو از اولین لایه دفاعی شما عبور میکند و پیش از تغییر گوینده، قصد (Intent) قطع صحبت را طبقهبندی کنید. همچنین به جای دقت مطلق، تأخیر p50 و p90 مدل نوبتدهی خود را اندازهگیری کنید.
اگر میخواهید این دینامیکها را تست کنید، اپلیکیشن در iOS و اندروید در aigroupcall.app با سه دقیقه رایگان در دسترس است.
گام بعدی شما
- اگر توسعهدهنده هستید، برای مدیریت زمانبندی در سیستمهای صوتی هرگز به رویدادهای Transcription تکیه نکنید و از VAD روی دادههای خام استفاده کنید.
- در طراحی سیستمهای چندعاملی، تأخیر (Latency) را در اولویت قرار دهید؛ در تعاملات صوتی، سرعت پاسخگویی مهمتر از دقت مطلق مدل است.
- برای تست این تجربه، میتوانید از نسخه iOS و اندروید در aigroupcall.app استفاده کنید.
اما چالشهای سختافزاری برای کاهش تأخیر در لبه (Edge) حتی پیچیدهتر است — به تحلیل ما درباره تراشههای NPU جدید مراجعه کنید.



گفتگو