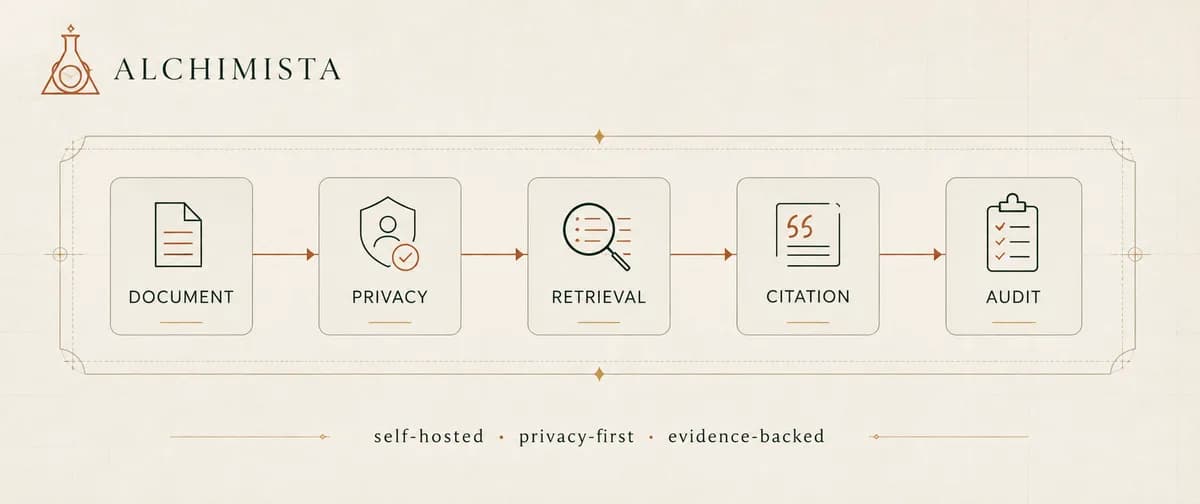
تصور کنید مدیر فناوری یک سازمان هستید و باید دقیقاً ثابت کنید چرا هوش مصنوعی یک پاسخ حساس را به کاربری داده است. در سیستمهای فعلی، این پاسخ یک «جعبهسیاه» است، اما Alchimista این بازی را تغییر میدهد. در حالی که یک دموی استاندارد RAG معمولاً با ارائه یک پاسخ محتمل به پایان میرسد، Alchimista با آن پاسخ را به عنوان نقطه شروع یک ردپای حسابرسی در نظر میگیرد.
این سامانه که در ۲ سپتامبر ۲۰۲۶ عرضه شد، تمرکز را از بازیابی ساده به یک مسیر کامل شواهد تغییر داده است. این مسیر شامل مراحل زیر است: سند $\rightarrow$ پردازش حریم خصوصی $\rightarrow$ جذب داده $\rightarrow$ بازیابی $\rightarrow$ پاسخ مستند $\rightarrow$ شواهد تصمیمگیری و در نهایت، حسابرسی.
بسیاری از توسعهدهندگان با ماهیت مبهم تولید بازیابیافزا (RAG) — که شبیه دانشآموزی است که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — دستوپنجه نرم میکنند. این رویکرد در واقع تکامل همان استراتژی اتصال به دادههای شرکت برای حذف توهمات AI است که پیشتر به عنوان راهکاری برای افزایش دقت پاسخها معرفی شده بود. در حالی که خطلولههای پایه، یک پرسوجوی کاربر را به یک پایگاهداده برداری متصل میکنند تا پاسخی تولید شود، آنها اغلب در اثبات اینکه دقیقاً از کدام شواهد استفاده شده یا دادههای حساس چگونه مدیریت شدهاند، شکست میخورند. طبق گزارش مستندات پروژه، Alchimista به عنوان پاسخی به این شکاف حاکمیتی عرضه شده تا تصمیمات هوش مصنوعی را از حالت «محتمل» به «قابل اثبات» تبدیل کند.
شکاف حاکمیتی
این پروژه به سوالات حیاتی پاسخ میدهد که دموهای استاندارد نادیده میگیرند. Alchimista میپرسد وقتی یک پاسخ کافی نیست چه اتفاقی میافتد و چگونه میتوان تایید کرد که در طول یک تعامل خاص، کدام سیاست (Policy) فعال بوده است. این موضوع مستقیماً با بحث کفایت شواهد در برابر روانی متن مرتبط است، جایی که اولویت از تولید متنی زیبا به تولید پاسخی مستند تغییر میکند. تمرکز این سیستم بر این است که آیا دو مستاجر (Tenant) هرگز میتوانند اسناد یکدیگر را ببینند و در واقعیت سیستم چه کاری انجام داده است، در مقابل آنچه یک نمودار معماری ادعا میکند که سیستم «باید» انجام دهد.
مسیر شواهد
Alchimista بر این اصل بنا شده است که یک پاسخ هوش مصنوعی باید شواهدی از خود به جای بگذارد. سیستم یک پیشرفت خطی سختگیرانه را دنبال میکند: سند $\rightarrow$ پردازش حریم خصوصی $\rightarrow$ جذب داده $\rightarrow$ بازیابی $\rightarrow$ پاسخ مستند $\rightarrow$ شواهد تصمیمگیری $\rightarrow$ حسابرسی.
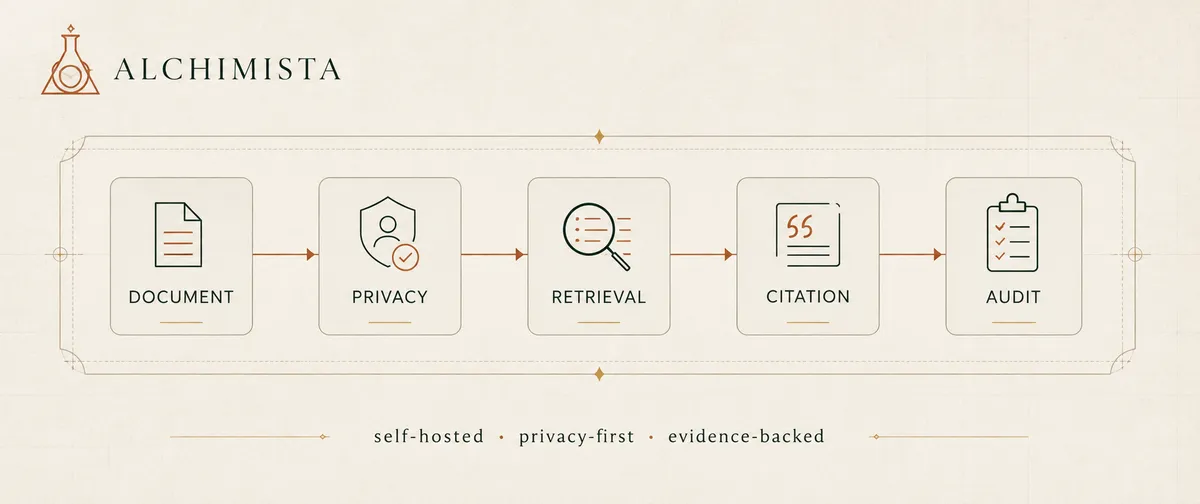
به نقل از مستندات این پروژه در dev.to، Alchimista به جای یک اپلیکیشن ساده، به عنوان یک لایه زیرساختی عمل میکند. برای تضمین یکپارچگی دادهها و حریم خصوصی، کنترلهای فنی سختگیرانهای را اجرا میکند:
جزئیات حریم خصوصی و امنیت
- خطلوله اولویتدار حریم خصوصی: مقادیر حساس پیش از تکهبندی (Chunking) و تبدیل به بردار معنایی (Embedding) — که مثل کارت معرفی عددی برای هر واژه است تا همسایگان معناییاش را بشناسد — مستعارسازی (Pseudonymized) میشوند. این امر تضمین میکند که شاخص بازیابی معمولی هرگز نمایشهای متن ساده (Cleartext) را دریافت نکند. برای بهبود این مرحله، برخی توسعهدهندگان از بازیابی ترکیبی برای پر کردن شکافهای دقت استفاده میکنند تا تعادلی میان امنیت و کیفیت بازیابی ایجاد کنند.
- ذخیرهسازی رمزنگاریشده: نگاشتهای بازگشتپذیر برای دادههای مستعار، به صورت مجزا در یک گاوصندوق رمزنگاریشده با استاندارد AES-256-GCM قرار میگیرند.
- منطق توقف در صورت خطا (Fail-Closed): اگر سرویس حریم خصوصی در دسترس نباشد یا نتیجهای نامعتبر تولید کند، پردازش متوقف میشود. سیستم اجازه نمیدهد که به عنوان یک راهکار جایگزین، پردازش به صورت خاموش با متن اصلی ادامه یابد.
- جداسازی مستاجران (Tenant Isolation): سیستم مرزهای سختگیرانهای را اعمال میکند تا بازیابی دادهها همیشه مالکیت سند توسط مستاجر را رعایت کند.
- یکپارچگی حسابرسی: ردپای حسابرسی بهگونهای طراحی شده که ثبت یک تصمیم هوش مصنوعی، به طور تصادفی نقطه نشت جدیدی برای دادههای حساس ایجاد نکند.
معماری Local-First (اول-محلی)
برای اطمینان از اینکه سیستم به صورت مستقل قابل اجرا و بازرسی باشد، نسخه فعلی وابستگیها به پروژههای GCP، پایگاهدادههای برداری خارجی، مستاجران Auth0 یا ذخیرهسازهای شیء پولی را حذف کرده است. پیشنیازها بسیار حداقلی هستند:
- Docker به همراه Compose
- Python 3.11+
- PostgreSQL
توسعهدهندگان میتوانند محیط را از طریق git clone https://github.com/Daniele-Cangi/Alchimista.git مقداردهی اولیه کنند، اسکریپت python scripts/init_local_env.py را اجرا نمایند و در نهایت دستور docker compose up --detach --build --wait را اجرا کنند. این کار یک رابط محلی شامل ماژولهای اسناد (Documents)، پرسش (Ask)، حریم خصوصی (Privacy)، حسابرسی (Audit)، حاکمیت (Governance) و سیستم (System) فراهم میکند.
برای اثبات اینکه سیستم فراتر از یک «رابط کاربری سبز» کار میکند، توسعهدهنده یک تست جامع (Smoke Test) محلی اجرا کرده است. این تست تمام زنجیره را میسنجد: از شناسایی حریم خصوصی، مستعارسازی و بازیابی دادهها گرفته تا ذخیرهسازی محافظتشده، بازیابی SQL، استنادات، جداسازی مستاجران، شواهد تصمیمگیری AI، متادیتای حسابرسی، گاوصندوق رمزنگاریشده و رفتار پاکسازی. این تست حتی پایداری دادهها را پس از ریاستارت PostgreSQL تایید میکند و در نهایت با تاییدیه SELF_HOSTED_SMOKE_OK به پایان میرسد.
محدودیتهای آگاهانه
Alchimista برای اینکه مفید باقی بماند، صریحاً مرزهای خود را بیان کرده است. این ابزار کنترلهای فنی ارائه میدهد اما به طور جادویی گواهینامه EU AI Act یا GDPR را صادر نمیکند. شناسایی PII (اطلاعات شناسایی شخصی) نمیتواند وعده دهد که تکتک مقادیر حساس را شناسایی کند. علاوه بر این، مسیر پیشفرض Embedding محلی برای تست مکانیسمهای بازیابی در نظر گرفته شده است، نه اینکه ادعا کند بهترین سیستم بازیابی معنایی موجود است. توسعهدهندگان همچنین باید بپذیرند که مستعارسازی قویتر میتواند بر کیفیت بازیابی اثر منفی بگذارد.
این رویکرد، فرض بنیادی توسعه RAG را تغییر میدهد: به جای بهینهسازی صرف برای «طبیعیترین» پاسخ، هدف بهینهسازی برای «قابل دفاعترین» پاسخ است. برای توسعهدهندگان در صنایع رگوله شده، این بدان معناست که سیستم کنترلهای فنی لازم برای ردیابی رفتار هوش مصنوعی را فراهم میکند.
با جابهجایی مرز اعتماد به یک محیط محلی و قابل بازرسی، این پروژه روند رو به رشدی به سمت هوش مصنوعی حاکمیتی (Sovereign AI) را برجسته میکند. موازنه در اینجا روشن است: حالتهای سختگیرانهتر حریم خصوصی میتوانند کیفیت بازیابی را کاهش دهند، به این معنی که توسعهدهندگان اکنون باید بین دقت هوش مصنوعی خود و سختگیری سیاستهای حریم خصوصیشان تعادل برقرار کنند.
توسعهدهندگان علاقهمند میتوانند مخزن گیتهاب را کلون کنند تا محیط محلی را تست کنند. فاز بعدی پروژه بر حمله به مرزها تمرکز خواهد داشت: تست اینکه سیستم تحت مجموعههای بزرگتر اسناد کجا میشکند، اندازهگیری میزان افت کیفیت بازیابی تحت استراتژیهای مختلف حریم خصوصی، و تعیین اینکه کدام بخش از شواهد تصمیمگیری AI برای تحقیقاتی که ماهها بعد انجام میشود، واقعاً مفید هستند.
گام بعدی شما
- مخزن گیتهاب Alchimista را کلون کنید و تست Smoke را در محیط Docker اجرا کنید تا مسیر شواهد را ببینید.
- اگر در صنعتهای رگوله شده (مثل مالی یا سلامت) فعالیت میکنید، استراتژی مستعارسازی دادهها را با نرخ خطای بازیابی مدل خود مقایسه کنید.
- بررسی کنید که آیا سیستمهای فعلی شما در صورت قطع شدن لایه امنیتی، به صورت Fail-Closed عمل میکنند یا خیر.
اما چالش اصلی، مقیاسپذیری این مدل در مجموعههای داده میلیونی است — در گزارش بعدی، اثر حجم داده بر کیفیت بازیابی در محیطهای محلی را بررسی خواهیم کرد.



گفتگو