آموزش یک عامل کدنویس برای مدیریت پروژههای واقعی، معمولاً به یک کابوس لجستیکی برای خوشههای GPU تبدیل میشود. تصور کنید تکتک اجرای مدلها ساعتها به طول بینجامد، صدها بار از ابزارها استفاده کند و نزدیک به یک میلیون توکن مصرف نماید. این حجم از مصرف منابع، مدیریت سختافزاری را به چالشی جدی تبدیل میکند؛ موضوعی که در تحلیل ما درباره هزینههای پنهان اتوماسیون و اتلاف توکنها در عاملهای زمانبندیشده به تفصیل بررسی شده است.
به نقل از گزارش فنی منتشر شده در arXiv (شماره ۲۶۰۹.۳۳۸۴۸)، تیم Qwen علیبابا برای حل این چالش، چارچوب QwenGyre را معرفی کرد. این سیستم یک محیط یادگیری تقویتی (Reinforcement Learning) انعطافپذیر است که بهطور خاص برای عاملهای «افق بلند» (xLong-horizon) طراحی شده است تا بتوانند وظایفی با گامهای زمانی طولانی را بهینه کنند.
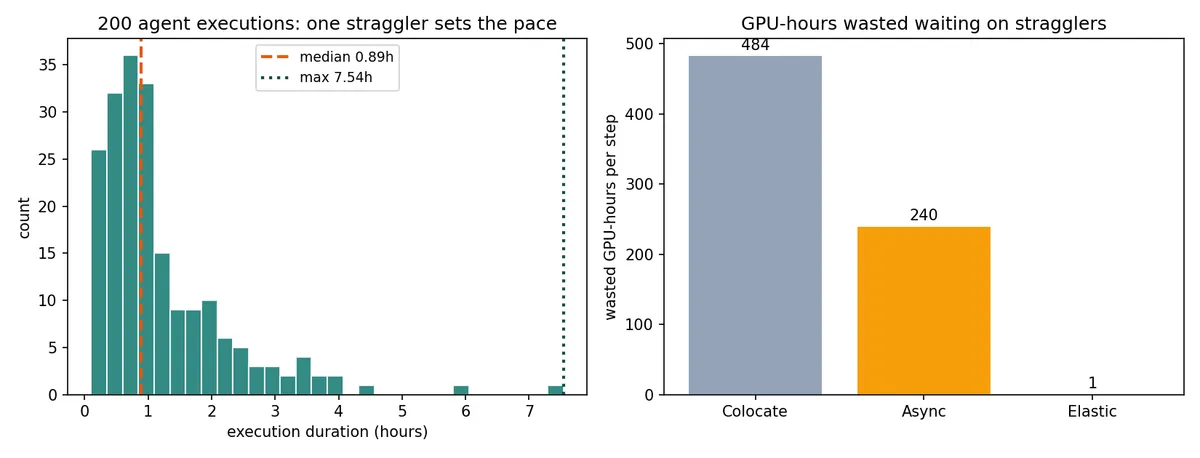
بیشتر سیستمهای یادگیری تقویتی از مشکلی به نام «مالیات کندترین عضو» (Straggler Tax) رنج میبرند؛ وضعیتی که در آن GPUهای گرانقیمت بیکار میمانند تا کندترین اجرای عامل به پایان برسد. این وضعیت شبیه به کلاسی است که در آن همه دانشآموزان به سقف خیره شدهاند و منتظرند تا آخرین نفر امتحان خود را تحویل دهد. همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی زیرساختهای مدلهای زبانی اشاره کردیم، اتلاف محاسباتی در مقیاس بزرگ، بزرگترین مانع پیش روی توسعه مدلهای استدلالی است.
زمینه و ناکارآمدیهای RL
در محیطهای سنتی یادگیری تقویتی، توسعهدهندگان معمولاً بین دو گزینه ناقص دستوپا میزنند:
- Colocate (هممکانی): در این حالت، تمام GPUها ابتدا عملیات Rollout (تولید داده) را انجام میدهند و سپس همگی وارد مرحله آموزش میشوند. در اینجا، کل مجموعه باید منتظر بماند تا کندترین اجرای عامل به پایان برسد.
- Async (ناهمگام): در این روش، سختافزار بهصورت ایستا تقسیم میشود (مثلاً نیمی برای Rollout و نیمی برای آموزش). مشکل اینجاست که هیچیک از دو بخش نمیتوانند از GPUهای آزاد بخش دیگر قرض بگیرند، که منجر به ایجاد ظرفیتهای رها شده و بلااستفاده میشود.
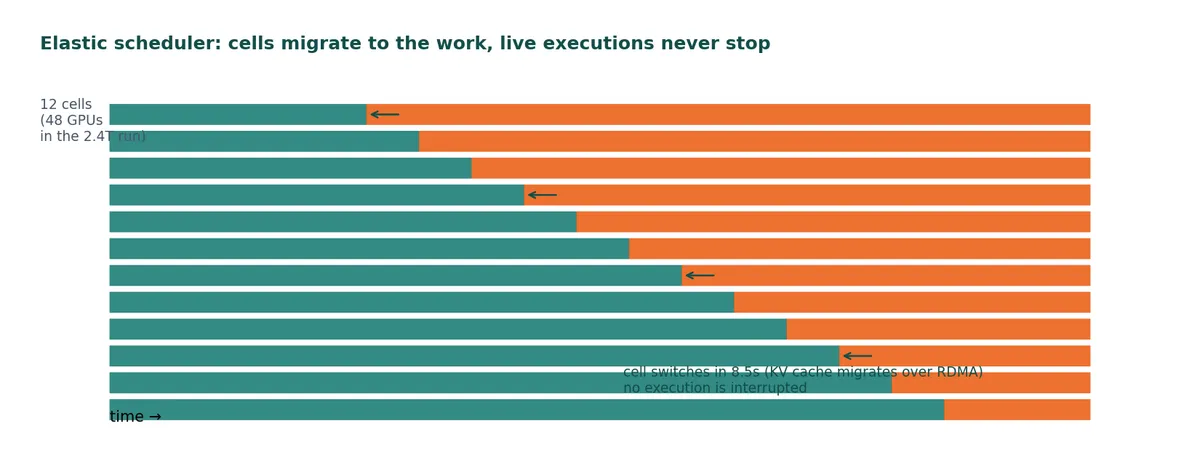
طبق مستندات این پروژه، QwenGyre این تقسیمبندی ایستا را با «سلولهای سختافزاری مستقل» جایگزین کرده است. به محض اینکه اجرای یک عامل به پایان میرسد، این سلولها بهصورت آنی از حالت استنتاج (Inference) به حالت آموزش تغییر وضعیت میدهند. درخواستهای مدل در میانه مسیر بازتوزیع شده و KV Cacheها برای جلوگیری از محاسبات تکراری، از طریق RDMA منتقل میشوند. این رویکرد برای مدیریت حافظه، شباهتهای ساختاری زیادی با مکانیزم Prompt Caching در Claude Code دارد که هدفش کاهش تکرار محاسبات در جلسات طولانی است.
سرعت این جابهجایی خیرهکننده است: ۸.۵۲ ثانیه برای تغییر از استنتاج به آموزش و ۳.۴۶ ثانیه برای مسیر معکوس. با توجه به اینکه اجرای هر عامل ممکن است ساعتها طول بکشد، این زمانهای جابهجایی در مقایسه با کل فرآیند، تنها یک خطای گرد کردن کوچک و ناچیز محسوب میشوند.
علاوه بر زمانبندی، این چارچوب یک پردازشگر مسیر (Trajectory Processor) را معرفی میکند تا تاریخچههای شاخهدار عامل را مدیریت کند. بهجای اینکه هر مسیر را یک نمونه جدید فرض کند، تاریخچهها را بهصورت درختهایی با پیشوندهای مشترک (Prefix-shared trajectory trees) بازسازی میکند تا بخشهای تکراری و شروعهای مشترک تنها یکبار آموزش ببینند.
جزئیات فنی و مکانیزمهای بهینهسازی
بر اساس گزارش فنی، کلیدیترین بهینهسازیها عبارتاند از:
- امتیازدهی پیشرفت جزئی (Partial Progress Scoring): اجراهایی که بهدلیل محدودیت زمانی (Timeout) متوقف میشوند، دور ریخته نمیشوند. فضای کاری حفظ شده و بر اساس پیشرفتش امتیاز میگیرد. این یعنی یک اجرای ۳ ساعته که ۸۰٪ آن کامل شده، همچنان سیگنال یادگیری ارائه میدهد. در شبیهسازیها، این روش همبستگی ۰.۹۱ با توانایی واقعی مدل داشت، در حالی که قوانین سنتی (امتیاز صفر برای شکست) سیگنالهای یادگیری را بهکل نابود میکردند.
- حذف مسیرهای تکراری (Path Deduplication): سیستم تعداد مسیرها را به ۵ مورد در هر اجرا محدود میکند. این کار بدون کاهش کیفیت، زمان رفتوبرگشت را ۲۵.۲٪ کم کرد. در حالت ۸ شاخه، اشتراک پیشوندها به تنهایی باعث افزایش ۲.۱ برابری سرعت شد که با اعمال سقف ۵ شاخهای، این افزایش به ۳.۱ برابر رسید. این استراتژی حذف دادههای زائد، یادآور تکنیکهای هرس کردن کانتکست (Context Pruning) است که مهندسان ارشد برای کاهش هزینههای کدنویسی به کار میبرند.
- فیلتر ارزیاب (Evaluator Filtering): خطاهایی که بهدلیل نقص در ابزارهای ارزیابی (Grader) رخ میدهند، بهجای امتیاز صفر، از چرخه حذف میشوند تا شکستهای ناشی از ابزار، سیگنال آموزش را مسموم نکنند.
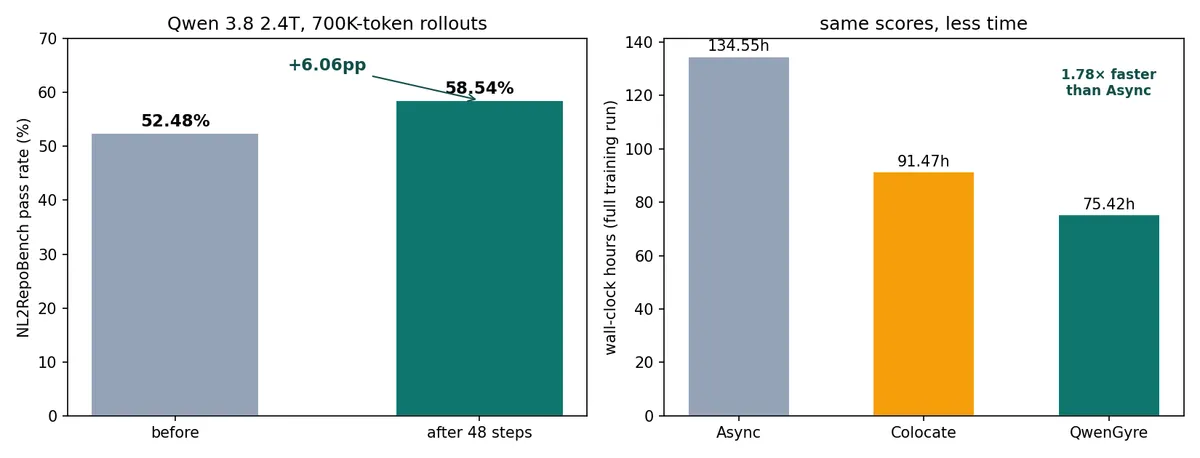
مقیاس این پیادهسازی بسیار گسترده است. تیم Qwen مدل Qwen 3.6 122B را روی ۲۴ تا ۳۲ گره و مدل پرچمدار Qwen 3.8 2.4T را روی ۱۹۲ گره (سازمانیافته در ۴ سلول ۴۸ تایی) آزمایش کرد. با استفاده از SGLang برای استنتاج، Megatron برای آموزش و یک محیط تست جعبهسیاه (Claude Code 2.1.220)، امتیاز مدل Qwen 3.8 2.4T در محک NL2RepoBench طی ۴۸ گام از ۵۲.۴۸٪ به ۵۸.۵۴٪ رسید.
از نظر بهرهوری، اجرای کامل با QwenGyre حدود ۷۵.۴۲ ساعت زمان برد، در حالی که در حالت Async این زمان ۱۳۴.۵۵ ساعت و در حالت Colocate حدود ۹۱.۴۷ ساعت بود. این یعنی سیستم جدید ۱.۷۸ تا ۱.۸۵ برابر سریعتر است. البته در مدل ۲.۴ تریلیونی، زمانی که کوئریهای زیادی با Timeout مواجه میشوند، این فاصله به ۱.۲۱ برابر کاهش مییابد، زیرا حتی در این سیستم هم «عضو کند» تأثیراتی دارد، هرچند بسیار کمتر.
این تحول نشان میدهد که مرز توانمندی عاملها از معماری مدل به «حلقه آموزش» منتقل شده است. وقتی هر اجرای واحد حدود یک میلیون توکن هزینه دارد، زمانبندی GPU و «بهداشت مسیرهای داده» (Trajectory Hygiene) به گلوگاههای اصلی تبدیل میشوند.
برای کل این حوزه، این نتایج ثابت میکند که انعطافپذیری (Elasticity) بر تقسیمبندی ایستا پیروز است. هر سیستمی با بارهای کاری بسیار متغیر، تقسیمبندی ثابت سختافزاری را ناکارآمد خواهد یافت. علاوه بر این، موفقیت امتیازدهی جزئی نشان میدهد که صنعت با تلقی کردن Timeoutها به عنوان شکستهای با امتیاز صفر، سیگنالهای یادگیری ارزشمندی را دور میریزد.
اگرچه نتایج چشمگیر است، اما علیبابا هنوز کد منبع QwenGyre را منتشر نکرده است. توسعهدهندگان باید این دستاورد را بهعنوان یک «اثبات وجود» (Existence Proof) ببینند، نه ابزاری که همین حالا قابل دانلود باشد.
گام بعدی شما
- برای ارزیابی عاملهای خود، بهجای متدهای ساده، از محکهای افق بلند مانند NL2RepoBench و TerminalBench استفاده کنید. مهندسی پرامپت نمیتواند شکاف وظایفی را که به یک ساعت انسجام مستمر نیاز دارند پر کند؛ مدل باید در همان محیط آموزش ببیند.
- در طراحی سیستمهای RL، بهجای حذف دادههای Timeout، مکانیزم امتیازدهی جزئی (Partial Scoring) را پیادهسازی کنید.
- اگر با بارهای کاری متغیر سروکار دارید، از تقسیمبندی ایستا در GPU دوری کنید و به سمت معماریهای سلولی حرکت کنید.
اما تأثیر این بهینهسازی بر هزینههای استنتاج در مقیاس تجاری حتی پیچیدهتر است — به تحلیل ما دربارهی مدلهای Mixture of Experts مراجعه کنید.



گفتگو