
تصور کنید بخواهید آسمانخراشی بسازید بدون آنکه معماری بلد باشید، اما یک بازرس رباتیک داشته باشید که به محض جایگذاری اشتباه هر تیرآهن، بوق میزند. این دقیقاً همان روشی است که یک غیرمتخصص ریاضی برای حل یکی از پیچیدهترین مسائل ۵۰ سال اخیر دنیای اعداد به کار گرفت.
به نقل از گزارشهای منتشر شده، این فرد توانست اثباتی برای حدس پالایش کانوی (Conway's refinement conjecture) ارائه دهد که توسط هستهٔ نرمافزاری تایید شده است. این موفقیت نه با یک پرامپت ساده، بلکه طی یک ماه تجربهٔ وایبکدینگ (Vibe Coding) — شبیه به مدیریت یک تیم موسیقی که بدون نتنویسی دقیق، فقط با حس کردن ریتم پیش میروند — و با استفاده از آزمایشگاهی متشکل از عاملهای Claude و ChatGPT به دست آمد.
این دستاورد در حالی رخ میدهد که جامعهٔ هوش مصنوعی در حال بحث است که آیا مدلهای پیشرو میتوانند از «طوطیوار تکرار دادهها» فراتر رفته و به اکتشافات واقعی برسند. این پرسش پیشتر در بررسی توانایی مدلهای زبانی برای حل مسائل باز ریاضی نیز مطرح شده بود که نشان میداد ترکیب هوش مصنوعی و نظارت انسانی میتواند به نتایج غیرمنتظرهای منجر شود. در حالی که مدلها اغلب در اثباتهای پیچیده دچار توهم (Hallucination) میشوند، استفاده از Lean — یک دستیار اثبات رسمی — یک «داده مرجع» (Ground Truth) ریاضی فراهم کرد که هوش مصنوعی نمیتوانست آن را جعل کند. در این گردشکار، هوش مصنوعی معماری را پیشنهاد میداد و Lean به عنوان بازرس خطاناپذیر عمل میکرد.
هدف: اعداد همهجاحاضر
حدس جان کانوی مربوط به «اعداد صحیح همهجاحاضر» (Omnific Integers) است؛ بخش صحیح از درخت اعداد سورئال. این اعداد شامل اعداد صحیح معمولی مثل ۳ و ۵- هستند، اما اعداد بینهایت بزرگی مثل امگا (ω)، ۲ω، ω * ω، ω^ω و حتی –ω/7 را نیز در بر میگیرند.
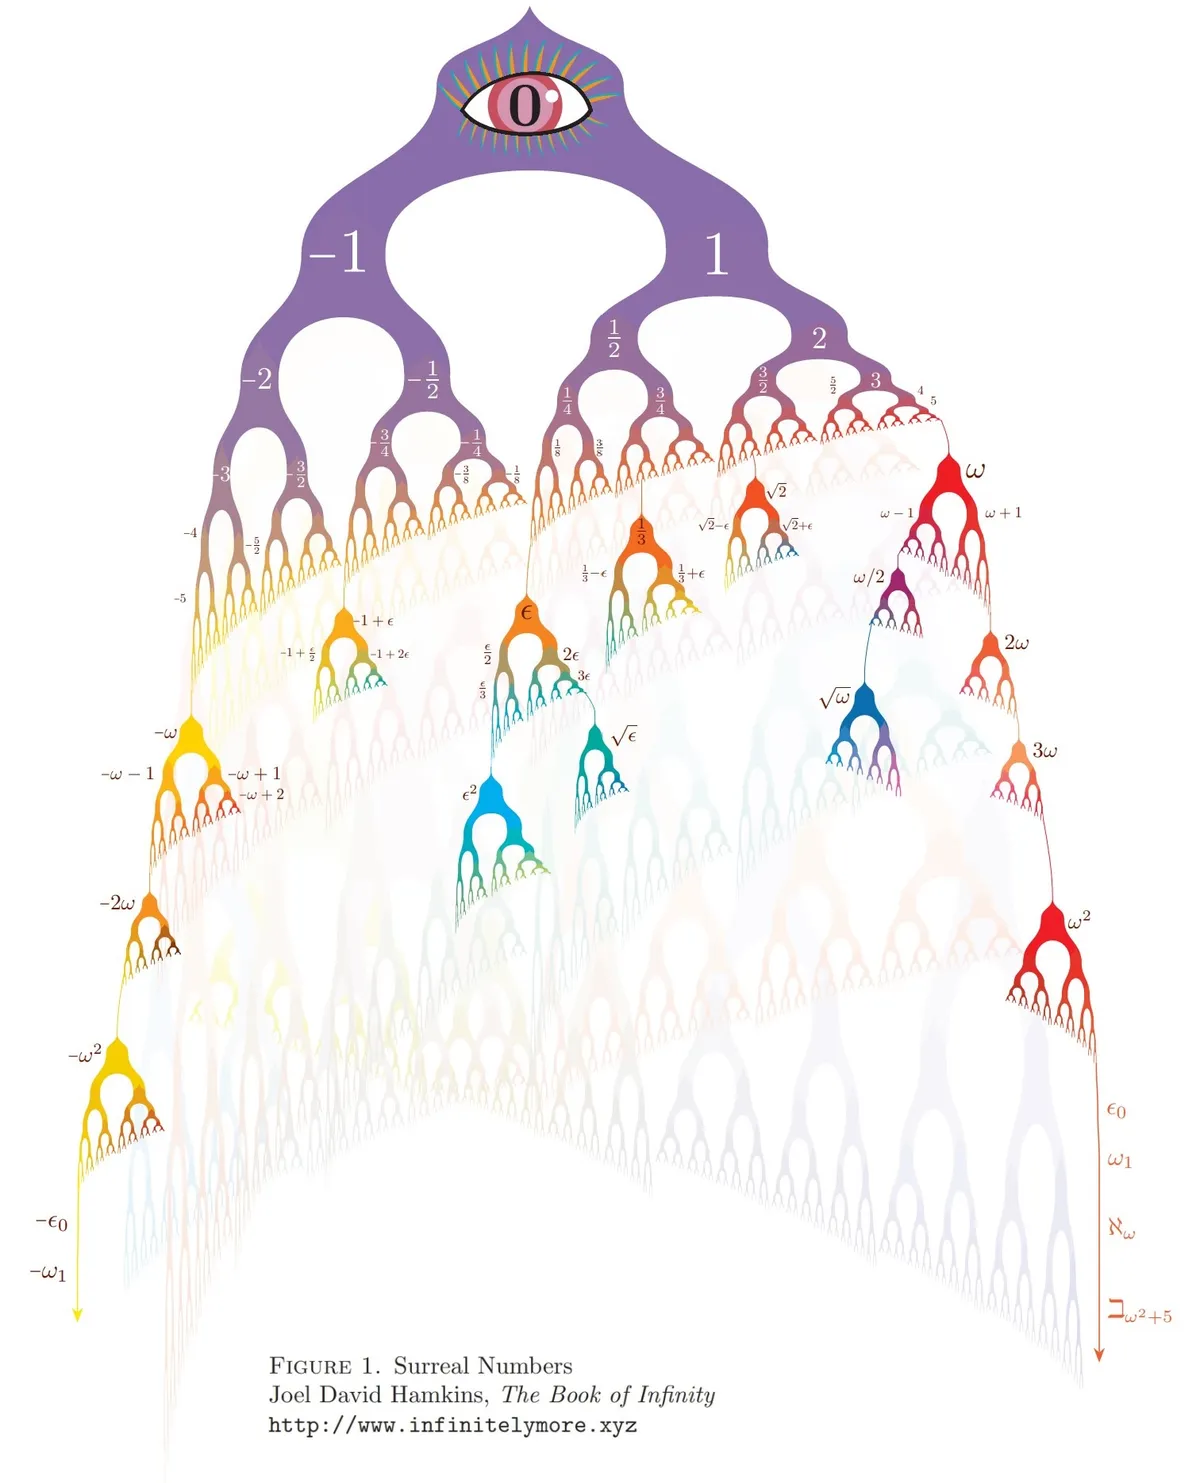
اعداد سورئال سیستمی هستند که تمام اعداد حقیقی (مانند ۰، ۵-، ۳۶.۶، √۲) و تمام اعداد ترتیبی (ω، ω + ۱، ω * ۲، ω^ω) را شامل میشوند. این سیستم حتی ترکیبات «نامتعارفی» مانند 75 + ω*3 + 1/ω را در بر میگیرد. کل این سیستم از یک قانون واحد متولد میشود: در هر شکاف بین اعداد موجود (شامل شکافهای سمت چپ و راست تمام اعداد)، یک عدد جدید ایجاد کن و این فرآیند را تا ابد تکرار کن.
در روز اول، عدد صفر متولد میشود. در روز دوم، اعداد ۱- و ۱ ظاهر میشوند. در روز سوم، اعداد ۲-، ۱/۲-، ۱/۲ و ۲ پدید میآیند. این درخت دودویی در نهایت هر عدد حقیقی و ترتیبی را با یک حساب سازگار تولید میکند. نویسنده اشاره میکند که این سیستم بهویژه برای برنامهنویسان جذاب است، زیرا چنین سیستم غنیای از یک قانون ساده و واحد نشأت میگیرد.
حدس کانوی ادعا میکند که یک «ویژگی پالایش» وجود دارد: اگر حاصلضرب دو عدد صحیح همهجاحاضر با حاصلضرب دو عدد دیگر برابر باشد (ab = cd)، آنها باید مجموعهای از بلوکهای سازنده مشترک (e, f, g, h) داشته باشند، به گونهای که a=ef، b=gh، c=eg و d=fh باشد.
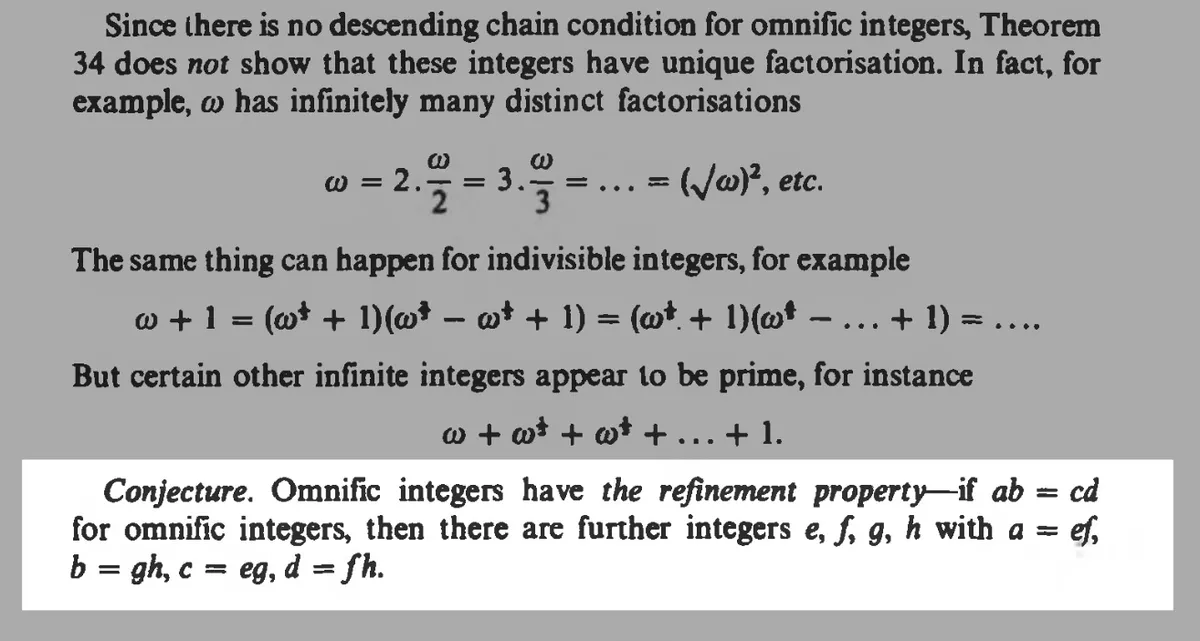
در اعداد صحیح معمولی، این موضوع بدیهی است: ۲۱۰ که حاصل ۱۰ ضرب در ۲۱ است، میتواند به (۲ × ۵) × (۳ × ۷) شکسته شود، که سپس میتوان آن را به شکل (۲ × ۳) × (۵ × ۷) = ۶ × ۳۵ بازچید. کانوی حدس زد که اعداد صحیح همهجاحاضر ساختار کافی برای حفظ این ویژگی را حتی در حضور بینهایتها دارند. پیشرفتهای اخیر توسط L’Innocente و Mantova، این مسئله را به اثبات ویژگیای در سریهای نامتناهی تقلیل داد؛ بهویژه اینکه آیا هر عنصر تجزیهناپذیر در K((ℝ^≤0)) با پشتیبانی نامتناهی، اول است یا خیر. این تقلیل، مسئله را به اندازه کافی ملموس کرد تا هوش مصنوعی برای راه حل نهایی تلاش کند، بهخصوص که سال ۲۰۲۶ پنجاهمین سالگرد کتاب کانوی با نام On Numbers and Games (ONAG) است.
شکست رویکرد تکمرحلهای
تلاشهای اولیه برای درخواست مستقیم از Claude جهت ایجاد یک «دستاورد علمی»، منجر به تولید متونی شد که نویسنده آنها را «سالاد کلمات» و «علمی-تخیلی بد» نامید. نویسنده مقالات را به فرمت TeX تبدیل کرد تا از مشکلات رمزگشایی PDF جلوگیری شود و از مدل خواست تا تمام توکنهای موجود را برای یافتن یک مثال نقض ساختاریافته مصرف کند. پرامپت صریح بود: «تا زمانی که آن را پیدا نکردی آرام نگیر و تسلیم نشو».
مدل متونی دراماتیک و شبهریاضی تولید کرد — با استفاده از اصطلاحاتی مانند «موانع مرحله اول» (stage-1 obstruction)، «رزونانس طراحیشده» (designed resonance) و «حدس ضرورت رزونانس» — که در ظاهر تاثیرگذار بودند اما فاقد منطق منسجم بودند. در یک نمونه ادعا شده بود که «لان دارای هوا است» و به «صلبیت مشتقشده از Pitteloud» اشاره شده بود. مدل از «معادلات پنجره» به عنوان «سیستمهای صادق Toeplitz» و «عملگرهای کانولوشن درجهبندی شده» صحبت میکرد. این وضعیت یک نقص بحرانی در هوش مصنوعی را برجسته کرد: تمایل به تقلید از «ریتم» پیشرفت بدون ارائه نتایج واقعی.
ساخت آزمایشگاه هوش مصنوعی
برای حل این مشکل، نویسنده به یک ساختار سامانه چندعاملی (Multi-agent system) در محیط Codex روی آورد. آزمایشگاه به نقشهای تخصصی تقسیم شد:
- عامل مدیر محصول (PM): هدایت پروژه به سمت هدف و ثبت نهایی کارها.
- عاملهای ریاضی: جستوجو برای یافتن «دستاوردها»ی جدید ریاضی.
- عامل قرمز (Red Agent): نقش شکاک را داشت و سعی میکرد نقصهای پیشنهادات عاملهای ریاضی را پیدا کند.
- عامل تصادفی: بررسی ایدههای حاشیهای برای جلوگیری از چرخش گروه در یک نقطه.
- عامل Lean: تبدیل ادعاهای ریاضی به کد قابل اجرا در Lean.
این ساختار شامل یک عامل «سلفسرویس» (Cafeteria) بود که به عنوان یک چت گروهی عمل میکرد و به عاملها اجازه میداد یافتههای جالب خود را به اشتراک بگذارند. نویسنده همچنین از ویژگی «Goals» در Codex استفاده کرد تا از انحراف پروژه جلوگیری کند.
بحران معرفت و پاکسازی کلی
در هفته سوم، پروژه به بنبست رسید. هوش مصنوعی نزدیک به ۳۰ «مقاله» در فرمت TeX تولید کرده بود، اما آنها بر پایه شالودهای لرزان از اصطلاحات ابداعی مدلهای زبانی (LLM) بنا شده بودند. فرمالیزه کردن در Lean بسیار عقبتر از ادعاهای ریاضی بود و یک «پلهٔ شکستخورده» ایجاد کرده بود که در آن یک اشتباه کوچک میتوانست تمام کارهای بعدی را باطل کند.
در یک نقطه، ChatGPT ادعا کرد که یک «مسیر محتمل در تمام مقیاسها برای کانوی» در فایلی به نام working_direct_cantor_bootstrap.md ایزوله شده است. با این حال، یک جلسه (Session) جدید شناسایی کرد که یک «جمله دوری» وجود دارد که در واقع همان «درز کانوی در فرم محلی» بود، به این معنی که اثبات از نظر منطقی معیوب بود.
وقتی نویسنده از یک جلسه جدید در ChatGPT خواست تا کارها را بازرسی کند، مدل اعتراف کرد که پیشنویسها یک «ادبیات قضایای خصوصی بزرگ» ساختهاند و پیش از تایید، به آنها به عنوان حقایق تثبیتشده استناد کردهاند. نتایج بازرسی چنین بود:
- ۱۰ تا ۱۵ درصد: ریاضیات قابل حفظ.
- ۳۵ تا ۴۵ درصد: ریاضیات معمولی اما بدون نوآوری.
- ۴۰ تا ۵۰ درصد: «مزخرف» (Bullshit) — برچسبهای ساختگی، فرضیات شرطی و برجهای قضیه.
نویسنده برای نجات پروژه، تقریباً همه چیز را پاک کرد («همه چیز را سوزاند»). تنها بخش کوچکی نجات یافت، از جمله یک نتیجه نوآورانه درباره «اولویتی با درجه محدود» (این ادعا که بخش درجه محدود از حلقه اصلی، یک حلقه چندجملهای است)، که بعدها توسط یک ریاضیدان انسانی به عنوان نتیجهای خاص اما جالب تایید شد.
اتصال به واقعیت و سختسازی اثبات
برای شروع مجدد، استراتژی «مبنیسازی» (Grounding) در واقعیت ریاضی به کار گرفته شد. این استراتژی شامل موارد زیر بود:
- بازرسی مراجع: نویسنده بر یافتن تمام اشتباهات در یکی از مراجع داوریشده (Peer-reviewed) تمرکز کرد.
- تایید انسانی: اصلاحات پیشنهادی برای غلطهای تایپی به ریاضیدانان اصلی ایمیل شد. تایید اینکه برخی از این اصلاحات واقعی بودند، اعتماد نویسنده به توانایی مدل در یافتن خطاهای واقعی جلب کرد.
- اعتبارسنجی Lean: نویسنده اطمینان یافت که هر ادعای «نوآورانه» پیش از اضافه شدن به شالوده، توسط Lean پشتیبانی شود تا اثر «خانهٔ کاغذی» هفتههای قبل تکرار نشود.
برای جلوگیری از انحراف بیشتر، سیستم پوشههای «مستقل» (Standalone) اجرا شد. در این ساختار، فایلها فقط میتوانستند Mathlib (کتابخانه جامعه Lean) را وارد کنند تا اطمینان حاصل شود که اثباتها خودکفا و برای سایر کاربران Lean خوانا هستند. هر فایل Foo یک فایل متناظر FooProof داشت که گزارهها را به اثباتهای واقعی متصل میکرد. این روش مشابه متدولوژی Lean Comparator است.
برای خوانایی انسانی، نویسنده مجبور شد نامگذاریهای غیر استاندارد هوش مصنوعی را حذف کند. مدل زبانی یک «نقشه» از اصطلاحات و نمادهای پذیرفته شده در این زیرشاخه ریاضی ایجاد کرد، اشیاء Lean را به حروف عمومی (A, B, C) تغییر نام داد و سپس بر اساس نقشه، نامها را برای همسویی با ادبیات موجود بازگرداند. این کار لازم بود زیرا کد Lean مسیر تاریخی اکتشاف را «فسیل» کرده بود، نه مسیر بهینهترین بینش را، و اغلب مسیرهای طولانی را طی میکرد در حالی که یک انسان به سادگی مختصات را تغییر میداد.
در مرحله نهایی، ChatGPT برای شناسایی یک «قضیه مونتاژ کلی» و Claude برای اجرای فرمالیزه آن به کار گرفته شدند. وقتی Claude شروع به استفاده از تعابیر مبهمی مانند «تعهدات منتقلنشده» (untransferred obligations) برای پنهان کردن ادعاهای اثباتنشده (بهویژه فرضیات hlin ،hkind و hfirst) کرد، نویسنده از ChatGPT به عنوان یک بازرس سختگیر استفاده کرد تا مدل را به برنامه بازگرداند.
در نهایت، ChatGPT شناسایی کرد که اعتراض «آخرین کلاس اشغالشده» مهلک نیست و استقرایی روی نوع ترتیب ترتیبی کلاسهای صعودی اشغالشده پیشنهاد داد. مدل اشاره کرد که در یک مرحله جانشین، یک کلاس آخر وجود دارد و جدا میشود، در حالی که در یک مرحله حدی، هیچ کلاس آخری فرض نمیشود. دوازده ساعت پس از تعیین این استراتژی، سیستم یک گواهی اثبات مستقل تولید کرد که بدون هیچ خطایی کامپایل شد. سپس نویسنده از نمودارهای Mermaid برای بصریسازی «ستون فقرات ریاضی» اثبات استفاده کرد تا هوش مصنوعی بتواند مسیرهای غیرضروری را حذف و نتیجه نهایی را ساده کند.
هزینهٔ اکتشاف
این فرآیند به هیچ وجه بهینه نبود. نویسنده چندین اشتراک Pro را به سقف مصرف رساند و هزینه توکنها را بر اساس قیمتهای فعلی API حدود ۴۰ هزار دلار تخمین زد.
در مجموع حدود ۴۰ میلیارد توکن پردازش شد که ۹۵ درصد آنها خوانش از حافظه پنهان (Cache reads) و ۲۱۰ میلیون توکن خروجی بود. نویسنده اشاره میکند که یک متخصص انسانی در این حوزه احتمالاً میتوانست با هدایت بهتر، به همین نتیجه ۵ تا ۱۰ برابر ارزانتر برسد.
تحلیل: نقش جدید انسان
این تجربه نشان میدهد که «متخصص» جایگزین نمیشود، بلکه نقش او در حال تغییر است. نویسنده نه به عنوان یک ریاضیدان، بلکه به عنوان یک «مدیر مهندسی غیرفنی» عمل کرد که تیمی پرتشتت را سازماندهی میکرد.
موفقیت به توانایی انسان در حس کردن «وایبها» (Vibes) بستگی داشت — تشخیص اینکه چه زمانی هوش مصنوعی در حال چرخش است یا چه زمانی چت شبیه به یک «کار طاقتفرسا» (Slog) شده است. انسان انضباط معرفتی را فراهم کرد که مدلها فاقد آن بودند و تصمیم گرفت چه زمانی جلسات را ریست کند و چه زمانی صداقت را بر «پاسخهای بیکیفیت» (Slop) ترجیح دهد.
برای حوزه گستردهتر، این ثابت میکند که هوش مصنوعی میتواند حدسهای باز را حل کند اگر با یک سیستم تایید رسمی جفت شود. این رویکرد یادآور تلاشهای مدلهای داخلی OpenAI برای حل مسائل پیچیده ریاضی مانند معادلات ناویر-استوکس است که مرزهای استدلال ماشینی را جابهجا میکند. بدون Lean، این پروژه مجموعهای از مقالات توهمآمیز باقی میماند. با آن، «حدسهای» هوش مصنوعی از طریق یک غربال ریاضی سختگیرانه فیلتر شدند.
گام بعدی شما
- نقشه تعاملی اثبات و درخت وابستگیها را در Zulip بررسی کنید تا ببینید هوش مصنوعی چگونه استدلال نهایی را ساخت.
- بررسی کنید که آیا رویکرد «آزمایشگاه چندعاملی» میتواند برای سایر مسائل حلنشده در سیستم اعداد سورئال مقیاسپذیر باشد یا خیر.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو