ده تست دستی موفق، هر کسی را به این باور میرساند که پروژه تمام شده است. اما برای توسعهدهندهای که در حال ساخت ابزار بوتاسترپ برای Claude Code بود، این یک فرض ساده بود تا زمانی که او یک ابزار بوتاسترپ برای این سیستم ساخت و یک سامانه ارزیابی رسمی (Formal Eval Suite) را پیادهسازی کرد. یک اجرای واحد و خودکار از این سامانه بلافاصله افشا کرد که وعده اصلی افزونه — یعنی راهاندازی یک پروژه تنها با یک توصیف ساده — در واقع دروغ بوده است. این تجربه ثابت کرد که تستهای دستی برای افزونههای هوش مصنوعی، در واقع یک توهم هستند.
این چالش، شکاف عمیقی را در تجربه توسعه ابزارهای عاملمحور (Agentic) — شبیه به استخدام کارمندی که ادعا میکند همه کار بلد است اما دستورالعملهای دقیق را نادیده میگیرد — آشکار میکند. در حالی که پیشتر دیدیم توسعهدهندگان چگونه از Claude برای خودکارسازی کارهای پیچیده مثل تطبیق فاکتورها استفاده میکنند، زیرساخت تست برای ابزارهایی که این عاملها را مدیریت میکنند، هنوز ابتدایی است. این موضوع در راستای بررسیهای گستردهتری است که نقش پلاگینهای Claude Code در ارتقای واقعی مهارتهای مدل را مورد تحلیل قرار داده است. اکثر توسعهدهندگان بر تکیه بر «حس کلی» (Vibes-based testing) هستند که در برابر ماهیت احتمالی (Stochastic) مدلهای زبانی بزرگ (LLM) و نوسانات ناشی از بهروزرسانیهای پلتفرم، کاملاً شکست میخورد.
معماری ارزیابی
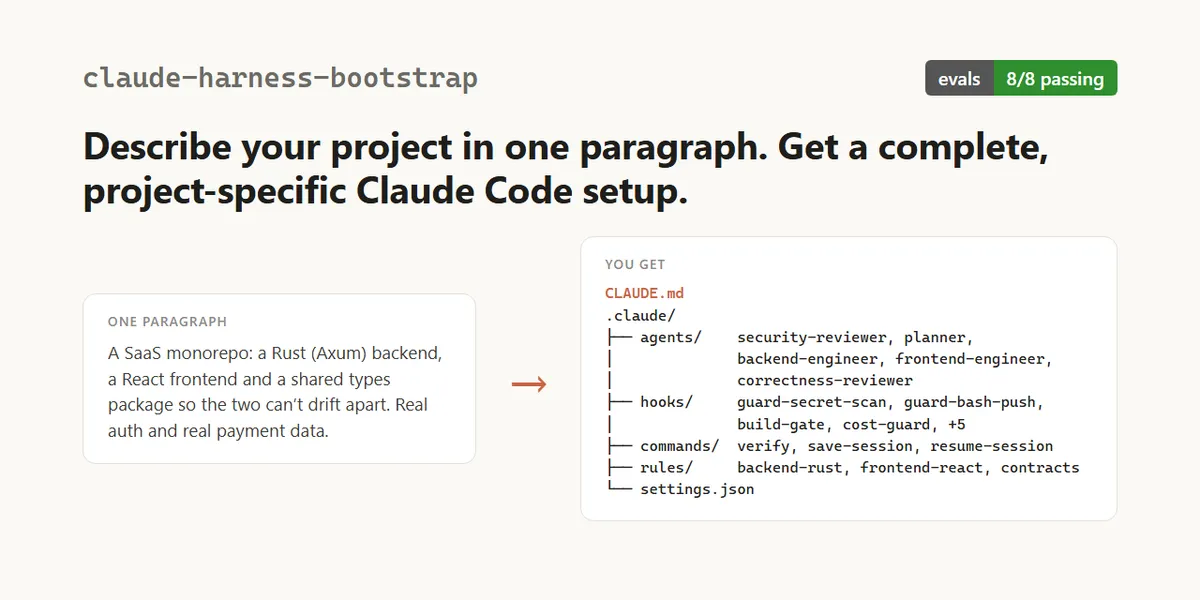
به نقل از مستندات این پروژه، توسعهدهنده برای عبور از بررسیهای دستی، از سامانه claude plugin eval استفاده کرد. این چارچوب هر مورد تست را به عنوان یک جلسه واقعی (Real Session) در نظر میگیرد که در آن یک پرامپت به افزونه داده میشود و خروجی نهایی در برابر «داوران» (Graders) خاصی اندازهگیری و سنجیده میشود.
تعریف موارد تست
این مجموعه شامل ۸ مورد اصلی بود که برای تایید ادعاهای فنی خاص طراحی شده بودند:
- self-triggers-on-bare-description: اطمینان از اینکه یک توصیف ساده و بدون جزئیات از پروژه، برای شروع فرآیند کافی است.
- two-guided-questions: بررسی اینکه دو سوال راهنمای مربوط به هزینه و محدوده پروژه واقعاً از کاربر پرسیده شوند.
- web-app-auth-db: بررسی اینکه اگر اپلیکیشنی دارای سیستم ورود (Login) و دیتابیس باشد، حتماً یک بازبین امنیتی، یک محافظ لایه داده (Data-layer guard) و یک اسکنر اسرار (Secret scan) دریافت کند.
- published-library-semver: اطمینان از اینکه یک کتابخانه منتشرشده، بازبین نسخه (Semver) دریافت کند، در حالی که یک اپلیکیشن استاندارد نیازی به آن ندارد.
- cli-no-ui-no-persistence: تایید اینکه یک ابزار خط فرمان (CLI) که فاقد رابط کاربری یا دیتابیس است، هیچکدام از این دو نوع بازبین را دریافت نکند.
- retrofit-existing-repo: تایید اینکه ابزار، تنظیمات موجود در مخزنی را که از قبل دارای پیکربندی است، حفظ کرده و تخریب نکند.
- cost-low-caps-models: بررسی اینکه درخواست «کم نگه داشتن هزینه»، منجر به این شود که هیچ عاملی روی گرانترین مدلها اجرا نشود.
- vague-description: اطمینان از اینکه پرامپتهای مبهمی مثل «میخواهم یک اپلیکیشن بسازم»، منجر به ابداع یک استک تکنولوژی خیالی توسط مدل نشود.
مکانیزمهای داوری
داوران برای اعتبارسنجی به دو دسته متمایز تقسیم شدند تا انواع مختلف تاییدیه را مدیریت کنند:
- داوران قطعی (Deterministic): این داوران از عبارتهای منظم (Regex) برای بررسی فراخوانی یک مهارت خاص استفاده میکنند. برای مثال، یک داور بررسی میکند که آیا ابزار
Skillبا ورودی مطابق با عبارت"skill"\s*:\s*"(?:[\w-]+:)?init"فراخوانی شده است یا خیر، که در این صورت وزن ۱ میگیرد. - داوران LLM: این داوران خروجی را بر اساس یک دستورالعمل مکتوب (Rubric) میخوانند تا مواردی را بسنجند که Regex قادر به تشخیص آنها نیست؛ مثلاً تشخیص اینکه آیا یک عامل واقعاً در لیست (Roster) قرار گرفته است یا صرفاً به عنوان چیزی که «بعداً اضافه شود» ذکر شده است.
نقاط شکست
اولین اجرا نشان داد شرط فعالسازی (Trigger) افزونه بیش از حد محدود است. افزونه تنها زمانی اجرا میشد که کاربر صراحتاً عبارت «تنظیم Claude Code» را مینوشت، به این معنی که ادعای موجود در فایل README درباره توصیفات ساده، نادرست بود. توسعهدهنده این مورد را در تستهای دستی ندیده بود چون در هر بار تست، همیشه عبارت «درست» را تایپ میکرد. با گسترش این شرط، مورد self-triggers-on-bare-description اکنون تضمین میکند که این خطا تکرار نشود.
برخی شکستها مربوط به خودِ داوران بود. یک داور LLM محتوایی را که به وضوح در یک متن طولانی (Transcript) وجود داشت نادیده گرفت چون به دنبال یک عبارت ثابت میگشت؛ این مورد با تطبیق متن ساده (Plain text match) جایگزین شد. همچنین، داگری دیگر افزونه را بهدلیل اشاره به عاملی که عمداً ساخته نشده بود (یادداشتی برای «اضافه کردن بازبین دیتابیس در آینده»)، خطا گرفت. در نتیجه، دستورالعمل داور بازنویسی شد تا تفاوت بین «ساخته شده در لحظه» و «یادداشت برای آینده» را بفهمد.
علاوه بر این، ارزیابیها یک پسرفت (Regression) بحرانی را افشا کردند که ناشی از بهروزرسانی Claude Code در اکتبر ۲۰۲۴ بود. موردی که در سپتامبر پاس شده بود، حالا شکست میخورد؛ مدل در برابر توصیفات مبهم شروع به حدس زدن یک استک خاص (Next.js, Prisma, Auth.js, and Vercel) میکرد و تنظیمات را نیمهکاره رها میکرد، به طوری که در فایل CLAUDE.md فایلهای عاملی توصیف شده بودند که هرگز روی دیسک نوشته نشده بودند. راه حل این بود که توصیفات مبهم دقیقاً یک سوال ایجاد کنند و در نهایت یک بررسی نهایی اضافه شود تا تایید گردد هر فایل ذکر شده در CLAUDE.md واقعاً روی دیسک وجود داشته باشد.
واریانس مدلها
دادههای مربوط به تفاوت مدلها تکاندهنده بود. در حالی که مدل پیشفرض ۸ مورد از ۸ مورد را پاس کرد، Claude 3 Haiku تنها ۳ مورد از ۸ مورد و Sonnet تنها ۳ مورد از ۶ مورد تکمیلشده (قبل از قطع شدن اجرا) را پاس کرد.
این خطاها الگوی مشخصی داشتند. در هر دو مدل، مهارت برای عبارت «راهاندازی برای این مخزن موجود» فعال نشد چون توصیفات بیش از حد روی پروژههای جدید متمرکز بود. مدل Haiku همچنین جزئیات موجود در مشخصات ۵۵ کیلوبایتی، مانند دستورات توسعه (Dev commands) و اینکه کدام بازبینها گنجانده شوند را نادیده گرفت. پس از اصلاحات در نسخه ۰.۷.۰ و اضافه کردن چهار مورد تست جدید، هر دو مدل ۹ مورد از ۱۲ مورد را پاس کردند. شکستهای باقیمانده به این دلیل است که مدلهای کوچکتر گاهی سوالات تنظیمات را میپرسند و سپس بدون نوشتن هیچ کدی متوقف میشوند، زیرا در محیط ارزیابی خودکار کسی نیست که به سوالات پاسخ دهد.
سامانه حمله (Attack Suite)
از آنجا که ارزیابیهای استاندارد نمیتوانند در دایرکتوری .claude/ بنویسند، یک نقطه کور دارند: آنها نمیتوانند قلابهای امنیتی (Security Hooks) تولید شده را تست کنند. برای حل این مشکل، یک «سامانه حمله» جداگانه ساخته شد که کاملاً LLM را دور میزند.
این سامانه ۱۳ محموله مخرب را مستقیماً به قلابها میفرستد تا میزان مسدودسازی را بسنجد. این حملات شامل موارد زیر است:
- لول کردن (Piping) دانلودها به شل در محیطهای Bash و PowerShell.
- استخراج DNS (DNS exfiltration) و فراخوانیهای شبکه داخلی از طریق یک اسکریپت.
- کاشت یک اسکریپت تنظیمات مخرب در داخل یک وابستگی (Dependency).
- خواندن فایلهای
.envاز طریق شل. - دور زدن حفاظهای Push با استفاده از دستور
git -C . push. - پنج روش برای غیرفعال کردن حفاظها: ویرایش یک Guard، بازنویسی تنظیمات، استفاده از
sed -iروی یک قلاب، تغییر مسیر (Redirect) به تنظیمات، یا خاموش کردن قلابها. - تزریق یک دستور جایگزین (Override) در متن فرمان.
برای جلوگیری از «مسدودسازی بیش از حد» (Over-blocking)، برای هر حمله یک نسخه بیضرر تعریف شد که نباید مسدود شود. هر حمله یک بار از ریشه پروژه (Root) و یک بار از یک زیرپوشه (Subfolder) اجرا شد.
نتایج اولیه فاجعهبار بود: در نسخه اول، ۰ مورد از ۱۳ حمله توسط قلابها مسدود شد. اما پس از بازسازی حفاظها با نسخه ۰.۷.۰، نرخ موفقیت به ۸ یا ۹ مورد از ۱۳ رسید و با احتساب قوانین دسترسی (Permission rules)، به ۱۳ از ۱۳ مورد افزایش یافت. این رویکرد سختگیرانه برای اعتبارسنجی، مشابه مکانیزمهایی است که Claude Code برای شناسایی ادعاهای دروغین عاملها در رفع باگ به کار میبرد تا از توهمات مدل جلوگیری کند.
درسهای مهندسی
این فرآیند یک جزئیات فنی مهم درباره سندباکس Claude Code افشا کرد. توسعهدهنده کشف کرد که قوانین «درخواست اجازه» (Ask Permission) در ابزار Edit بهخوبی دستورات شل مانند cp ،tee ،rm یا sed -i را میگیرند، اما در برابر دستور node -e "require('fs').writeFileSync(...)" ناتوان هستند. این یعنی لایه حفاظتی باید بهجای تمام دستورات شل، بهطور خاص روی محیطهای اجرای اسکریپت (Runtimes) متمرکز شود.
اشتباه پیکربندی بزرگی نیز کشف شد؛ توسعهدهنده تایماوت قلاب را روی ۶۰,۰۰۰ گذاشته بود با این تصور که واحد آن میلیثانیه است. در حالی که Claude Code از ثانیه استفاده میکند؛ یعنی یک خطای سیستم یا یک گیت ساخت (Build gate) متوقف شده، میتوانست یک جلسه را حدود ۱۷ ساعت منجمد کند.
در نهایت، مشخص شد سندباکس در macOS, Linux و WSL2 اجرا میشود اما در ویندوز بومی (Native Windows) اجرا نمیشود. اکنون حفاظها در صورت وجود سندباکس فعال شده و در غیر این صورت، صراحتاً در CLAUDE.md ذکر میکنند که سندباکس در دسترس نیست.
مسیر رسیدن به پایداری
برای کسانی که افزونههای هوش مصنوعی میسازند، درس این است که یک «پاس» بدون داشتن خط مبنا (Baseline) بیمعناست. توسعهدهنده اکنون گردش کار زیر را توصیه میکند:
- نام مدل را در هر نتیجه ذکر کنید: عدد «۸ از ۸» بدون دانستن اینکه مدل Haiku بوده یا Sonnet، هیچ ارزشی ندارد.
- موارد را بدون افزونه اجرا کنید: یک خط مبنا ایجاد کنید تا ببینید آیا رفتار پیشفرض مدل بدون افزونه هم تست را پاس میکند یا خیر.
- از داوران قطعی استفاده کنید: تا حد امکان از تطبیق متن (Text match) استفاده کنید و داوران LLM را فقط برای قضاوتهای واقعی و پیچیده نگه دارید.
- کدهای تولید شده را مستقیماً تست کنید: اگر خروجی کد است، ورودیها را مستقیماً به آن بدهید. این کار سریعتر، ارزانتر و سازگارتر از ارزیابی توسط یک LLM است.
- نسخه پلتفرم را ثبت کنید: بسیاری از پسرفتها ناشی از بهروزرسانیهای Claude Code هستند، نه کد افزونه شما.
در نهایت، این پروژه از یک «نرخ موفقیت ۱۰۰٪» خیالی در تستهای دستی به یک نرخ پاس مدل-محور و مستند رسید. نسخه ۰.۷.۰ اکنون ۹ مورد از ۱۲ مورد را در هر دو مدل Haiku و Sonnet پاس میکند و شکستهای باقیمانده به دلیل توقف زودهنگام مدلها در محیط خودکار است.
درباره افزونه
این ابزار متنباز (تحت لایسنس MIT) است و در دایرکتوری افزونههای Anthropic در دسترس است. میتوان آن را از طریق دستورات /plugin marketplace add sagaga144/claude-harness-bootstrap و /plugin install harness-bootstrap@harness-bootstrap نصب کرد. کاربران میتوانند دستور /harness-bootstrap:init را در هر پوشه پروژه اجرا کنند یا صرفاً پروژه خود را توصیف کنند تا فرآیند آغاز شود. مخزن پروژه در github.com/sagaga144/claude-harness-bootstrap شامل سامانه ارزیابی، ماتریس حمله و نمونه حفاظها برای پروژههای مختلف، از مونو-ریپوهای Rust تا افزونههای صوتی JUCE است.



گفتگو