تصور کنید یک مدیر منابع انسانی بخواهد از هوش مصنوعی بپرسد «چند نفر در تیم فروش هستیم؟» یا «ما چند روز مرخصی داریم؟» اما مدل بهجای پاسخ سریع، هر بار ساعتها وقت صرف دانلود کل دایرکتوری شرکت کند. برای اینکه عاملهای هوش مصنوعی حافظه بلندمدت دقیقی داشته باشند، نیاز به چیزی فراتر از یک پایگاه داده ساده است؛ آنها به روشی دقیق برای همگامسازی دادههای سازمانی در حال تغییر نیاز دارند.
در ۷ اکتبر ۲۰۲۶، یکی از توسعهدهندگان پروژه cognee — ابزاری متنباز که دادههای خام را به گراف دانش (Knowledge Graph) تبدیل میکند — یک کانکتور تخصصی برای BambooHR منتشر کرد. cognee در واقع مانند حافظه بلندمدت برای عاملها عمل میکند و به آنها اجازه میدهد در دانش سازمانی جستوجو کنند. این ابزار از «کانکتورها» برای استخراج داده از سرویسهایی مثل Notion, Gmail و Google Drive استفاده میکند تا عاملها بتوانند به پرسشهای خاص سازمانی پاسخ دهند.
بسیاری از کانکتورهای فعلی هوش مصنوعی از استراتژی ناکارآمد «پاکسازی و جایگزینی» (wipe and replace) رنج میبرند؛ یعنی هر بار که اجرا میشوند، کل مجموعه داده را مجدداً دانلود میکنند. این رویکرد باعث اتلاف شدید منابع محاسباتی شده و در صورت قطع شدن همگامسازی، ریسک از دست رفتن دادهها را افزایش میدهد. طبق مستندات این پروژه، پیادهسازی جدید این پارادایم را به سمت بهروزرسانیهای تدریجی (incremental updates) تغییر داده است؛ به این معنا که دایرکتوری منابع انسانی را نه یک فایل ایستا، بلکه جریانی زنده از رویدادها میبیند.
همانطور که در تحلیلهای قبلی ما دربارهی زیرساختهای حافظه عاملها اشاره کردیم، گلوگاه اصلی این سیستمها معمولاً در لایه انتقال داده و لولهکشیهای داده است، نه قدرت استدلال مدل. این چالشها در مدیریت ابزارهای Agentic رایج است، مشابه آنچه در باز کردن کنترل لایهی میانی توسط آنتروپیک برای بهینهسازی ابزارهای کدنویسی مشاهده کردیم.
مکانیزم Change-Feed
توسعهدهنده این ابزار بهجای کپی کردن مدلهای قدیمی کانکتورهای Notion — که هر بار همه چیز را دوباره دانلود میکنند — از نقطه انتهایی Change Feed در BambooHR استفاده کرد. این سازوکار به عامل هوش مصنوعی دقیقاً اعلام میکند که از یک زمان مشخص، کدام کارکنان اضافه، بهروز یا حذف شدهاند.
- استراتژی ادغام (Merge Strategy): این کانکتور از روشی شبیه به Gmail یا Google Drive استفاده میکند. این استراتژی تضمین میکند که رکوردهای تغییرنیافته در گراف دانش دستنخورده باقی بمانند و بهجای پاک شدن، با دادههای جدید ادغام شوند.
- تداوم مکاننما (Cursor Persistence): سیستم برچسب زمانی BambooHR را به عنوان یک مکاننما (Cursor) برای اجرای بعدی ذخیره میکند. نکته کلیدی این است که این مکاننما تنها پس از موفقیت کامل عملیات ذخیره میشود؛ این کار مانع از ایجاد شکاف دادهای در صورت وقوع کرش در میانه مسیر میشود.
- مسیر یکپارچه (Unified Path): با درخواست دادهها از تاریخ ۱۹۷۰-۰۱-۰۱، سیستم هم همگامسازی اولیه (Full Sync) و هم بهروزرسانیهای تدریجی بعدی را از طریق یک مسیر کد واحد اجرا میکند، زیرا در اولین اجرا، تمام کارکنان به عنوان «درج شده» (Inserted) بازگردانده میشوند.
- چرخه حیات کارکنان: کانکتور بهطور خودکار کارکنان حذفشده را پاک میکند و بهطور پیشفرض، افرادی که در BambooHR با وضعیت «غیرفعال» (Inactive) علامتگذاری شدهاند (کارکنان سابق)، از حافظه حذف میشوند.
طراحی با اولویت حریم خصوصی
دادههای منابع انسانی بهشدت حساس هستند. برای جلوگیری از ورود ناخواسته اطلاعات شناسایی شخصی (PII)، این کانکتور از یک «لیست مجاز» (Allowlist) سختگیرانه استفاده میکند. از آنجایی که BambooHR بهطور پیشفرض تنها شناسه (ID) کارکنان را برمیگرداند مگر اینکه فیلدهای خاصی درخواست شود، توسعهدهنده سیستم را بهگونهای طراحی کرد که بهطور پیشفرض خصوصی باشد.
این سیستم تنها فیلدهای امن مانند نام، عنوان شغلی و دپارتمان را درخواست میکند. دادههای حساسی از جمله حقوق، شماره تأمین اجتماعی، تاریخ تولد و آدرس منزل هرگز از API فراخوانی نمیشوند. این رویکرد تضمین میکند که دادههای خصوصی هرگز وارد خط لوله (Pipeline) دادهها نشوند.
مدیریت فایلهای بدون ساختار
در حالی که رکوردهای کارکنان از Change Feed استفاده میکنند، فایلهای شرکتی (مانند PDF، TXT، MD و CSV) چنین قابلیتی ندارند. cognee برای مدیریت این مورد، ابتدا لیست تمام فایلها را میگیرد و آنها را با اجرای قبلی مقایسه میکند تا فایلهای حذفشده را شناسایی کند. برای بهینهسازی عملکرد، سیستم فایلهایی را که محتوای آنها تغییر نکرده است، نادیده میگیرد.
در طول تستها، توسعهدهنده متوجه شد که برخی فایلهای نمونه، مانند یک فایل CSV مربوط به مزایا، حاوی دادههای فردی هستند که لیست مجاز دایرکتوری نمیتوانست از آنها محافظت کند. برای حل این مشکل، گزینه file_categories اضافه شد تا کاربران بتوانند دقیقاً انتخاب کنند کدام پوشههای فایل همگامسازی شوند. علاوه بر این، سیستم بهروزرسانی شد تا بهجای متوقف کردن کل فرآیند در مواجهه با PDFهای خراب، صرفاً یک هشدار صادر کرده و از آنها عبور کند. این دقت در مدیریت ورودیها برای جلوگیری از نقصهای فنی ضروری است، درست مانند مشکل قطع شدن بیصدای اسناد در CogniRunner که نشان داد مدیریت محدودیتهای ورودی چقدر حیاتی است.
چالشهای ویندوز و دیباگ محلی
تستها بهصورت محلی با استفاده از Ollama و مدل llama3.1:8b به همراه nomic-embed-text برای تولید امبدینگها انجام شد تا هزینههای API حذف شود. این مرحله چندین گلوگاه در سطح سیستمعامل ویندوز ۱۱ را آشکار کرد:
- شکست Symlink: در نسخه 0.40.0 اولاما، مانیفست مدلها بهصورت Symlink ذخیره میشوند. ویندوز ۱۱ از دنبال کردن این لینکها امتناع میکرد و در نتیجه با وجود دانلود موفق مدلها، لیست مدلها خالی نمایش داده میشد. جایگزینی Symlinkها با کپیهای واقعی فایل، این مشکل را حل کرد.
- محدودیت مسیر (Path Limits): ذخیرهساز برداری (Vector Store) در Cognee پوشههای بسیار تو در تو ایجاد میکند. مسیر پروژه باعث شد طول مسیر از حد ۲۶۰ کاراکتر ویندوز فراتر رود. این مشکل با انتقال دادهها به یک پوشه ریشه کوتاهتر برطرف شد.
- توهمهای اسکیما (Schema Hallucinations): مدل کوچک 8B گاهی بهجای بازگرداندن دادههای واقعی، توصیف ساختار JSON را برمیگرداند. این مورد با افزودن
LLM_INSTRUCTOR_MODE="json_schema_mode"به فایل.envحل شد.
اعتبارسنجی در دنیای واقعی
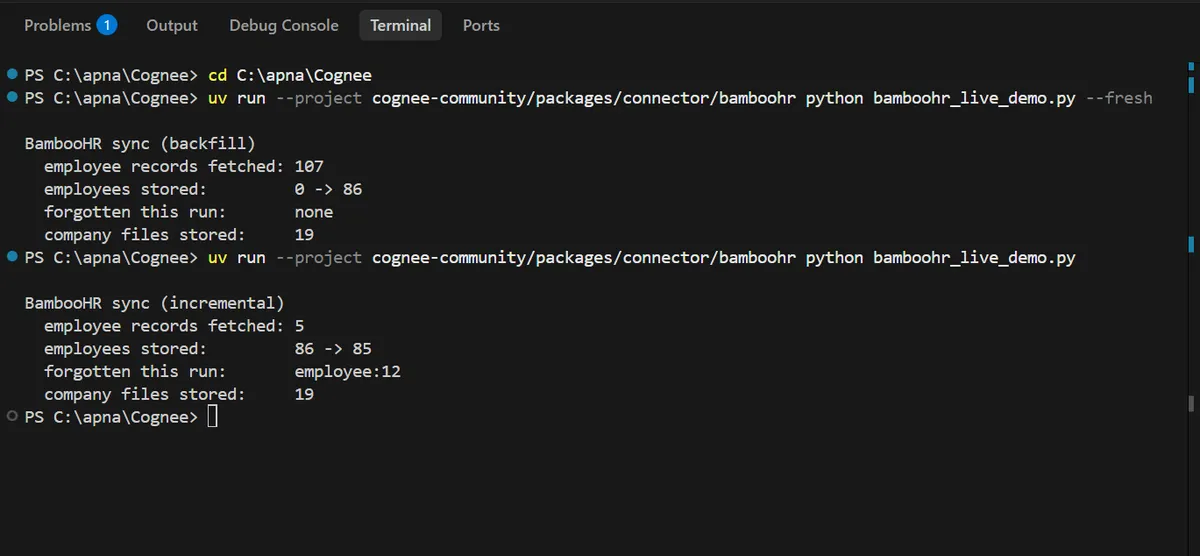
تست روی یک حساب آزمایشی با ۱۱۸ کارمند مجازی و ۲۰ فایل شرکتی، پایداری سیستم را تأیید کرد. توسعهدهنده کانکتور را چهار بار اجرا کرد تا تغییرات را ردیابی کند:
۱. اجرای اول: ۱۰۸ کارمند فراخوانی شدند (نمونههای حذفشده/غیرفعال نادیده گرفته شدند) و ۸۸ مورد ذخیره شدند.
۲. اجرای دوم: ۲۰ کارمند برای اعمال ویرایشها فراخوانی شدند؛ تعداد ذخیرهشدهها ۸۸ نفر باقی ماند.
۳. اجرای سوم: ۵ کارمند فراخوانی شدند؛ یک نفر حذف و یک نفر غیرفعال شد و تعداد ذخیرهشدهها به ۸۷ نفر رسید.
۴. اجرای چهارم: ۲ کارمند فراخوانی شدند که شامل یک مورد غیرفعال شدن بود که در حین اجرای مرحله سوم رخ داده بود؛ در نهایت ۸۶ نفر ذخیره شدند.
این توالی ثابت کرد که ذخیره مکاننما تنها در پایان هر اجرا، مانع از نشت یا گم شدن دادهها میشود. همچنین برای تضمین پایداری برای بازبینها، ۳۳ تست واحد (Unit Test) با استفاده از یک API شبیهسازی شده (Mocked) نوشته شد.
استقرار و یکپارچهسازی
در مرحله ارسال کد (PR)، یک مانع نهایی وجود داشت: مخزن پروژه نیاز به تاییدیه DCO (گواهی منشأ توسعهدهنده) روی هر کامیت دارد. این موضوع مستلزم اجرای git rebase --signoff upstream/main و یک Force-push برای برآورده کردن الزامات CI بود. این سختگیریها در مدیریت نسخهها و کامیتها، تضادهای جالبی با چالشهای نسخهبندی معنایی در کتابخانههای عاملهای هوش مصنوعی دارد که در آن ساختارهای سنتی مدیریت نسخه با ماهیت احتمالی LLMها در تضاد است.
برای تیمهایی که از BambooHR استفاده میکنند، یکپارچهسازی ساده است. پس از اجرای uv sync در پکیج کانکتور، کاربران باید BAMBOOHR_COMPANY_DOMAIN و BAMBOOHR_API_KEY خود را اکسپورت کنند. این پیادهسازی از cognee.remember با پارامتر write_disposition="merge" استفاده میکند تا تضمین شود دادهها بهجای جایگزینی، بهروزرسانی میشوند. کاربران همچنین میتوانند include_inactive=True را ارسال کنند تا اطلاعات کارکنان سابق نیز در گراف حفظ شود.
این پروژه نشان میدهد که گلوگاه عاملهای هوش مصنوعی تنها قدرت استدلال LLM نیست، بلکه لولهکشی خط لوله دادههاست. با اولویت دادن به تحقیق روی API بهجای کدنویسی عجولانه، توسعهدهنده از اشتباه رایج ساخت یک فرآیند همگامسازی تکراری و پرمصرف اجتناب کرد.
برای توسعهدهندگان، این یک درس حیاتی است: طراحی حریم خصوصی در مرحله درخواست اولیه (Initial Request)، بسیار سادهتر از فیلتر کردن دادهها پس از ورود آنها به ذخیرهساز برداری است. اکنون جامعه توسعهدهندگان میتواند دادههای BambooHR را در cognee ادغام کند تا یک حافظه سازمانی پویا و حساس به حریم خصوصی ایجاد نماید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو