اگر امروز برای استقرار یک عامل هوش مصنوعی میجنگید، احتمالاً ساعتها وقت خود را صرف نوشتن دستیِ صدها یا هزاران ارزیابی (Evals) کردهاید و بهطور تدریجی از طریق ویرایش پرامپتها، اصلاح هارنسها و تعریف موارد خاص، عامل را وصله کردهاید تا بالاخره بتواند تعداد کافی از تستها را پاس کند و وارد محیط عملیاتی شود. این جدال حتی برای عاملهایی که بر روی مدلهای تراز اولی مانند Fable و Astra ساخته شدهاند نیز پابرجاست؛ مدلهایی که اغلب در اجرای سازگار و جامع تسکهای پیچیده و سرتاسری (End-to-End) در داخل یک محصول خاص شکست میخورند. علت ریشهای ساده است: عاملهای شما شکست میخورند چون نمیدانند کاربران حرفهای شما واقعاً چطور کارها را پیش میبرند.
در ۱۵ اکتبر ۲۰۲۶، شرکت CopilotKit پلتفرم CLiF را معرفی کرد؛ یک پلتفرم یادگیری مستمر که طراحی شده تا فاصله بین آنچه یک عامل تصور میکند یک وظیفه است و نحوه اجرای واقعی آن توسط انسان را از بین ببرد. این پلتفرم اکنون به عنوان بخشی از CopilotKit Intelligence در مرحله دسترسی زودهنگام (Early Access) قرار دارد.
بیشتر ابزارهای نظارتی (Observability) فعلی تنها منطق داخلی عامل — یعنی پرامپتها و فراخوانی ابزارها — را ردیابی میکنند. آنها به شما نشان میدهند که عامل کجا شکست خورده است، اما مسیر درست را به شما نشان نمیدهند. از سوی دیگر، تحلیلهای محصول (Product Analytics) روی کلیکها، قیفهای فروش و بازپخش جلسات (Session Replays) برای داشبوردهای انسانی تمرکز دارند، نه برای یادگیری ماشین. در اکثر ساختارهای تولیدی عاملها، این دو جریان داده تقریباً هرگز در یک خط زمانی مشترک قرار نمیگیرند.
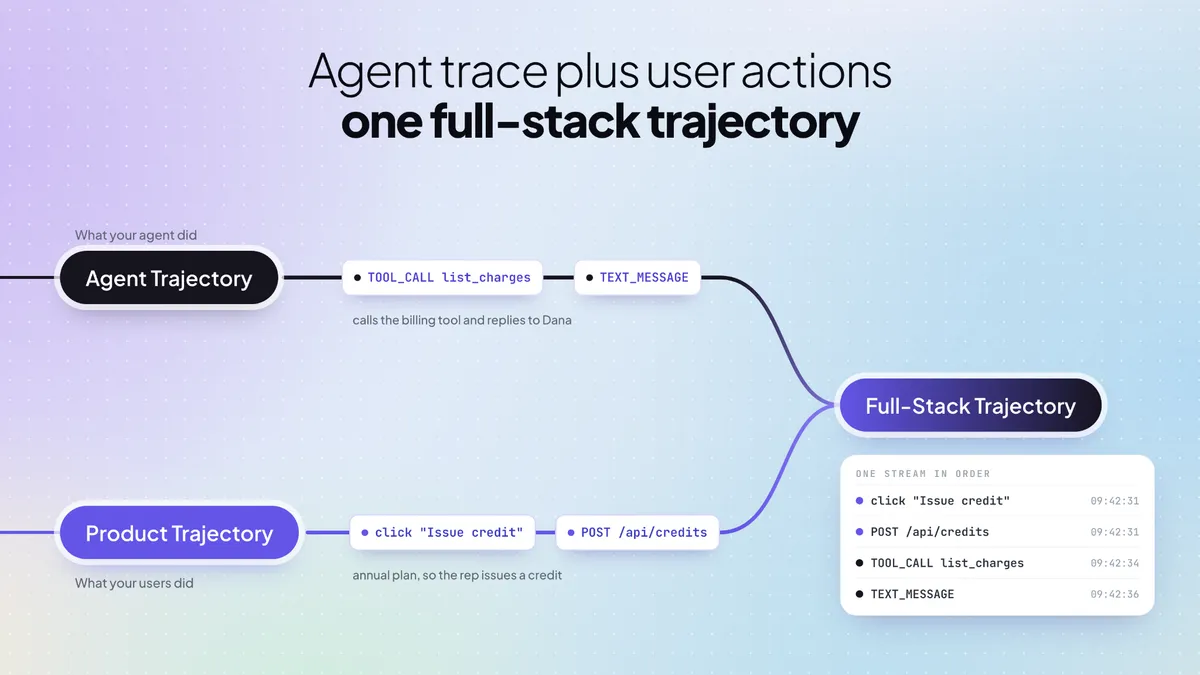
CopilotKit که چارچوب متنباز آن بیش از ۳۸,۰۰۰ ستاره در گیتهاب دارد، استدلال میکند که رفتار کاربر ارزشمندترین مجموعه دادهای است که یک تیم توسعه عامل در اختیار دارد. طبق اعلام این شرکت، CLiF با استفاده از پروتکل AG-UI (تعامل عامل-کاربر)، چیزی را خلق میکند که آنها «مسیر کامل» (Full-stack Trajectory) مینامند.
مکانیزم مسیر کامل
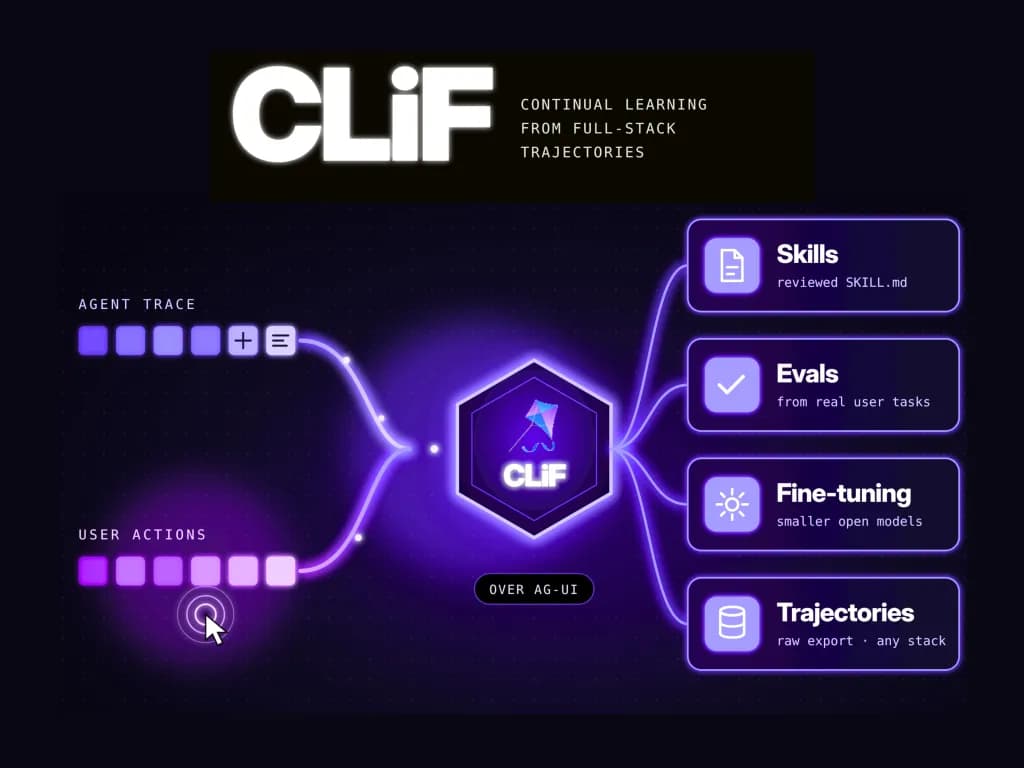
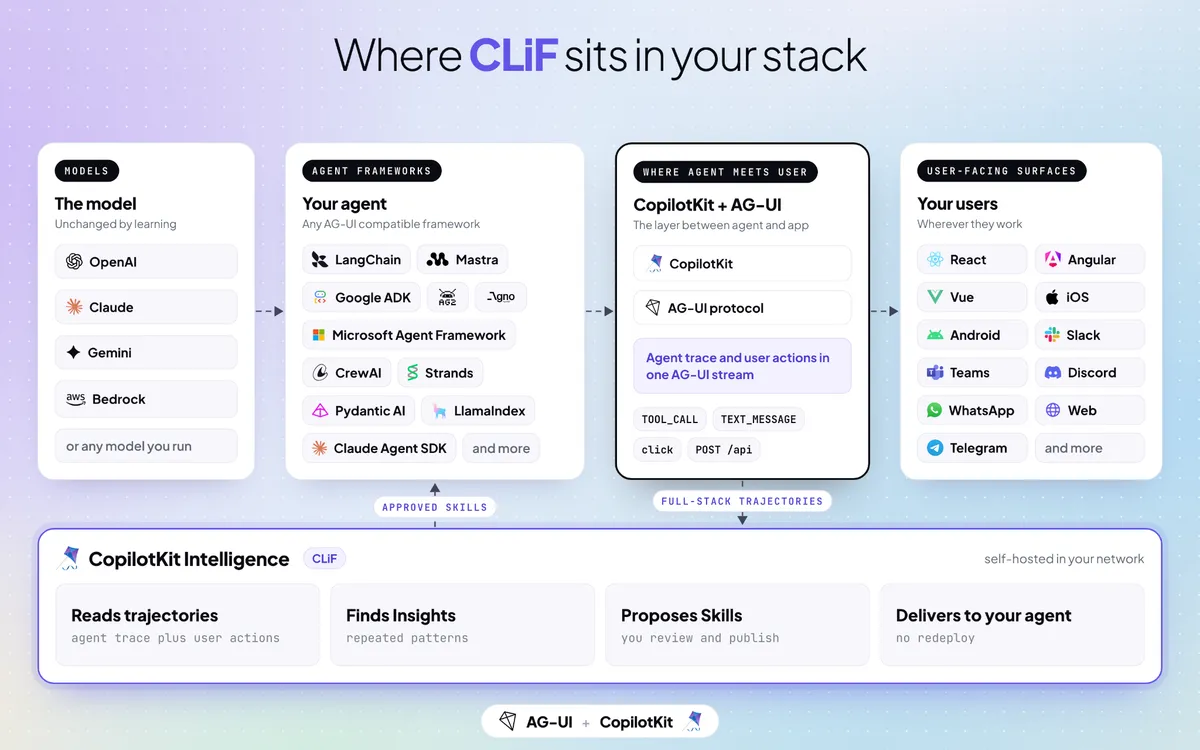
پلتفرم CLiF بر پایه یک مفهوم بنیادین بنا شده است: مسیر کامل. این مسیر از طریق AG-UI ثبت میشود؛ پروتکلی باز که CopilotKit برای اتصال عاملها به اپلیکیشنهای کاربر نهایی ساخته است. چون AG-UI بین عامل و کاربر در هر سطحی قرار دارد، میتواند هر دو سوی یک وظیفه را بهطور همزمان ببیند.
یک مسیر کامل، دو جریان مجزا را در یک رکورد زمانی واحد ترکیب میکند:
- مسیر عامل (Agent Trace): هر اجرا، فراخوانی ابزار، تغییر وضعیت و خروجی مدل که عامل تولید کرده است، به همراه پاسخ دریافتی از هر یک از این موارد.
- مسیر محصول (User Actions): آنچه روی صفحه کاربر بود، دکمههایی که کلیک کرد و درخواستهای سروری که توسط کاربر تحریک شدند.
اگر کاربر در میانه کار با عامل صحبت کند یا آن را اصلاح کند، این گفتگو دقیقاً در همان خط زمانی و به ترتیب وقوع ثبت میشود. این امر نیاز به خط لولههای تحلیلی مجزا برای چسباندن دادهها به یکدیگر پس از وقوع حادثه را از بین میبرد. از آنجایی که AG-UI در حال حاضر رویدادهای عامل را به فرانتاند استریم میکند، ثبت اقدامات کاربر روی همین پروتکل باعث میشود هر دو نیمه از ابتدا در یک جریان قرار گیرند. هر جلسه کاربر به یک مسیر واحد تبدیل میشود که تیمها میتوانند آن را در CopilotKit Intelligence بازپخش کنند و کلیکها، درخواستهای سرور و پیامهای عامل را دقیقاً به ترتیب وقوع مشاهده کنند.
همانطور که در تحلیلهای پیشین ما دربارهی امنیت و نظارت بر مدلهای عاملمحور اشاره کردیم، نبودِ دادههای مرجع از رفتار واقعی کاربر، بزرگترین مانع برای رسیدن به استقرار در مقیاس واقعی است. در این راستا، چالشهای امنیتی در دسترسی به دادهها همواره مطرح است؛ برای مثال، برخی مدلهای اشتراکگذاری داده در پلتفرمهایی مانند Salesforce با فعالسازی دستیاران هوشمند با ریسک نشت اطلاعات مواجه شدهاند.
حلقه یادگیری چهار مرحلهای
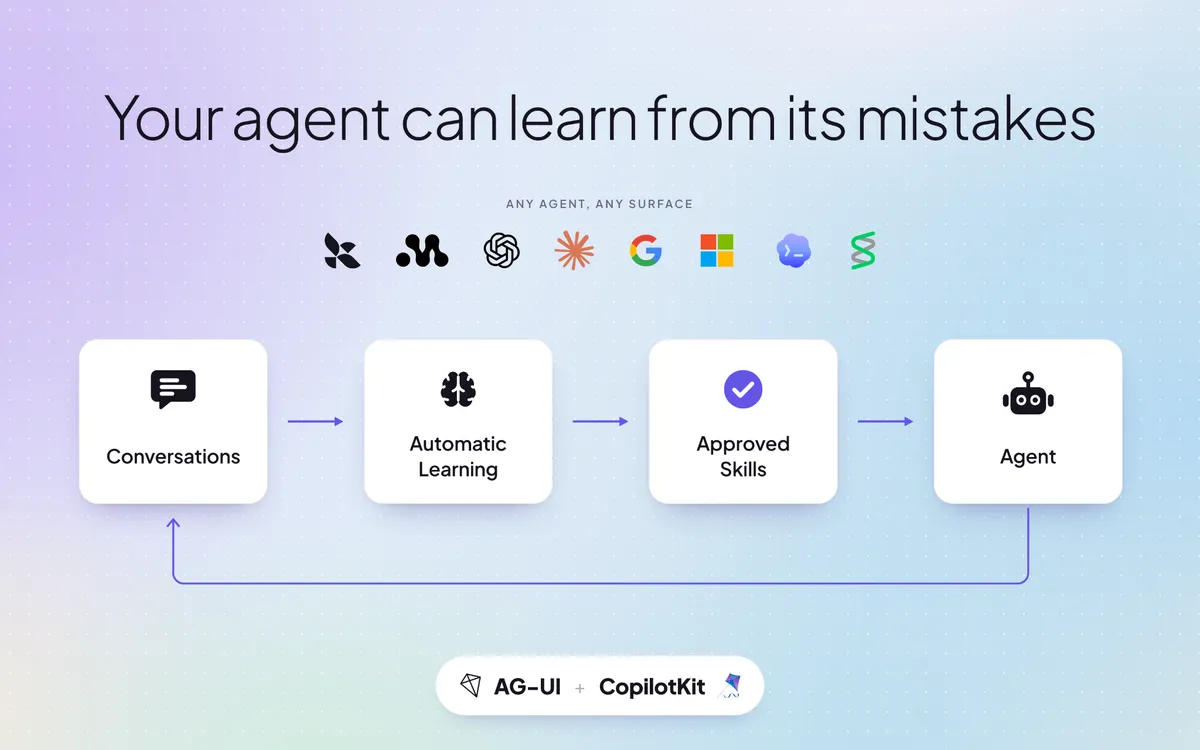
CLiF این مسیرها را از طریق یک خط لوله ساختاریافته پردازش میکند تا عملکرد عامل را بدون نیاز به مهندسی پرامپت (Prompt Engineering) مداوم و دستی بهبود ببخشد. این حلقه بر پایه سیستم «یادگیری خودکار» (Automatic Learning) در CopilotKit بنا شده است.
۱. ثبت (Capture)
مسیرها به صورت استریم وارد CopilotKit Intelligence شده و به «کانتینرهای یادگیری» اختصاص مییابند. این کانتینرها یادگیری را به یک نوع خاص از کار، مانند پشتیبانی صورتحساب یا آنبوردینگ مشتری، محدود میکنند. محیط زمان اجرا (Runtime) کانتینر مربوط به هر جلسه را از طریق کالبک getTrajectoryLearningContainerIds انتخاب میکند. جلسات میتوانند بعداً از طریق رابط کاربری Intelligence به یک کانتینر منتقل شوند یا از آن خارج گردند و هر کانتینر فقط از جلسات مربوط به خود یاد میگیرد.
۲. یافتن الگوها (Find Patterns)
تحلیلها بهطور زمانبندی شده، زمانی که یک کانتینر از حد نصاب مشخصی از جلسات جدید عبور کند، اجرا میشوند؛ هرچند تیمها میتوانند آن را بهصورت دستی نیز فعال کنند. هر اجرا بر روی یک اسنپشات منجمد از جلسات کانتینر کار میکند تا «بینشها» (Insights) را استخراج کند. این بینشها شامل موارد زیر است:
- درخواستهای تکراری از سوی کاربران.
- اصلاحات مکرری که کاربران روی خروجی عامل انجام دادهاند.
- نقاط اصطکاکی که کاربران بهطور خاموش آنها را دور میزنند.
CopilotKit این اصطکاکها را قویترین سیگنال میبیند، زیرا تمایل دارد در هزاران جلسه تکرار شود و دقیقاً نشان میدهد که عامل در مرحله بعد باید چه چیزی را بیاموزد. هر بینش به رویدادهای خاص پشت آن استناد میکند و مستقیماً به مسیر منبع لینک میشود.
۳. بررسی (Review)
وقتی شواهد از یک درس تکرارپذیر حمایت میکنند، CLiF آن را به عنوان یک «مهارت» (Skill) پیشنهاد میدهد که در قالب یک فایل متنی ساده SKILL.md نوشته شده است. نکته حیاتی این است که سرویس تحلیل نمیتواند بهتنهایی چیزی را منتشر کند؛ یک انسان باید هر پیشنهاد را در محیط Intelligence UI یا از طریق CopilotKit CLI تأیید یا رد کند. مهارتهای منتشر شده دارای نسخه (Versioned) هستند و میتوان آنها را در هر زمان بازنشسته کرد.
۴. تحویل و خروجی (Deliver and Export)
مهارتهای تأییدشده فوراً و بدون نیاز به استقرار مجدد (Redeploy) به عامل میرسند. تیمهایی که به پایداری بیشتری نیاز دارند، میتوانند عامل را به یک نسخه ثابت از مهارت پین کنند. برای سایر عاملها یا سرورهای MCP، مهارتها را میتوان به عنوان فایلهای ساده با دستور copilotkit skills download <container> –output <dir> دانلود کرد. خودِ مسیرها نیز به عنوان دادههای خام رویداد از داشبورد Intelligence قابل خروجی گرفتن هستند.
یادگیری خودکار و یکپارچگی
CLiF بر پایه یادگیری خودکار بنا شده است که زیربنای عاملهای خود-بهبودبخش در CopilotKit Intelligence است. در حالی که یادگیری خودکار روی گفتگوها تمرکز داشت، CLiF این مفهوم را به مسیرهای محصول — یعنی کارهایی که کاربران مستقیماً در محصول و خارج از محیط چت انجام میدهند — گسترش میدهد.
هر گفتگوی عامل بهطور کامل از طریق AG-UI Streams ذخیره میشود، شامل:
- پیامها و فراخوانی ابزارها.
- رابطهای کاربری مولد (Generative UI) و تغییرات وضعیت.
- تأییدیهها و فایلها.
توسعهدهندگان با بازگرداندن یک شناسه کانتینر از کالبک getLearningContainerId در محیط زمان اجرای CopilotKit، تعریف میکنند که کدام رشتهها (Threads) به عنوان شواهد یادگیری محسوب شوند. برای تیمهایی که عاملهای تولیدی موجود دارند، تاریخچه را میتوان بهجای شروع از صفر، از LangGraph Server یا LangSmith Deployment وارد کرد.
تحویل مهارتها از طریق آداپتورهایی برای موارد زیر مدیریت میشود:
- LangGraph (پایتون و تایپاسکریپت)
- Mastra
- Google ADK
- Microsoft Agent Framework
- عامل داخلی CopilotKit
این آداپتور یک کاتالوگ و دو ابزار اضافه میکند: copilotkit_load_skill و copilotkit_read_skill_file. مدل زمانی که تسک به آن نیاز داشته باشد، مهارت را بارگذاری میکند. برای حفظ ایمنی، دستورات توسعهدهنده اولویت دارند؛ مهارتها نمیتوانند نقش عامل، قوانین ایمنی یا محدودیتهای ابزار را بازنویسی یا نادیده بگیرند. این رویکرد در اتصال به دادههای خارجی مشابه استانداردهای جدیدی است که پروتکل MCP برای فراهم کردن دسترسی IDEها به دادههای زنده B2B ایجاد کرده است تا تعامل مدل با محیط عملیاتی دقیقتر شود.
فراتر از مهارتهای ساده
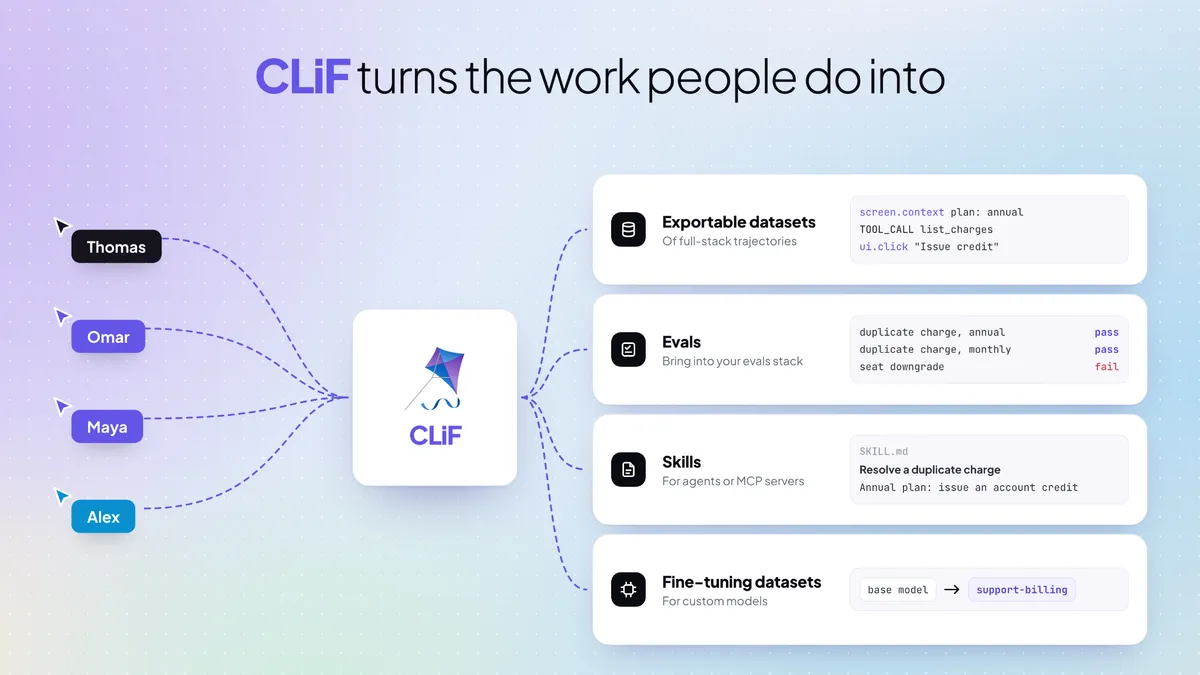
در حالی که مهارتها خروجی اصلی هستند، CLiF چهار دارایی حیاتی برای هوش مصنوعی در محیط تولید ایجاد میکند که همگی قابل انتقال به پشته فعلی تیم هستند:
- مهارتها (Skills): ساخته شده از الگوهایی که در جلسات متعدد تکرار شدهاند، برای استفاده در عاملها یا سرورهای MCP.
- ارزیابیهای مبتنی بر تولید (Production-based Evals): ساخته شده از تسکهایی که کاربران واقعاً انجام دادهاند، شامل ورودیها و لبههای تیز (Edge Cases) که هیچ انسانی به فکر نوشتن دستی آنها نبود. اینها را میتوان به هر پلتفرم ارزیابی موجود صادر کرد.
- مجموعه دادههای تنظیم دقیق (Fine-tuning Datasets): استخراج شده از مسیرهای واقعی تسکها برای آموزش مدلهای باز، کوچکتر و سریعتر روی پرتکرارترین گردشکارهای شرکت.
- مسیرهای خام (Raw Trajectories): دادههای رویداد کامل-پشته که میتوان آنها را به هر پلتفرم نظارتی صادر کرد یا به هر نحوی که تیم بخواهد به کار برد.
کاربرد عملی: بستن اسپرینت
تصور کنید مدیر فنی (CTO) یک پلتفرم مدیریت پروژه مشابه Linear هستید. میخواهید عاملها بتوانند کارهای روتین را بهطور قابلاعتمادی انجام دهند، چه عامل داخلی شما باشد و چه عاملهای خارجی مانند Claude که از طریق سرور MCP شما متصل شدهاند. «بستن اسپرینت» یکی از تسکهای اولویتدار است.
پلتفرم شما یک گزینه یککلیکی برای انتقال مسائل ناتمام به اسپرینت بعدی دارد و مستندات شما بستن اسپرینت را به همین شکل توصیف میکنند. در نتیجه، عاملی که از او خواسته شود یک اسپرینت را ببندد، صرفاً هر مسئله ناتمام را به جلو منتقل میکند.
اما وقتی CLiF مسیرهای محصول را ثبت میکند، هزاران مورد بستن اسپرینت فاش میکنند که مدیران تیمهای انسانی کارهای بیشتری انجام میدهند:
۱. آنها از گزینه یککلیکی استفاده میکنند.
۲. مسائلی را که قبلاً یکبار منتقل شدهاند، دوباره به بکلاگ برمیگردانند و مسئولیت آنها را لغو میکنند (Unassign).
۳. روی مسائل مسدود شده کامنت میگذارند و مسئولِ ایجاد مسدودیت را تگ میکنند.
هیچکس در تیم این روتین را طراحی نکرده بود و کاربران هم بهندرت آن را توصیف میکنند. این رفتار فقط در کلیکها و درخواستهایی وجود دارد که پس از انتقال یککلیکی رخ میدهد. ردپای عامل (Agent Traces) هرگز این را نمیبیند چون کاربران خودشان آن را انجام میدهند، و تحلیلهای محصول هم کلیکها را بدون درک معنای پشت آنها ثبت میکنند. شناسایی این الگو در بازپخش جلسات به معنای تماشای هزاران ویدیو بود.
CLiF این روتین را به عنوان یک بینش (Insight) شناسایی کرده و یک مهارت پیشنهاد میدهد. پس از بررسی و انتشار، عامل داخلی بدون نیاز به استقرار مجدد آن را دریافت میکند و همان مهارت از طریق سرور MCP ارسال میشود تا Claude نیز از آن پیروی کند. این جلسات همچنین به موارد ارزیابی (Eval Cases) تبدیل میشوند تا تأیید شود عامل دقیقاً مانند یک مدیر تیم انسانی رفتار میکند. همچنین اگر بعداً بخواهید یک مدل کوچکتر را برای برنامهریزی کارها تنظیم دقیق کنید، اینها به دادههای آموزشی تبدیل میشوند.
حل مشکل مقیاسپذیری
برای رهبران فنی، CLiF چندین درد سیستماتیک در استقرار عاملها را درمان میکند:
- عبور از ارزیابیها: برای اکثر تیمها، کندترین بخش عرضه محصول، رساندن عامل به مرحلهای است که تعداد کافی از ارزیابیها را در گردشکارهای حیاتی پاس کند. مهارتهای آموختهشده از اجرای واقعی کاربران، گامهای گمشده را فراهم میکنند. ارزیابیهای مبتنی بر تولید، لبههای واقعی دنیای واقعی را اضافه میکنند و اجازه میدهند مجموعه تستها همگام با میزان استفاده رشد کنند.
- جلوگیری از تورم بستر و اضافه بار ابزارها (Context Bloat): هر اشتباه عامل معمولاً با اضافه کردن یک قانون دیگر به پرامپت سیستمی یا یک ابزار جدید به پایان میرسد. با گذشت زمان، بستر (Context) پر شده و رفتار مدل غیرقابل پیشبینی میشود. CLiF رفتارهای آموختهشده را در یک کاتالوگ مهارت نگه میدارد؛ مدل مهارت را فقط زمانی بارگذاری میکند که نیاز باشد.
- کاهش هزینه: با رشد پرامپتها، هزینه عاملها افزایش مییابد. مجموعهدادههای تنظیم دقیق از مسیرهای واقعی به تیمها اجازه میدهد گردشکارهای با حجم بالا را به مدلهای باز، کوچکتر و ارزانتر منتقل کنند. کانتینرهای هر گردشکار دقیقاً نشان میدهند عامل در کجا دچار مشکل است.
- یکپارچگی در پشتههای پراکنده: سازمانهای بزرگ از چارچوبهای مختلف عامل در وباپها، موبایل، Slack و Teams استفاده میکنند. CLiF روی AG-UI اجرا میشود و آن را با هر مدل یا هارنس عاملی سازگار میکند. AG-UI توسط گوگل، مایکروسافت، آنتروپیک، آمازون و اوراکل و همچنین چارچوبهایی مانند LangChain، Mastra و Pydantic AI پشتیبانی میشود.
- نظارت بر هوش مصنوعی سایه (Shadow AI): وقتی تیمها بهطور مستقل از ابزارها استفاده میکنند، سخت است بدانیم عاملها چه چیزهایی آموختهاند. هر مهارت CLiF نیاز به بررسی انسانی دارد، به جلسات منبع ردیابی میشود و دارای نسخه است و قابل بازگشت میباشد.
میزبانی شخصی برای امنیت و حاکمیت
برای تضمین امنیت و حاکمیت دادهها، CLiF بهطور کامل قابلیت میزبانی شخصی (Self-hostable) دارد. CopilotKit Intelligence میتواند روی خوشه کوبرنتیز (Kubernetes) شرکت از طریق Helm Chart، یا روی AWS ECS و Fargate مستقر شود. این سیستم با Postgres، Redis و ارائهدهندگان هویت مانند Okta، Azure AD یا Keycloak یکپارچه میشود.
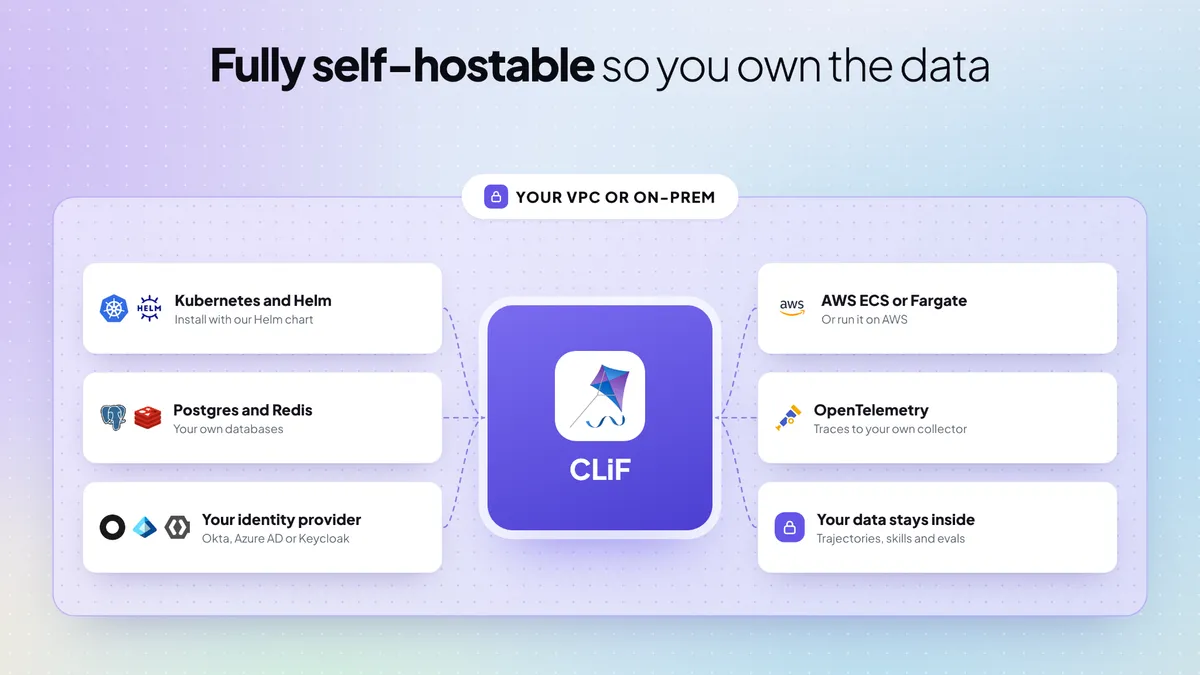
مسیرها، مهارتها و تمام دادههای آموختهشده در محیط VPC یا محیطهای درونسازمانی شرکت میمانند. فعالیتهای کاربر و ردپاهای عامل هرگز شبکه را ترک نمیکنند، هرچند ردپاها همچنان میتوانند به یک جمعکننده OpenTelemetry موجود جریان یابند. برای تیمهایی که سریعترین راه را میخواهند، نسخه ابری مدیریتشده نیز در دسترس است.
این تغییر، توسعه عاملها را از چرخه «حدس بزن، پرامپت بنویس و تست کن» به یک حلقه دادهمحور «مشاهده کن، یاد بگیر و اصلاح کن» تبدیل میکند.
اگر شما یک ناوگان از عاملها را مدیریت میکنید، گام بعدی این است که پشته نظارتی خود را بازرسی کنید تا ببینید آیا اقدامات کاربر را در کنار ردپای عامل ثبت میکنید، یا اینکه در مورد «مسیر درست» کاملاً کور هستید.



گفتگو