تصور کنید بتوانید به جای دعا کردن برای جای درست یک شیء در تصویر، دقیقاً مختصات آن را تعیین کنید. با معرفی FLUX.3 Image Klein، دوران «شانس» در ترکیببندی تصاویر هوش مصنوعی به پایان رسید و جای خود را به کنترل مهندسیشده داد.
بیشتر مدلهای تولید تصویر، ترکیببندی را مانند یک بازی احتمالات میبینند و کاربر باید با صفتهای توصیفی سعی کند مدل را به سمت چیدمانی خاص سوق دهد. در حالی که نسخههای قبلی خانواده Flux در پیروی از پرامپت پیشرفت کرده بودند، اما فاقد مکانیزمی برای جایگذاری دقیق در سطح پیکسل بودند. مدل جدید این مشکل را با اجازه دادن به کاربران برای تعریف مناطق خاص تصویر در مقیاس نرمالشده ۰ تا ۱۰۰۰ حل کرده است.
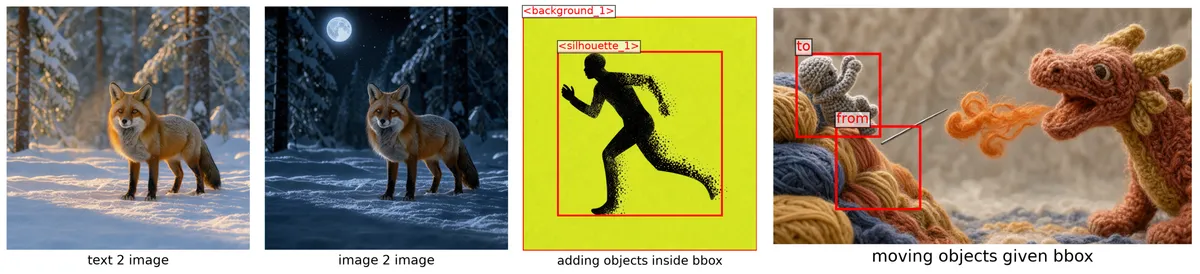
به نقل از مستندات فنی Hugging Face، این مدل در سه جریان کاری اصلی فعالیت میکند:
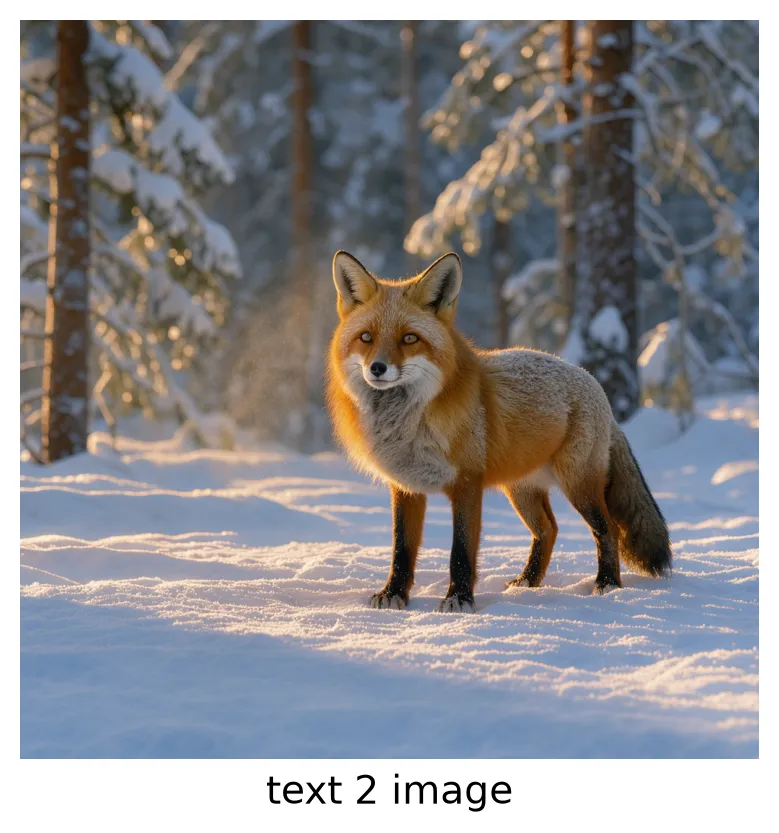
- تبدیل متن به تصویر (Text-to-Image): تولید تصاویر با کیفیت بالا از توصیفات کامل صحنه. یک نسخه تقطیرشده (Distilled) میتواند تصویری با ابعاد ۱۰۲۴ در ۱۰۲۴ را در حدود ۲ ثانیه روی پردازنده NVIDIA H100 تولید کند.
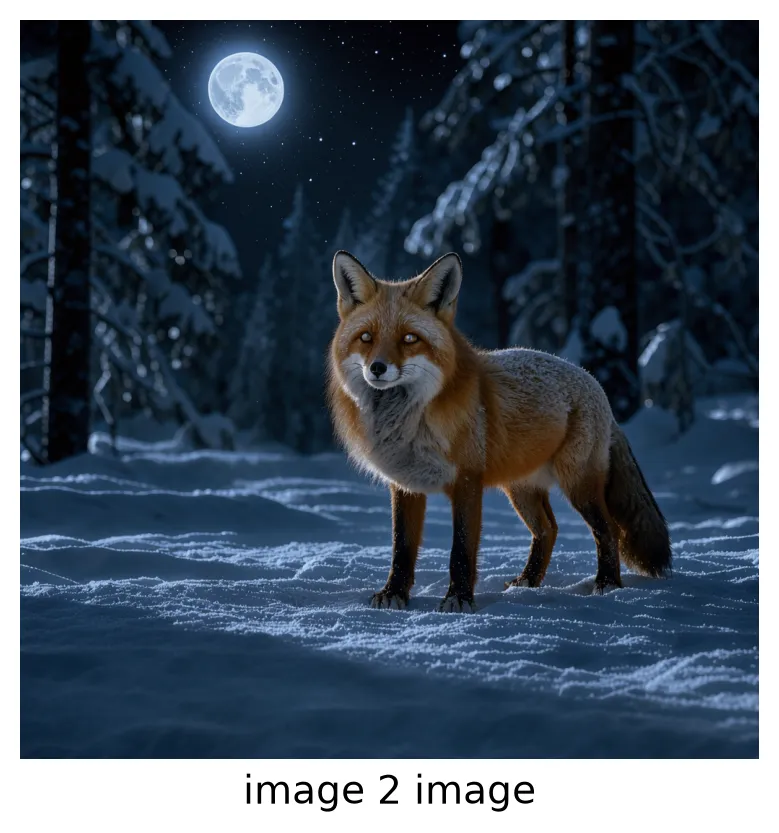
- تبدیل تصویر به تصویر با چند مرجع (Multi-Reference Image-to-Image): کاربران میتوانند یک یا چند تصویر مرجع را ارسال کنند. مدل میتواند عناصری از منابع مختلف — مثلاً یک روباه خاص از یک عکس و یک نیمکت چوبی از عکسی دیگر — را در یک صحنه واحد ترکیب کند.
- کنترل چیدمان (Layout Control): با افزودن یک لیست JSON از مناطق بعد از کپشن، کاربر برای هر عنصر یک جعبه محصور (Bounding Box یا bbox) و یک توصیف (desc) تعیین میکند.
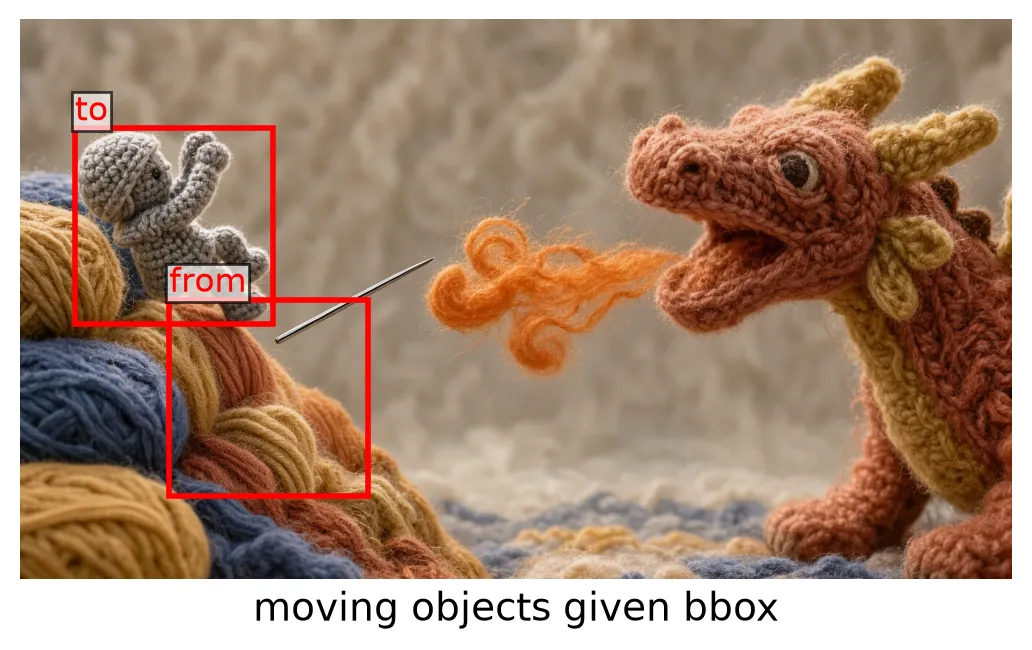
همانطور که در تحلیلهای پیشین ما دربارهی تکامل مدلهای انتشار (Diffusion Models) اشاره کردیم، حرکت به سمت کنترلپذیری (Controllability) اولویت اصلی صنعت است. این رویکرد در واقع تکاملیافتهی نبردهای اخیر بر سر ویرایش موضعی تصاویر است که در آن مدلهای پیشرو تلاش میکردند دقت بیشتری در تغییرات جزئی داشته باشند. در این مدل، یکی از مهمترین قابلیتها، توانایی جابهجایی اشیای خاص در یک تصویر مرجع است. با تعریف یک جعبه محصور مبدأ (src_bbox) و یک جعبه مقصد (tgt_bbox)، مدل میتواند شیء را جابهجا کند در حالی که بقیه صحنه بدون تغییر باقی میماند.
در این سازوکار، اگر جعبه مبدأ و مقصد یکسان باشند، شیء ثابت میماند. این یعنی شما میتوانید یک شوالیه کوچک بافتنی را روی یک صخره از کاموا به سمت چپ و بالا حرکت دهید، در حالی که پسزمینه، سوزن، اژدها و آتش در جای خود میخکوب شوند.
این دقت به دلیل استفاده از یک سیستم بردار معنایی (Embedding) موقعیتی چهاربعدی (زمان، ارتفاع، عرض و طول توالی) است. این سیستم به مدل درک دقیقی از مفهوم «همان نقطه» در تصاویر مختلف میدهد.
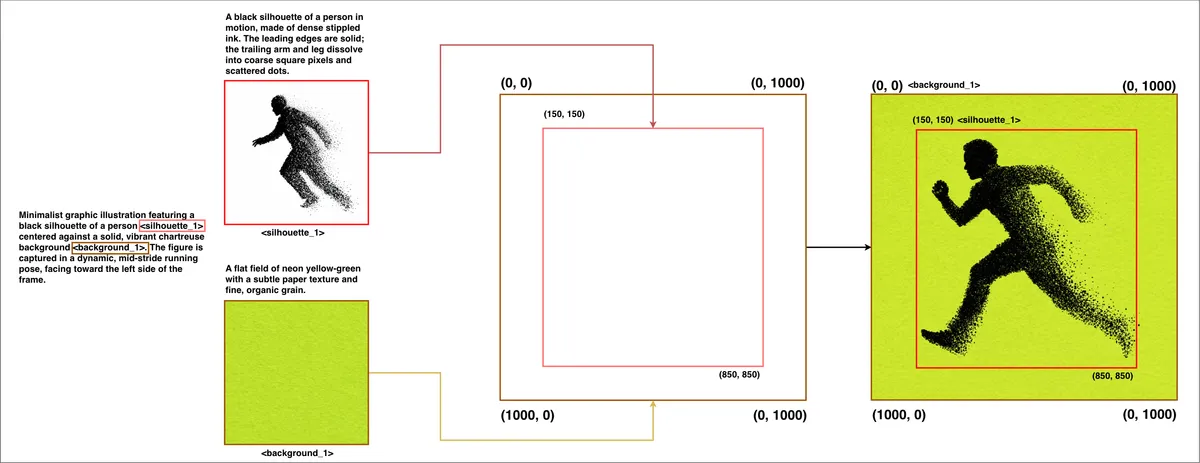
برای پیادهسازی کنترل چیدمان، کاربران لیستی از JSON را ارائه میدهند که هر منطقه شامل یک شناسه، یک bbox و یک توصیف است. مختصات به صورت [y_min, x_min, y_max, x_max] نوشته میشوند و چون مقیاس ۰ تا ۱۰۰۰ نرمالشده است، مختصات در هر اندازه تصویری یکسان عمل میکنند.
طبق گزارش توسعهدهندگان، برای شروع کار به آخرین نسخههای کتابخانههای diffusers و transformers نیاز است تا از رمزگذار متنی Qwen3-VL پشتیبانی شود. برای بارگذاری نسخه تقطیرشده از ModularPipeline استفاده میشود که با dtype=torch.bfloat16 روی CUDA اجرا میگردد.
از نظر معماری، FLUX.3 از یک مدل جریان در فضای نهان (Latent-space flow model) استفاده میکند. یک خودرمزگذار وردشی (VAE) تصاویر را در هر جهت ۸ برابر فشرده کرده و هر پچ ۲ در ۲ از آن نهان را در یک توکن (Token) — شبیه برشهای کوچک یک کیک که مدل تکهتکه میخورد — با ۱۲۸ کانال بستهبندی میکند. این فرآیند یک تصویر ۱۰۲۴ در ۱۰۲۴ را به شبکهای ۶۴ در ۶۴ از ۴۰۹۶ توکن تبدیل میکند.
رمزگذار متنی توسط Qwen3-VL تأمین میشود. مدل FLUX.3 به جای استفاده از لایه نهایی، حالتهای پنهان هشت لایه از ۳۶ لایه آن را استخراج و روی هم میچیند تا برداری با ۲۰,۴۸۰ بُعد ایجاد کند.
ترنسفورمر (Transformer) توکنها را در دو مرحله پردازش میکند:
۱. بلاکهای هر-حالت (Per-mode blocks): هر جریان (متن، تصویر نویزی و تصاویر مرجع) از ۵ بلاک با وزنهای اختصاصی عبور میکند تا هر توکن ابتدا بر اساس نوع خود اصلاح شود.
۲. بلاکهای مشترک (Joint blocks): جریانها با هم ادغام شده و از ۲۸ بلاک مشترک عبور میکنند تا تصویر بتواند همزمان از متن و مراجع یاد بگیرد.
در هر بلاک، لایههای توجه (Attention) و MLP به صورت موازی اجرا میشوند. برای حل مشکل جابهجایی توکنها، از رمزگذاری موقعیت دورانی (RoPE) در چهار محور زمان، ارتفاع، عرض و طول توالی استفاده شده است. این دقت در مختصات است که اجازه میدهد src_bbox دقیقاً به tgt_bbox نگاشت شود.
برای دسترسی کاربران بدون سختافزارهای سازمانی، فرمتهای مختلفی ارائه شده است:
- bf16: مدل کامل برای تنظیم دقیق (Fine-tuning).
- fp8r: بهینه شده برای معماریهای Ada، Hopper و Blackwell.
- nvfp4: نسخهای بسیار کوانتیده برای GPUهای Blackwell که مصرف حافظه را به شدت کاهش میدهد.
در یک RTX6000، نسخه nvfp4 حدود ۱۳.۴ گیگابایت حافظه اشغال میکند، در حالی که نسخه bf16 به بیش از ۲۰ گیگابایت حافظه در زمان استنتاج نیاز دارد.
بنچمارکهای زمانی روی یک H100 نشان میدهد که افزودن تصویر مرجع، زمان تولید را تقریباً دو برابر میکند: تولید متن به تصویر ۱.۹۳ ثانیه و ویرایش چیدمان ۴.۱۰ ثانیه زمان میبرد.
این مدل به صورت یک خط لوله Modular Diffusers عرضه شده است. این معماری به توسعهدهندگان اجازه میدهد بلاکهای خاصی را حذف یا جایگزین کنند. برای مثال، میتوان رمزگذار متنی را حذف کرد و از بردارهای ذخیرهشده برای تولید چندین تصویر استفاده کرد تا حافظه VRAM آزاد شود.
همچنین امکان آموزش لورا (LoRA) با اسکریپتهای DreamBooth فراهم است. برای کاهش مصرف حافظه در زمان آموزش، میتوان از تکنیکهایی مثل gradient_checkpointing و use_8bit_adam استفاده کرد.
در نهایت، FLUX.3 یک مدل تطبیق جریان (Flow Matching) است. تولید از نویز خالص شروع شده و در هر مرحله، ترنسفورمر یک «سرعت» یا جهت را پیشبینی میکند تا نویز به تصویر پاک تبدیل شود. این رویکرد در کنار قابلیتهای پیشبینی محیطی در مدلهای وزنباز Black Forest Labs، نشاندهنده حرکت این شرکت به سمت درک عمیقتر از ساختار فیزیکی و محیطی است. به دلیل استفاده از یک جابهجایی زمانی (Time Shift) بزرگ (۶.۹۳)، سطح نویز در بیشتر مراحل بالا میماند تا جزئیات ساختاری ابتدا تثبیت شوند.
گام بعدی شما
- اگر طراح گرافیک هستید، مدل FLUX.3 Image Klein را در Hugging Face تست کنید تا جایگزینی برای ابزارهای دستی چیدمان بیابید.
- توسعهدهندگان پایتون میتوانند با نصب
pip install -U diffusers transformersخط لوله Modular را در محیط خود پیاده کنند. - برای کاهش هزینه سختافزاری، از نسخههای کوانتیده fp8r یا nvfp4 استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو