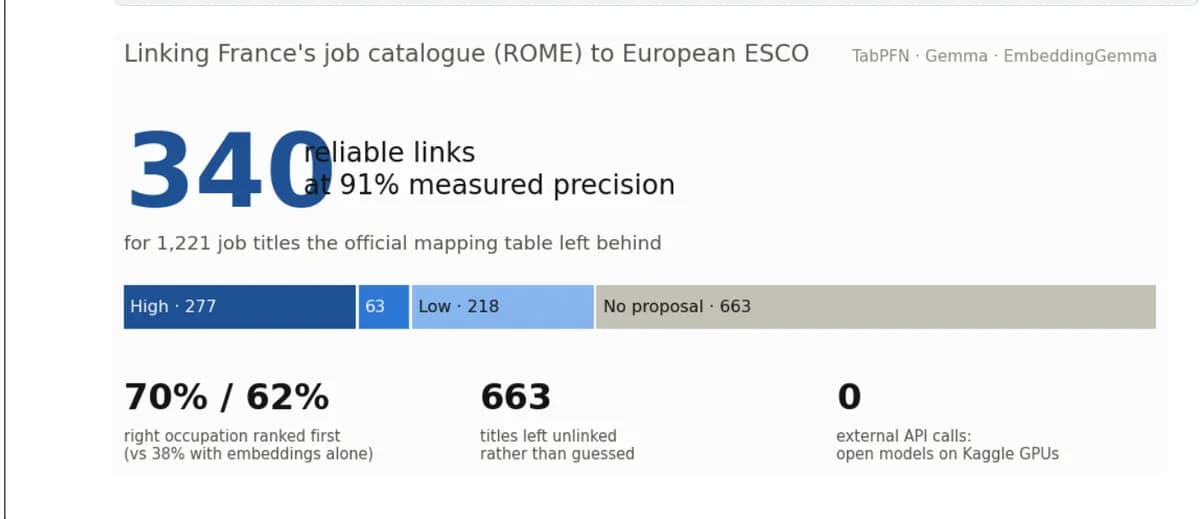
تصور کنید یک فارغالتحصیل در کالدونیای جدید بخواهد مهارتهایش را با استانداردهای شغلی اروپا تطبیق دهد، اما متوجه شود واژگان اداری فرانسه با معیارهای اتحادیه اروپا همخوانی ندارد. این شکاف معنایی اکنون با یک راهکار هوشمندانه برطرف شده است.
به نقل از مستندات منتشر شده در ۴ اکتبر ۲۰۲۶، یک توسعهدهنده مجموعهای از منابع را برای دانشجویان IAE MIAGE (دانشگاه کالدونیای جدید) در جریان هکاتون HackAVP عرضه کرد تا دادههای شغلی پراکنده را یکپارچه کند. همانطور که در تحلیلهای قبلی ما دربارهی اهمیت استانداردسازی دادههای عمومی اشاره کردیم، نبودِ زبان مشترک میان سازمانها، بزرگترین مانع در برابر بهرهوری دادههاست.
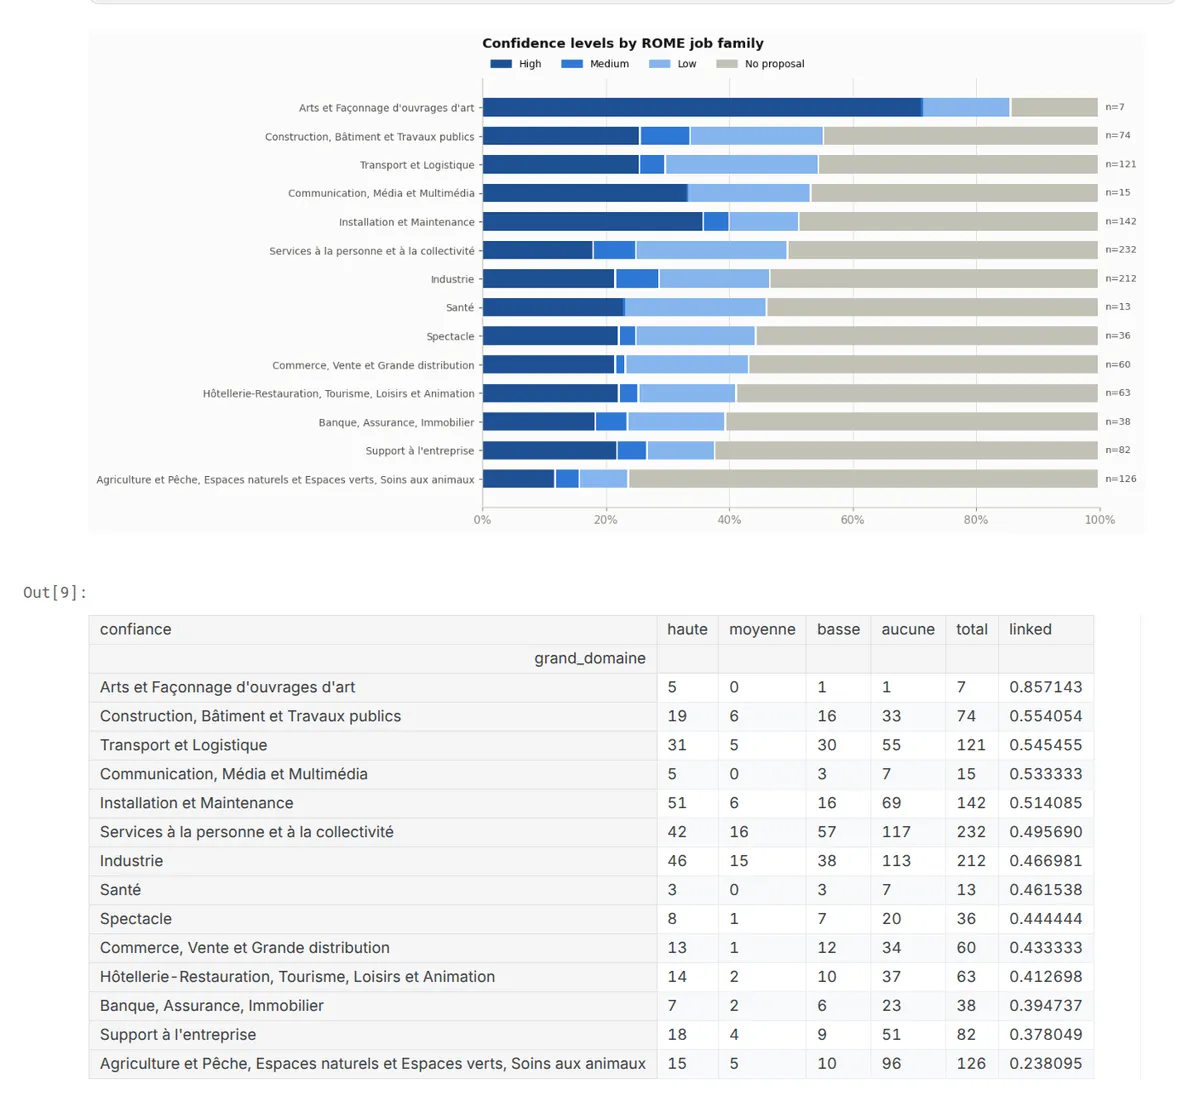
در دنیای دادهها، این مشکل شبیه به این است که دو نفر با دو زبان مختلف درباره یک شغل حرف بزنند؛ یکی از واژگان محلی ROME فرانسه استفاده میکند و دیگری از لایه معنایی غنیتر ESCO اروپا. با پیوند دادن این دو، استخدامکنندگان میتوانند توصیفات ساده شغلی را به تعاریف استاندارد و عمیقتری از مهارتها تبدیل کنند.
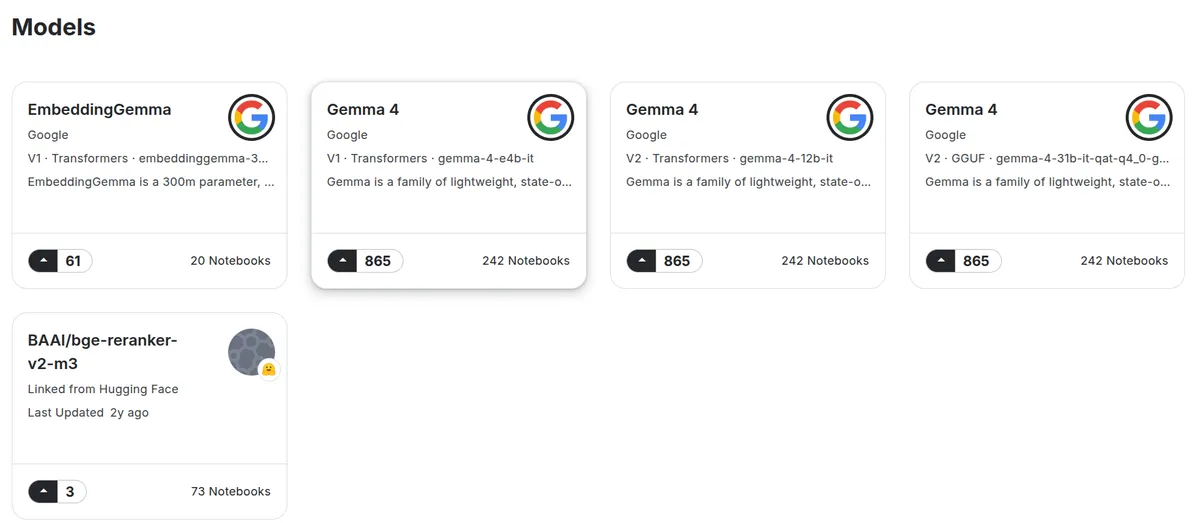
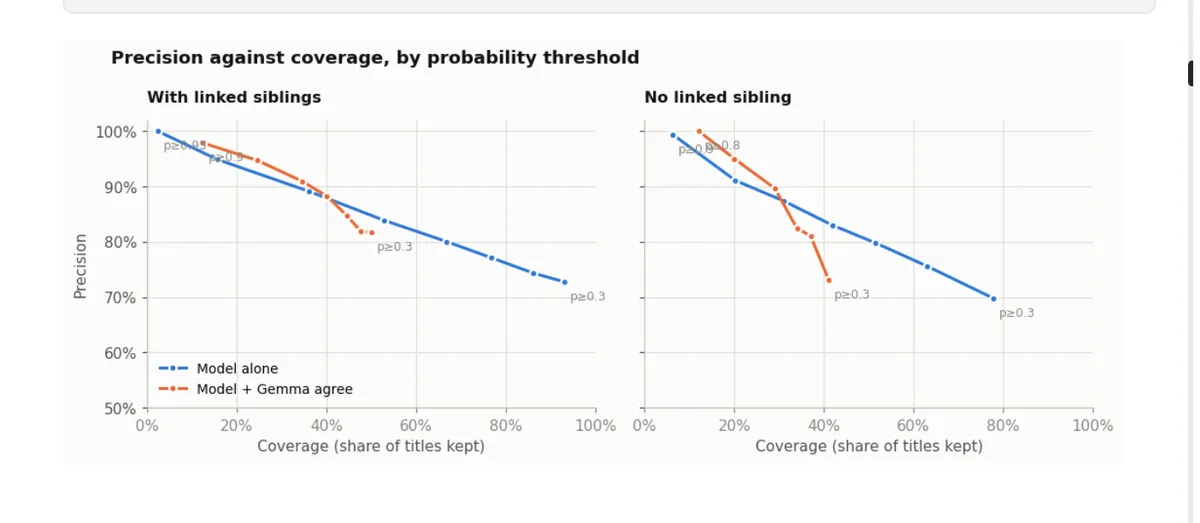
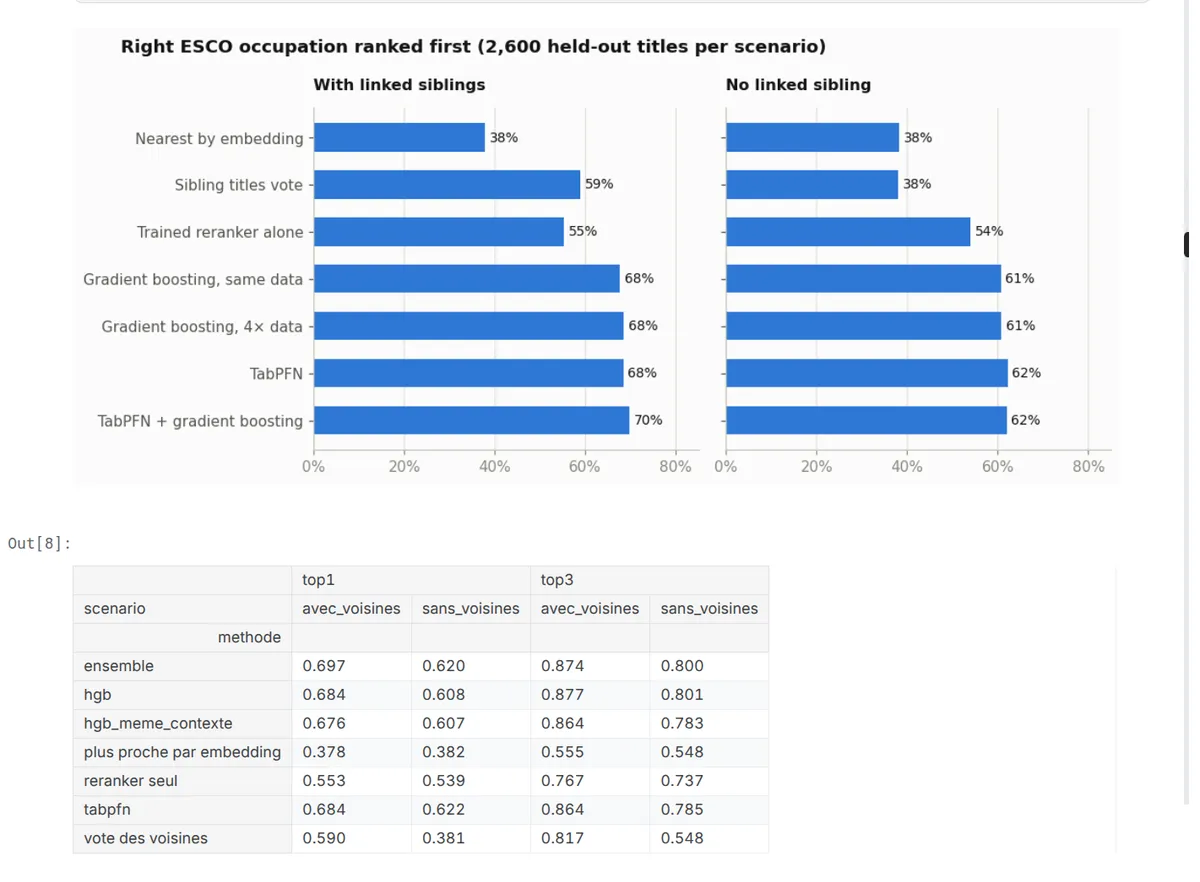
طبق گزارش فنی این پروژه، برای ساخت این نقشه معنایی از مدلهای وزنهای باز (Open Weights) — یعنی مدلهایی که دستور پخت آنها علناً منتشر شده و هر کسی میتواند آنها را اجرا کند — روی طرح رایگان GPU در Kaggle استفاده شده است. زیرساخت فنی این مسیر شامل موارد زیر است:
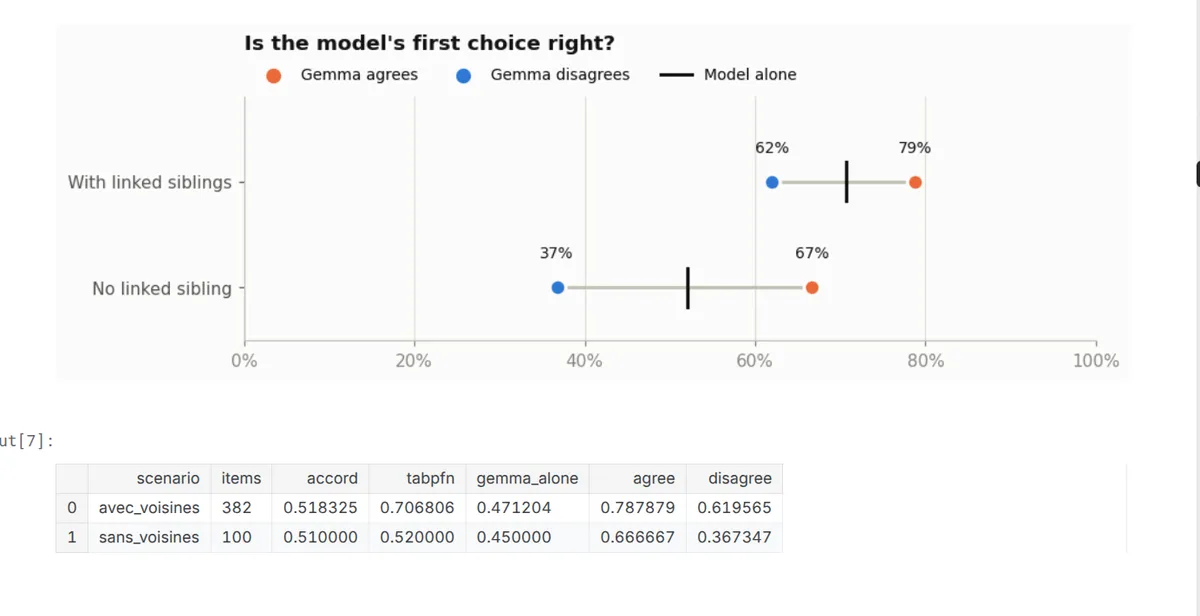
- EmbeddingGemma و نسخههای مختلف Gemma 4 (از جمله مدلهای 4B، 12B و 31B) برای پردازش بردار معنایی (Embedding) — که مثل یک کارت معرفی عددی برای هر واژه است و میگوید این کلمه همسایهی چه کلمات دیگری است.
- TabPFN برای نقشهبرداری پیشبینانه و اعتبارسنجی.
- BAAI/bge-reranker-v2-m3 برای افزایش دقت پیوندها.
- DuckDB برای مدیریت خروجیهای CSV از مخزن GitHub مربوط به odata-esco.
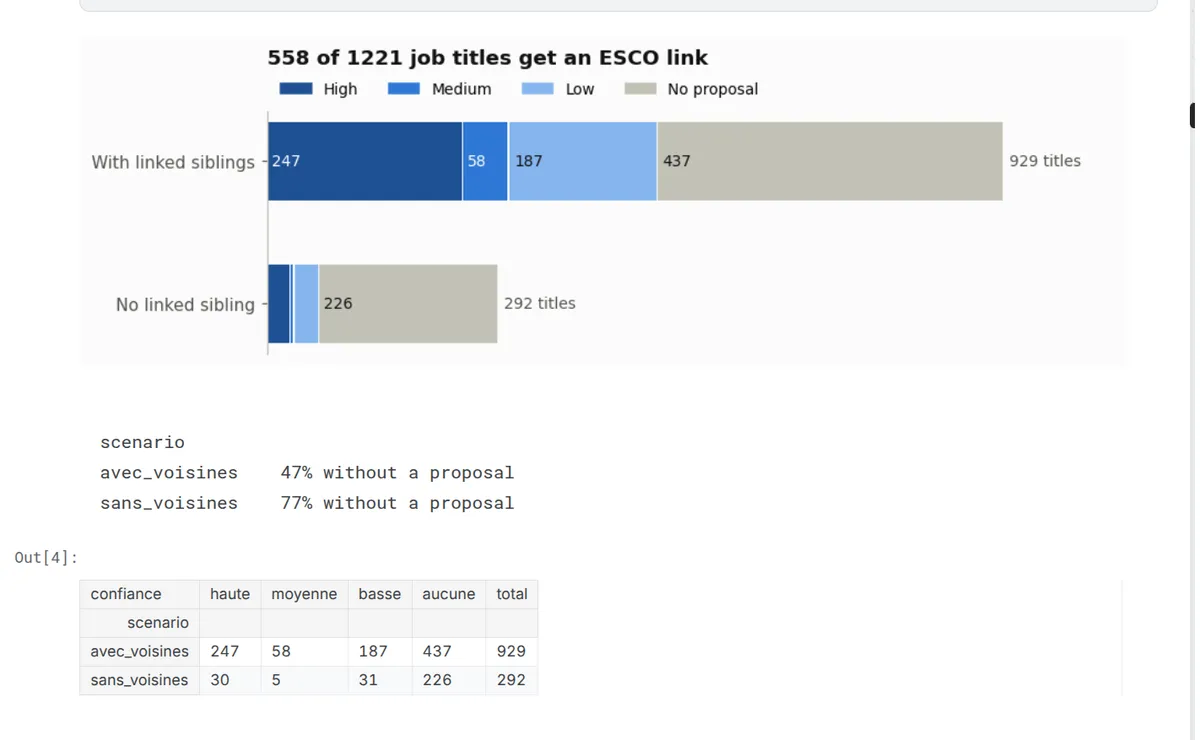
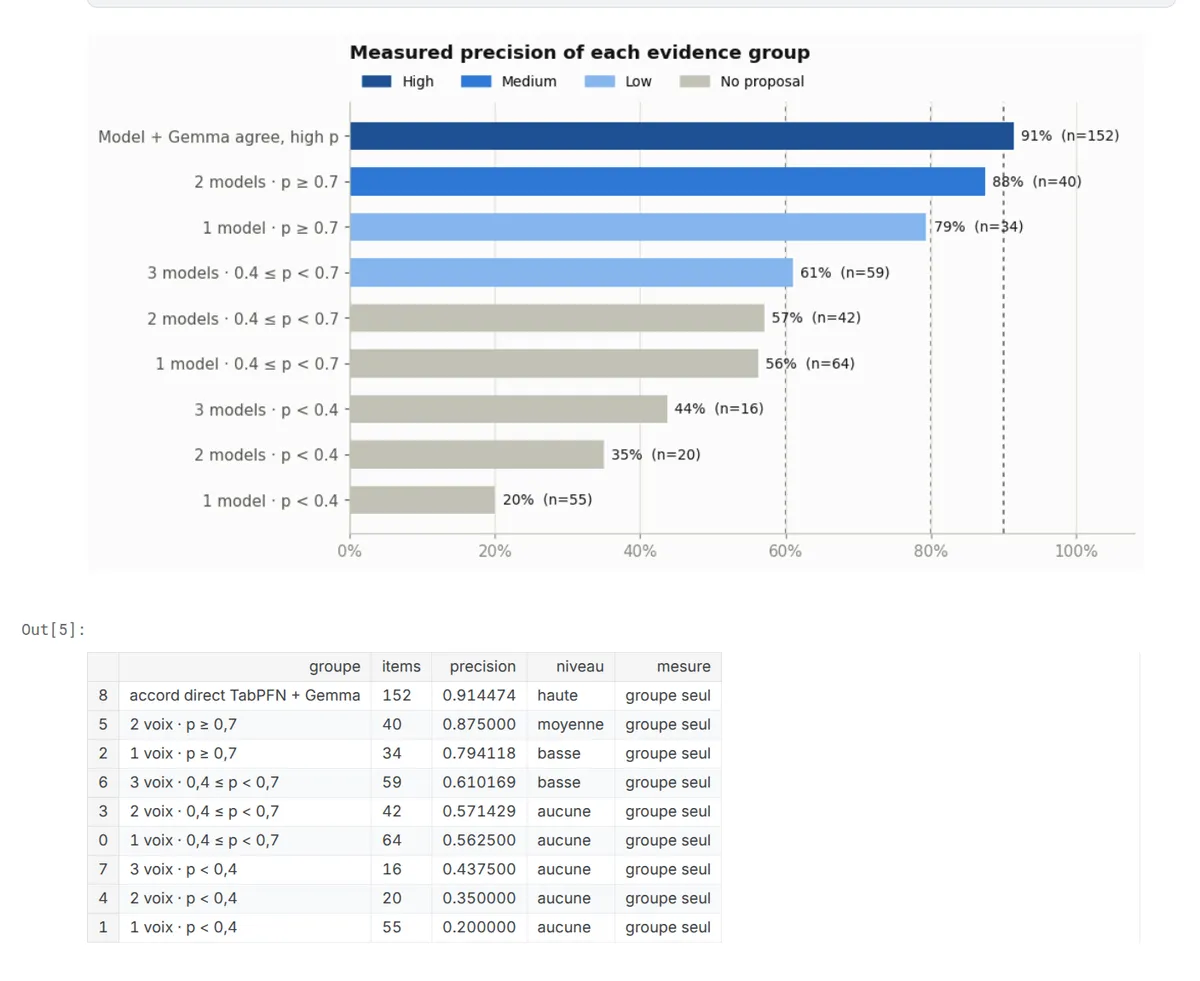
این پروژه بر نقش «نوآوری باز» در حفظ شفافیت خدمات عمومی تأکید دارد. نویسنده با انتشار کامل نوتبوکهای Kaggle و مجموعهدادهها، این امکان را فراهم کرده تا دیگران نتایج را بازرسی کنند یا نسخههای شخصیسازیشده خود را بسازند.
از دیدگاه کاربردی، این تغییر باعث میشود تطبیق شغلی از جستوجوی ساده بر اساس کلمات کلیدی به سمت همراستایی معنایی حرکت کند. برای کاربر نهایی، این یعنی یک آگهی شغلی با فرمت محلی فرانسه میتواند بهطور خودکار به مجموعهای از مهارتهای اروپایی ترجمه شود و متقاضیان در سطح بینالمللی دیده شوند.
این رویکرد ثابت میکند که برای همگامسازی مجموعهدادههای عمومی در مقیاس بزرگ، نیازی به خوشههای عظیم و گرانقیمت اختصاصی نیست و ابزارهای متنباز و رایگان پاسخگو هستند.
گام بعدی شما
- مجموعه داده ROME ESCO را در Kaggle بررسی کنید تا نحوه مدیریت تفاوتهای شغلی توسط مدلها را ببینید.
- اگر با دادههای طبقهبندیشده سر و کار دارید، ترکیب Gemma و TabPFN را برای نقشهبرداری معنایی امتحان کنید.
- مستندات odata-esco را برای درک ساختار دادههای شغلی اروپا مطالعه کنید.
اما تأثیر این مدلهای کوچک بر کاهش هزینههای استنتاج در سازمانهای دولتی حتی جذابتر است — به تحلیل ما دربارهی مدلهای زبانی کوچک (SLM) مراجعه کنید.



گفتگو