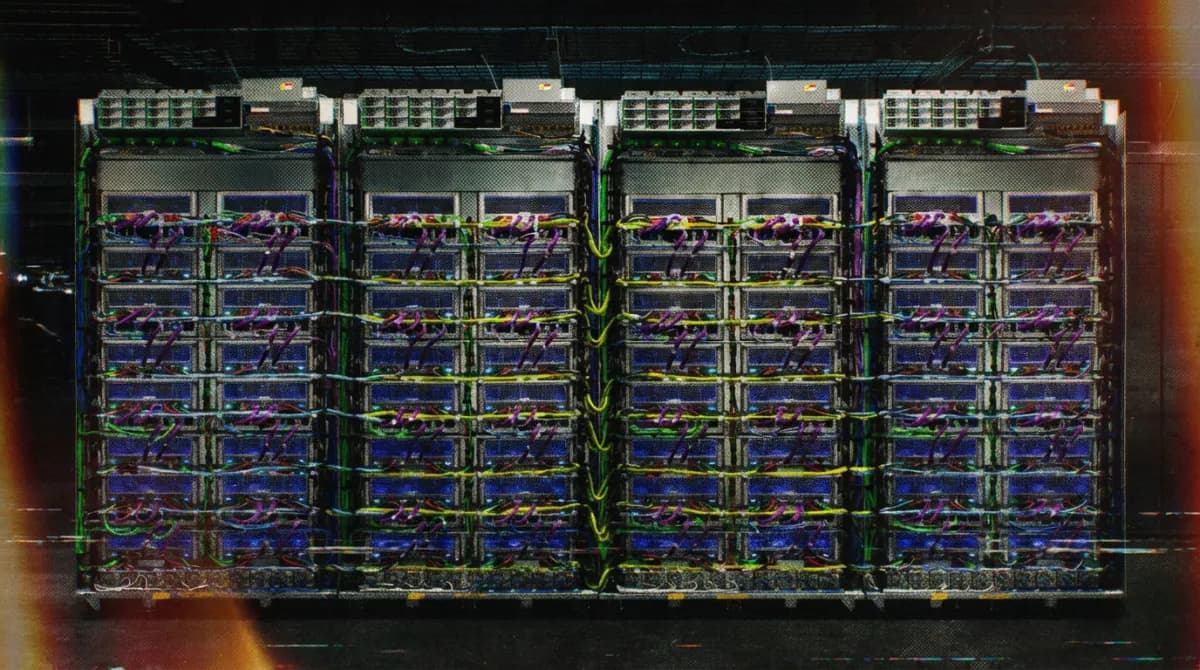
اگر برای استنتاج مدلهای بزرگ هزینه میپردازید، نرخهای شما میتواند زودتر از انتظار تغییر کند — گوگل چهار نوع TPU نسل هشتم را در یک سال با همان سیلیکون عرضه کرده است.
این سرعت مهم است چون بازار هوش مصنوعی زاینده (Generative AI) از آموزش به استنتاج (Inference) — لحظهای که مدل جواب میدهد، مثل خودِ آشپزی نه دورهی آموزش آشپز — سوق داده شده و تراشههای اختصاصی در هزینه و کارایی برندهاند. به گزارش گوگل، شرکت نزدیک به ۱۰۰ مشتری خارجی TPU دارد و TorchTPU را باز کرده تا کد PyTorch با حداقل تغییر اجرا شود. آمازون، مایکروسافت و اوپنایآی (OpenAI) هم به همین دلیل شتابدهندههای (accelerator) اختصاصی میسازند. گفتوگوی گوگل با ۱۰۰ مشتری خارجی TPU در ادامهی اتفاقی است که با اوراکل برای عرضهی نسل هشتم تا سال ۲۰۲۷ شکل گرفته.
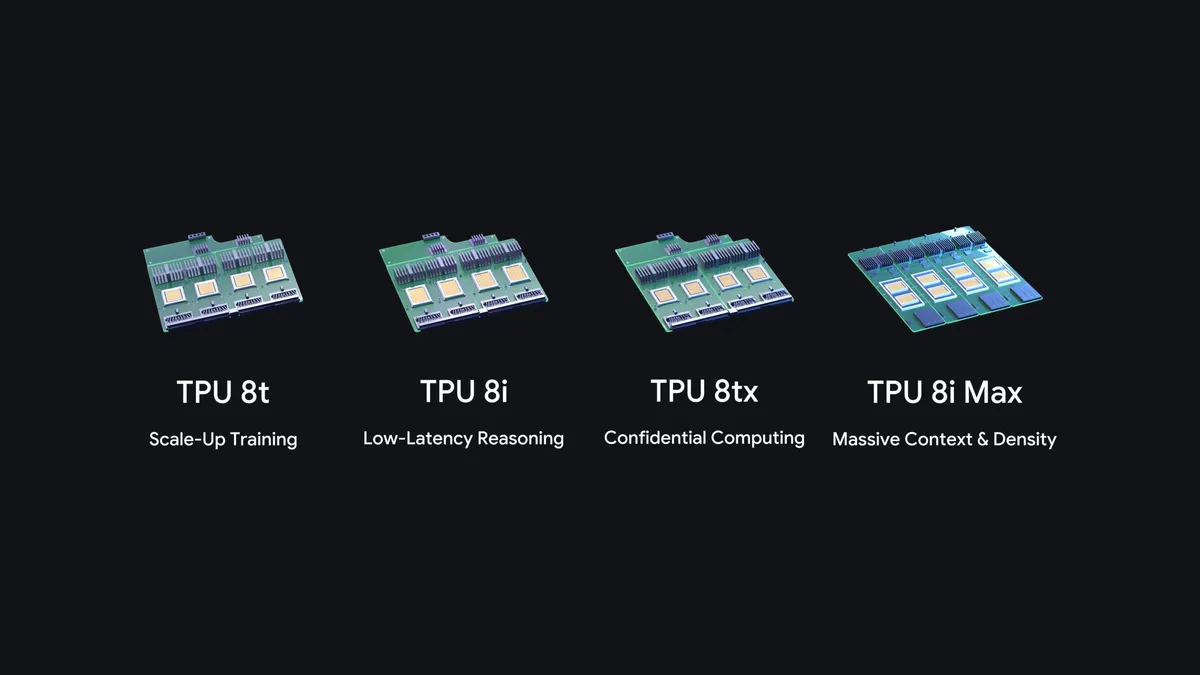
دو سیستم جدید شکافهای مشخصی را هدف قرار دادهاند. TPU 8tx دادهها و وزنهای مدل را حتی در حین پردازش فعال رمزنگاری میکند — مثل محاسبه در یک اتاق امن که حتی مدیر سیستم هم محتوای حافظه را نمیبیند. TPU 8i Max دو تراشه را در یک بسته قرار میدهد، محاسبه، حافظه و پهنایباند حافظه را در همان فضای راک دوچندان میکند — مثل قرار دادن دو موتور در یک بدنه اتومبیل. هر دو از شبکه بردفلای (Boardfly) با تأخیر پایین گوگل استفاده میکنند. گوگل میگوید شرکتها میتوانند روی یک سیستم 8tx مدلها را تنظیم دقیق (Fine-tuning) کنند، تقطیر (distillation) کنند و عاملهای تقویتی (RL agents) را آموزش دهند بدون انتقال دادههای حساس بین خوشهها (cluster).
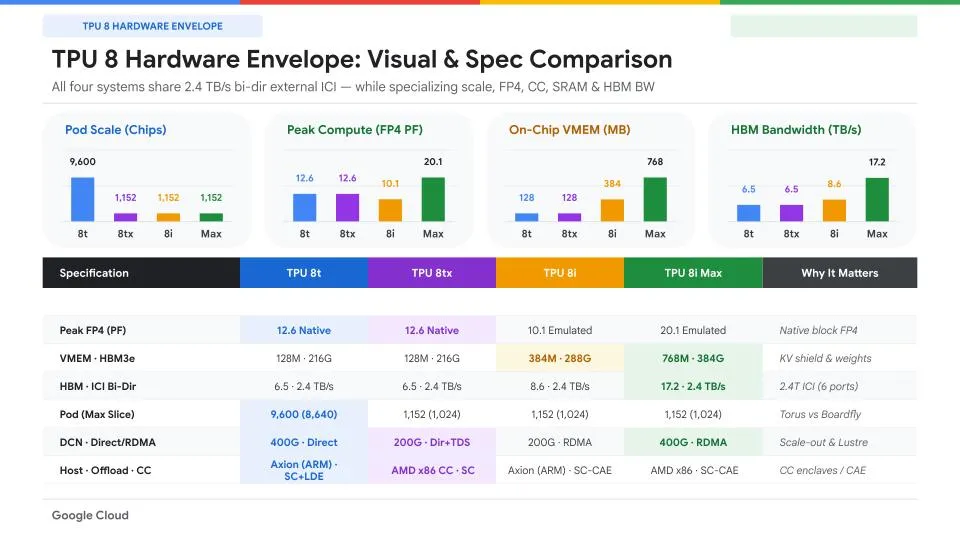
استراتژی ماژولار پاسخِ گوگل به نقشهراه (roadmap) مهیمن GPUهای انویدیا (Nvidia) است. با جدا کردن طراحی سیستم از فابریکاسیون سیلیکون، گوگل میتواند بارهای کاریِ نیش — دادههای دولتی محرمانه، تحلیل کدبیسهای عظیم، پردازش ویدیوهای ساعتها — را بدون انتظار برای نود فرآیند جدید پوشش دهد. پشتیبانی از فریمورکهای باز vLLM و SGLang هزینه جابجایی برای تیمهای سرمایهگذاریشده در PyTorch را پایین میآورد.
برای کسبوکارهایی که زیرساخت هوش مصنوعی ارزیابی میکنند، این یعنی انتخاب بیشتر و چرخه تکرار سریعتر. جنگ قیمت استنتاج تازه آغاز شده و توانایی گوگل در تولید انواع TPU متناسب با تقاضا میتواند انویدیا و تلاشهای تراشه اختصاصی آمازون و مایکروسافت را به تسریع برنامههای انتشار وادار کند. جنگ قیمت استنتاج که گوگل آغاز کرده، همزمانی با کاهش هزینه استنتاج مدل Gemini 4 Argon به ۲۰ درصد هزینه رقبا رخ داده است.
گام بعدی شما
- اگر روی PyTorch کار میکنید، TorchTPU را در یک تست استنتاج کوچک امتحان کنید و تأخیر و هزینه را با GPU فعلی مقایسه کنید.
- برای دادههای حساس، معماری TPU 8tx را با تیم امنیت مرور دهید تا نیاز به انتقال داده بین خوشهها حذف شود.
- گزارشهای فصلی ابری گوگل را برای متریکهای درآمد TPU و آمار اعتماد توسعهدهندگان رصد کنید.
گفتگو