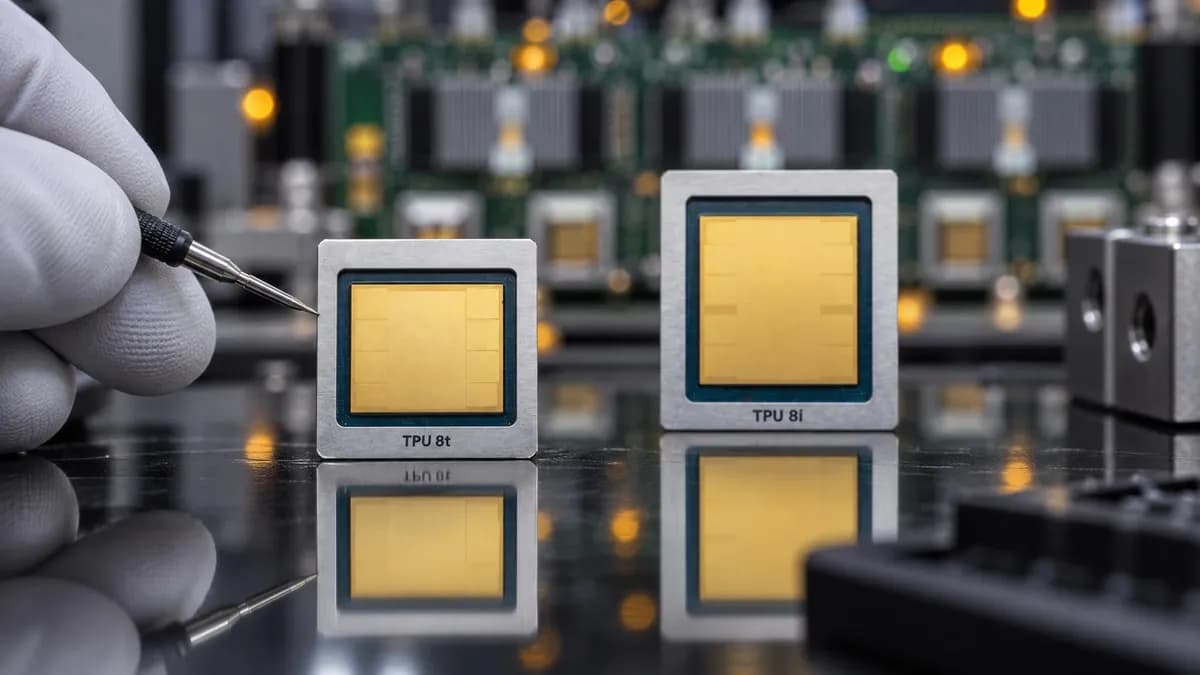
اوراکل و گوگل ۲۷ اکتبر ۲۰۲۶ اعلام کردند تراشههای TPU گوگل از سال ۲۰۲۷ روی زیرساخت ابری اوراکل (OCI) عرضه میشوند. به این ترتیب، اوراکل تنها ابر بزرگ (Hyperscaler) غیرگوگلی میشود که نقشهٔ راه TPU دارد.
این نخستین بار است که شتابدهندههای اختصاصی گوگل بیرون از گوگل کلاد در دسترس قرار میگیرند. سازمانها برای پیشرفتهترین بارهای کاری هوش مصنوعی، گزینهٔ سختافزاری دومی در کنار واحد پردازش گرافیکی (GPU) انویدیا خواهند داشت.
دو سال است که تقاضا برای شتابدهندههای مخصوص هوش مصنوعی از عرضهٔ GPUهای همهمنظوره جلو افتاده است. گوگل از سال ۲۰۱۵ ناوگان TPU را برای کارهای داخلی خود به کار میبرد. جستوجو، Photos، Maps و خانوادهٔ مدلهای Gemini روی همین تراشهها اجرا میشوند. تا امروز، دسترسی بیرونی به TPU فقط با حساب گوگل کلاد ممکن بود.
اعلام همکاری در Oracle AI World
دو شرکت این توافق را در همایش Oracle AI World در لاسوگاس اعلام کردند. به گفتهٔ آنها، این همکاری پاسخی به نیازهای متفاوت محاسباتی در آموزش، استنتاج و استدلال عاملمحور است.
ماهش تیاگاراجان، رئیس زیرساخت ابری اوراکل، گفت: «بارهای کاری مختلف هوش مصنوعی نیازهای محاسباتی متفاوتی دارند.» او افزود که این همکاری به مشتریان امکان میدهد در یک ابر به چند معماری پیشرو محاسبات دسترسی داشته باشند. امین وحدت، معاون ارشد گوگل در حوزهٔ هوش مصنوعی و زیرساخت، تأکید کرد نسل بعدی هوش مصنوعی به گزینههای محاسباتی متنوعی نیاز دارد.
این همکاری نشان میدهد گوگل حاضر است از دانش فنی تراشههایش بیرون از ابر خود هم درآمد کسب کند. اوراکل هم لایهٔ محاسباتی متمایزی به دست میآورد تا با Trainium در AWS و Maia در Azure رقابت کند. این همکاری در حالی شکل میگیرد که اوراکل ۱ میلیارد دلار در اکوسیستم شریک خود سرمایهگذاری میکند.
مشخصات TPU نسل هشتم گوگل
نسل هشتم TPU گوگل شامل دو تراشهٔ جداگانه است. TPU 8t برای آموزش طراحی شده و با توپولوژی توری سهبعدی (3D torus)، ۹۶۰۰ تراشه را در هر سوپرپاد به هم وصل میکند. TPU 8i برای استنتاج با همزمانی بالا و رمزگشایی متنهای طولانی بهینه شده است.
مشخصات کلیدی طبق گزارش فنی گوگل در آوریل ۲۰۲۶:
- TPU 8t: ۲۱۶ گیگابایت حافظهٔ پهنایباند بالا (HBM)، ۱۲۸ مگابایت SRAM، ۱۲٫۶ پتافلاپس اوج در FP4 و ۶۵۲۸ گیگابایت بر ثانیه پهنایباند حافظه
- TPU 8i: ۲۸۸ گیگابایت HBM، ۳۸۴ مگابایت SRAM، ۱۰٫۱ پتافلاپس اوج در FP4 و ۸۶۰۱ گیگابایت بر ثانیه پهنایباند
- هر دو تراشه پردازندهٔ مبتنی بر Arm به نام Axion دارند تا گلوگاه میزبان برطرف شود
- شبکهٔ مقیاسپذیر Virgo Network پهنایباند را برای آموزش روی TPU 8t تا ۴ برابر افزایش میدهد
- قابلیتهای TPUDirect RDMA و TPUDirect Storage پردازندهٔ میزبان را دور میزنند و دسترسی به ذخیرهسازی را نسبت به Ironwood تا ۱۰ برابر سریعتر میکنند
ادعاهای گوگل دربارهٔ عملکرد
به گفتهٔ گوگل، TPU 8t در هر پاد تقریباً ۳ برابر نسل هفتم یعنی Ironwood توان محاسباتی دارد. گوگل میگوید این تراشه چرخهٔ توسعهٔ مدلهای پیشرو را از چند ماه به چند هفته کاهش میدهد. TPU 8i حدود ۳ برابر بیشتر SRAM روی تراشه دارد. در نتیجه KV Cache بزرگتر در رمزگشایی متنهای طولانی کاملاً روی خود تراشه میماند.
ادعاهای گوگل دربارهٔ عملکرد به ازای هر دلار جسورانه است:
- بهبود ۲٫۷ برابری برای TPU 8t در آموزش مقیاس بزرگ
- بهبود ۸۰ درصدی برای TPU 8i در اهداف تأخیر پایین روی مدلهای بزرگ ترکیب متخصصان (MoE)
- عملکرد به ازای هر وات ۲ برابر بهتر در هر دو تراشه
گوگل همچنین میگوید چارچوب JAX و پشتهٔ نرمافزاری Pathways میتوانند آموزش توزیعشده را در یک خوشه به بیش از ۱ میلیون تراشهٔ TPU برسانند.
محصولات فعلی TPU در گوگل کلاد
گوگل کلاد اکنون Ironwood و Trillium را عرضه میکند. Ironwood نسل هفتم است و هر پاد آن ۹۲۱۶ تراشهٔ خنکشونده با مایع و توان ۴۲٫۵ اگزافلاپس دارد. Trillium نسل ششم است. در صفحهٔ محصول گوگل، TPU 8t و TPU 8i با عنوان «بهزودی» فهرست شدهاند. TPUها از PyTorch، JAX و موتور استنتاج vLLM پشتیبانی بومی دارند.
معنای TPU گوگل در اوراکل برای سازمانها
این توافق راهبرد چندابری هوش مصنوعی را تغییر میدهد. سازمانها دیگر مجبور نیستند میان اکوسیستم TPU گوگل و پشتهٔ پایگاه داده و نرمافزارهای اوراکل یکی را انتخاب کنند. آنها میتوانند مدل را روی پادهای TPU 8t در OCI آموزش دهند و استنتاج را روی TPU 8i اجرا کنند؛ همه با یک فروشنده.
گوگل با این کار هزینهٔ میلیاردی تحقیق و توسعهٔ تراشه را میان مشتریان بیشتری سرشکن میکند. اوراکل هم بدون طراحی تراشهٔ اختصاصی، کمبودی مهم را در زیرساخت هوش مصنوعی خود جبران میکند. آزمون اصلی، شفافیت قیمتگذاری است و اینکه آیا شبکهٔ OCI به سطح یکپارچگی TPU در گوگل کلاد میرسد یا نه.
رقابت شتابدهندهها در ۲۰۲۷
زمانبندی ۲۰۲۷ با عرضهٔ مورد انتظار معماری Rubin انویدیا و سری MI400 شرکت AMD همزمان است. مشتریان سه خانوادهٔ شتابدهنده پیش رو خواهند داشت: GPUهای انویدیا، TPUهای گوگل و تراشههای اختصاصی خود ابرها. هنوز محک استانداردی برای مقایسهٔ این پلتفرمها وجود ندارد.
گوگل میگوید Virgo Network میتواند بیش از ۱۳۴۰۰۰ تراشهٔ TPU 8t را با پهنایباند دوبخشی غیرمسدودکننده (bisectional bandwidth) تا ۴۷ پتابیت بر ثانیه به هم وصل کند. چنین مقیاسی تاکنون در ابرهای تجاری دیده نشده است. اگر این وعده محقق شود، انتظارها از کارایی آموزش توزیعشده تغییر میکند.
مدلهای قیمتگذاری OCI و نقشهٔ دسترسی منطقهای احتمالاً اواخر ۲۰۲۶ مشخص میشوند. برنامههای دسترسی زودهنگام احتمالاً مشتریان مشترک فعلی اوراکل و گوگل را در اولویت قرار میدهند؛ مشتریانی که بارهای کاری مبتنی بر Gemini یا JAX دارند. مشتریان مبتنی بر Gemini میتوانند از تجربه گوگل در کاهش زمان بررسی اسناد بهرهمند شوند.
گام بعدی شما
- اگر بودجهٔ زیرساخت هوش مصنوعی ۲۰۲۷ را برنامهریزی میکنید، هزینهٔ کل مالکیت TPU 8t را با معادلهای H100 و H200 مقایسه کنید؛ هزینهٔ انتقال داده میان OCI و ابرهای دیگر را هم در نظر بگیرید.
- اگر بار کاری مبتنی بر JAX یا Gemini دارید، اخبار برنامهٔ دسترسی زودهنگام OCI را دنبال کنید.
- نقشهٔ راه سختافزاری ۲۰۲۷ را بر پایهٔ سه گزینه تنظیم کنید: انویدیا، گوگل و تراشههای اختصاصی ابرها.
گفتگو