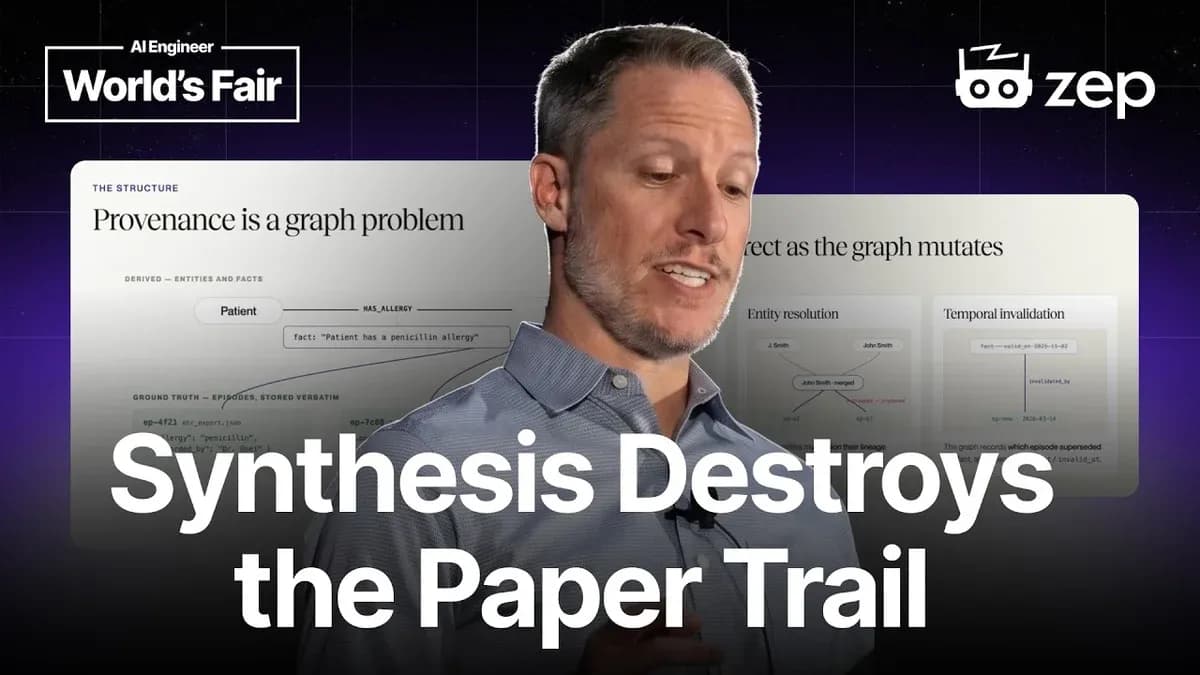
تصور کنید یک مدل زبانی، حقیقتی را تولید کند که ترکیبی از چندین منبع متناقض است و عیبیابی این خطای حیاتی را برای شما غیرممکن کند. برای حل این بحران، دنیل شالِف (Daniel Chalef)، بنیانگذار Zep AI و معمار فریمورک Graffiti، این ابزار را در ۲۵ ژوئیه ۲۰۲۶ در رویداد AI Engineer World's Fair معرفی کرد.
بسیاری از خطوط لولههای مدلهای زبانی دچار «از دست رفتن منشأ» هستند. منشأ یا پروتوکول ردیابی، سندی است که توضیح میدهد داده چگونه تولید شده و از کجا آمده است. این نبودِ قابلیت ردیابی، موانع بزرگی برای عیبیابی سامانههای پیچیده هوش مصنوعی، تضمین رعایت الزامات قانونی و نظارتی، و حفظ اعتماد در خروجیهای تولیدشده توسط مدل ایجاد میکند.
وقتی یک مدل تاریخچه پزشکی بیمار را خلاصه میکند، فقط متن را کپی نمیکند؛ بلکه دادهها را از پروندههای الکترونیک (EHR)، گزارشهای آزمایشگاه و چتها ترکیب و سنتز میکند. برای مثال، ممکن است مدل با اطمینان بگوید بیمار به پنیسیلین حساسیت دارد، اما این ادعا در واقع ترکیبی از چندین منبع مختلف است. بدون درک دقیق این منشأ، متخصصان پزشکی ممکن است بر اساس اطلاعات گمراهکننده تصمیمات درمانی بگیرند.
برچسبهای ساده شناسایی منبع (Source IDs) در اینجا شکست میخورند؛ زیرا مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — در حین پردازش، دادهها را تغییر میدهد یا موجودات مختلف را با هم ادغام میکند (مثلاً تشخیص اینکه «ج. اسمیت» و «جان اسمیت» یک نفر هستند). شالِف تأکید کرد که تبار داده باید مجموعهای پویا و در حال تکامل باشد تا در برابر این تغییرات و جهشها مقاوم بماند.
همانطور که در تحلیل قبلی ما دربارهی محدودیتهای API مدلهای زبانی در سال ۲۰۲۶ اشاره کردیم و پراکندگی قوانین تامینکنندگان بزرگ را بررسی کردیم، Graffiti اکنون روی یک چالش عملیاتی دیگر تمرکز کرده است: نبود یک ردپای حسابرسی (Audit Trail) قابل تأیید برای دادههایی که این APIها پردازش میکنند.

Graffiti این مشکل را با استفاده از یک «فریمورک گراف زمانی» (Temporal Graph Framework) متنباز حل میکند. این ابزار بهجای برچسبهای تخت، رابطهی بین دادههای خام و آثار مشتقشده (مانند حقایق تکجمله) را بهصورت یک گراف دانش (Knowledge Graph) جامع مدل میکند. به این ترتیب، هر حقیقت تولیدشده را میتوان با یک پیمایش ساده در گراف، تا ریشهی اصلیاش ردیابی کرد.
سازوکارهای فنی کلیدی
به نقل از گزارش وبسایت dev.to، این فریمورک برای مدیریت پیچیدگیهای ذاتی دادههای مدلهای زبانی از سه قابلیت اصلی استفاده میکند:
- مدلسازی گراف زمانی: تکامل دادهها و روابط آنها را در طول زمان ثبت میکند، بهجای آنکه آنها را بهعنوان تصاویر ایستا (Static Snapshots) ببیند.
- پروجکشن متادیتا: در لحظه ورود، اپیزودهای داده را برچسبگذاری میکند. این برچسبها (مانند «EHR» یا «منبع کلینیکی تأییدشده») به تمام موجودات و حقایق مشتقشده بعدی منتقل میشوند. این قابلیت به عاملهای هوشمند اجازه میدهد اطلاعات را بر اساس اعتبار ادراکشده از منبع فیلتر کنند.
- مدیریت حذف داده: دقیقاً شناسایی میکند کدام حقایق از دادههای خاصی مشتق شدهاند که برای حذف علامتگذاری شدهاند؛ این مورد برای رعایت مقررات حریم خصوصی حیاتی است.
منطق تأیید و حقیقتسنجی
Graffiti مفهوم «حقیقت» را از طریق یک سیستم وزندهی دقیق بر اساس میزان حساسیت و حیاتی بودن دادهها مدیریت میکند. شالِف این موضوع را با سناریویی توصیف کرد که در آن یک حقیقت توسط سه اپیزود والد پشتیبانی میشود: دو منبع تأییدشده و یک منبع نامعتبر.
- دادههای حساس (High-Stakes): برای اطلاعات حیاتی (مانند حساسیت دارویی بیمار)، سیستم را میتوان بهگونهای تنظیم کرد که شرط «تأیید شدن تمام» منابع والد را برای پذیرش حقیقت داشته باشد.
- دادههای کمریسک (Low-Stakes): برای موارد کمتر حساس (مانند رضایتنامه کلی)، سیستم ممکن است حقیقت را بپذیرد اگر حتی «یک» منبع والد تأییدشده باشد.
حریم خصوصی و حق فراموش شدن
مدل گرافی این فریمورک برای اجرای درخواستهای مربوط به «حق فراموش شدن» (Right to be Forgotten) ضروری است. اگر یک حقیقت توسط چندین منبع مستقل پشتیبانی شود، حتی پس از حذف یک منبع، آن حقیقت در گراف باقی میماند. در مقابل، اگر حقیقتی منحصراً از دادههای حذفشده مشتق شده باشد، Graffiti آن را بهدرستی و بهطور کامل از گراف پاک میکند.
برای مهندسان، این تغییر یعنی گذار از «اعتماد کورکورانه» به خروجی مدل، به سمت یک تبار (Lineage) قابل تأیید. این رویکرد، مدل زبانی را از یک جعبه سیاه تولیدکننده به یک موتور سنتز شفاف تبدیل میکند که هر ادعایش به یک مدرک قابل ردیابی گره خورده است.
شالِف اصول بنیادین سامانههای مستحکم را شناسایی منشأ داده، مدلسازی روابط از طریق گراف، حفظ آگاهی زمانی و استفاده از متادیتای زمینهای برای تأیید دانست. هرچند او پذیرفت که ساخت این گرافها از نظر محاسباتی سنگین است، اما تیم او بر بهینهسازی تأخیر و هزینه تمرکز کرده تا ابزار برای محیطهای عملیاتی (Production) آماده شود. این رویکرد استاندارد تولید بازیابیافزا (RAG) — شبیه دانشآموزی که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — را تغییر میدهد؛ زیرا توسعهدهندگان دیگر مجبور نیستند بین سنتز سطح بالا و ردیابی دقیق (Granular Traceability) یکی را انتخاب کنند.
برای پیادهسازی این ابزار در استک فنی خود، میتوانید کد منبع و مستندات فریمورک Graffiti را در گیتهاب بررسی کنید.
گام بعدی شما
- اگر از سامانههای RAG برای دادههای حساس استفاده میکنید، مستندات Graffiti در گیتهاب را برای پیادهسازی لایهی تبار داده بررسی کنید.
- ساختار گرافهای زمانی را در معماری دادههای خود جایگزین ذخیرهسازهای تخت (Flat) کنید تا مدیریت حذف دادهها طبق قوانین GDPR سادهتر شود.
- سیستم وزندهی به منابع را بر اساس سطح ریسک خروجیهای مدل خود تعریف کنید.
اما تأثیر این شفافیت بر توهمات مدلها حتی عمیقتر است — به تحلیل ما دربارهی نرخ توهم در مدلهای استدلالی مراجعه کنید.



گفتگو