تصور کنید بخواهید در میان میلیونها فایل کد، دقیقاً همان قطعهای را پیدا کنید که منطق «تجدید توکن» را پیاده کرده، اما در کد از عبارت «refresh session» استفاده شده است. اگر هنوز برای این کار به جستوجوی کلمات کلیدی یا grep تکیه میکنید، احتمالاً بخش بزرگی از شواهد لازم برای عاملهای هوش مصنوعی را از دست میدهید. جستوجوی سنتی بر اساس تطبیق کلمات کلیدی است و مستلزم آن است که عامل دقیقاً بداند از چه اصطلاحاتی در کد استفاده شده است. اگر عاملی به دنبال «session refresh» بگردد اما در کد از عبارت «token renewal» استفاده شده باشد، جستوجوی کلمات کلیدی شکست میخورد. جستوجوی معنایی این مشکل را با ایندکس کردن کدها بر اساس مفهوم حل میکند و به عاملها اجازه میدهد در حوزههای انتزاعی استدلال کنند. اما انتقال این ایده از یک نمونه اولیه به یک سیستم عملیاتی، با چالشهای عظیمی در تجزیه و ذخیرهسازی همراه است.
به نقل از گزارش منتشر شده در ۴ اکتبر ۲۰۲۶، شرکت JetBrains جزئیات مهندسی Air Context را افشا کرد؛ یک خط لوله تولید بازیابیافزا (RAG) — شبیه دانشآموزی که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — که برای تأمین شواهد دقیق و قابل استناد از کدهای منبع طراحی شده است. این شرکت توانست با ذخیره بردارهای ۴۰۹۶ بُعدی به صورت اعداد صحیح ۱ بیتی (به جای اعشاری ۳۲ بیتی)، فضای ذخیرهسازی را ۳۲ برابر کاهش دهد. این یک سبکسازی عظیم بود که جستوجوی معنایی را برای مخازنی با میلیونها فایل عملی کرد.
زمینه و بستر جستوجوی عاملمحور
عاملهای کدنویسی بزرگترین جهش فناوری دهه اخیر در توسعه نرمافزار هستند. در حالی که مدلهای پیشرو (Frontier Models) میتوانند پیچیدگیهای عظیمی را مدیریت کنند، اما کارایی یک عامل به این بستگی دارد که چه مقدار زمان و هدایت برای تولید نتایج در سطح تولید (Production-grade) نیاز باشد. این بهینهسازی در معماری عاملها منجر به نتایج درخشانی شده است، مشابه آنچه در مقایسه چارچوبهای عاملمحور مشاهده شد و LangGraph با نرخ موفقیت ۹۴.۴٪ پیشتازی کرد. در مخازن کد مقیاسبزرگ، عاملها زمان نامتناسبی را صرف جستوجوی قطعات مرتبط و گنجاندن آنها در پنجره متنی (Context Window) — میزان متنی که مدل همزمان در ذهن نگه میدارد، مثل میز کاری که جا برای چند ورق دارد — میکنند.
سیستم RAG رابطی ایجاد میکند که نقاط قوت عامل را به کار میگیرد و اجازه میدهد جستوجوی متن آزاد روی ایندکسی انجام شود که معناشناسی را ثبت کرده است. اگرچه پیادهسازی یک نمونه اولیه ساده است، اما یک راهکار در سطح تولید نیازمند یک خط لوله سختگیرانه است که پیشپردازش، ذخیرهسازی و یکپارچگی با عامل را پوشش دهد.
چالش مقیاسپذیری
سیستمهای عملیاتی شامل هزاران فایل هستند که هر کدام ممکن است صدها یا هزاران خط کد داشته باشند. عاملها اغلب این مشکل را تشدید میکنند، زیرا تمایل دارند کدهای زیادی بنویسند و بدین ترتیب حجم کدبیس را بیش از پیش افزایش دهند. هر فایل ممکن است شامل تعداد زیادی کلاس، فیلد و متد باشد که درجات متفاوتی از ارتباط با یکدیگر دارند.
یافتن اندازه مناسب برای تکهبندی (Chunking) یک تعادل حیاتی است. تبدیل یک فایل بسیار حجیم به یک واحد تکه (Embedding) شکستخورده است، زیرا جستوجو کل فایل را برمیگرداند و توانایی عامل برای یافتن یک تابع یا نماد خاص را مختل میکند. در مقابل، تکهبندی هر خط کد به صورت جداگانه مشکل دیگری ایجاد میکند: خطوط کد به تنهایی اغلب بدون بستر اطرافشان از نظر معنایی بیاهمیت هستند. یک نام تابع کلی یا یک کامنت ساده، ارزش تبدیل به بردار را ندارد و میتواند نتایج بازیابی اشتباه تولید کند و عامل را با نتایج خرد و بیاهمیت بمباران کند.
دقت تکهبندی ساختار-آگاه
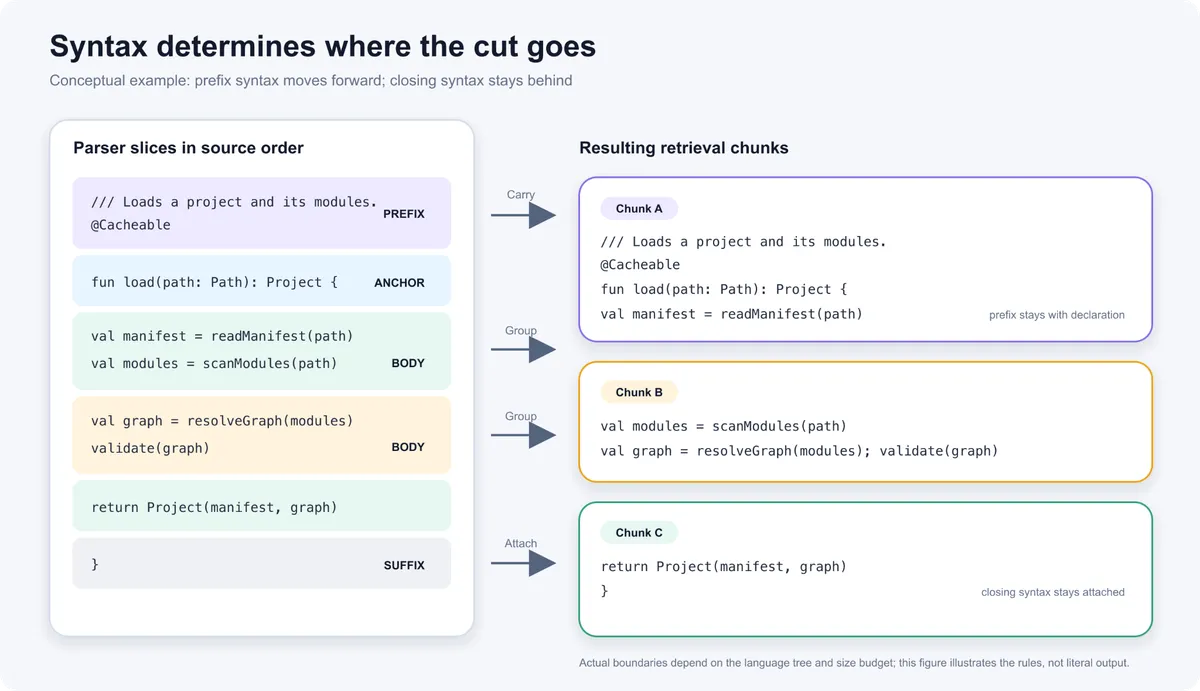
پیادهسازیهای ساده RAG اغلب از تکهبندی با اندازه ثابت استفاده میکنند و فایلها را هر X خط میبُرند. JetBrains دریافت که این رویکرد از نظر معنایی معیوب است، زیرا اغلب دستورات import را از توابعی که از آنها استفاده میکنند جدا میکند و منجر به اشتباهات بازیابی میشود. برای حل این مشکل، آنها از JetBrains Code Engine داخلی خود برای پیادهسازی تکهبندی ساختار-آگاه استفاده کردند.
این خط لوله در حال حاضر از ۹ زبان اصلی پشتیبانی میکند: کاتلین، جاوا، پایتون، جاوااسکریپت، تایپاسکریپت، سیشارپ، پیاچپی، گو و راست. برای این زبانها، سیستم از یک پارسر استفاده میکند تا فایلها را به گرههای نحو (Syntax Nodes) تجزیه کند. سپس الگوریتم این گرهها را بر اساس نوع و اندازه آنها گروهبندی میکند تا اطمینان حاصل شود که مستندات، انوتیشنها و اصلاحکنندههای دسترسی (Visibility Modifiers) در کنار تعریفهای خود باقی میمانند.
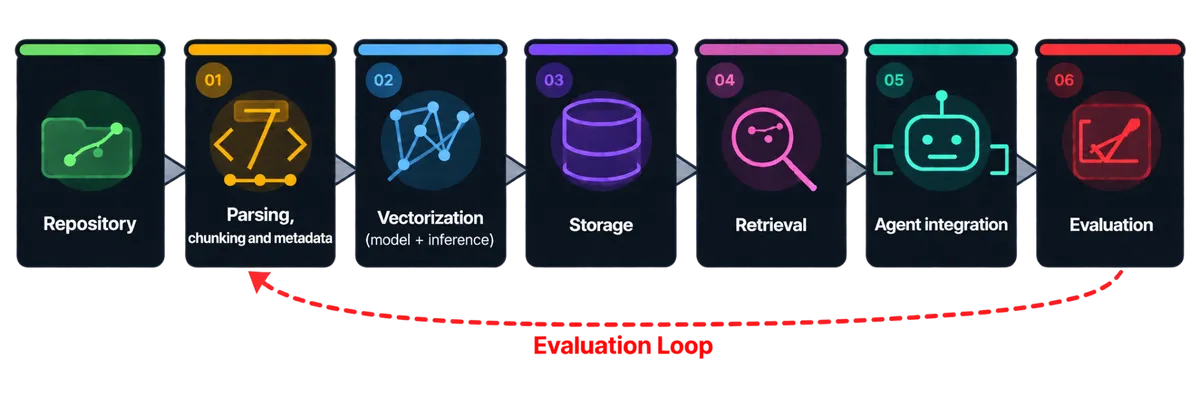
طبق مستندات این شرکت، برای تضمین کیفیت از استراتژی مدل زبانی بهمثابه داور (LLM-as-a-judge) استفاده شده است. یک مدل مجزا، تکهها را با فایل اصلی مقایسه میکند تا شناسایی کند که آیا نحوهای «یتیم» (Orphaned) یا مستندات جدا شدهای وجود دارد یا خیر. این کار مانع از آن میشود که عامل قطعات کد تکهتکه دریافت کند که فاقد بستر لازم برای مفید بودن هستند. هرگونه تغییر در خط لوله پردازش نیز تحت یک ارزیابی کامل بازیابی سرتاسری (End-to-End) قرار میگیرد.
جزئیات فنی خط لوله تجزیه (Parsing)
تجزیه یک مرحله پیشپردازش حیاتی است زیرا سیستمهای عملیاتی شامل هزاران فایل با طولهای متفاوت هستند. برای مدیریت این موضوع، خط لوله Air Context از منطق خاصی پیروی میکند:
- تصمیمگیری مبتنی بر گره: پارسر فایلها را به جریانی از گرههای نحو (کامنتها، فاصلهها و اصلاحکنندهها) تبدیل میکند. الگوریتم محدوده هر تکه را بر اساس نوع گره، اندازه و فرزندان آن تعیین میکند.
- استراتژیهای جایگزین: اگر گرهی از آستانه اندازه فراتر رود اما هیچ فرزندی نداشته باشد، سیستم به استراتژیهای تکهبندی ابتدایی (Primitive Splitting) بازمیگردد.
- حفظ معنا: برخی ساختارها حتی اگر از اندازههای ترجیحی فراتر روند، به صورت تکههای واحد حفظ میشوند. این شامل نگه داشتن دکوراتورهای پایتون همراه با تعریفها و KDocها در کنار تعریفهای کاتلین است.
- پاکسازی زبان-محور: سیستم انوتیشنهای بیمعنا از نظر معنایی، مانند
@NotNullیا@Overrideدر جاوا را حذف میکند تا نویز کاهش یابد. - نرمالسازی تکهها: قبل از تبدیل به بردار، تکهها تحت فرآیند نرمالسازی قرار میگیرند که شامل حذف فاصلههای ابتدایی و انتهایی، حذف خطوط خالی و حذف تو رفتگیهای (Indentation) مشترک در حالی که تو رفتگیهای نسبی حفظ شوند، است.
این رویکرد شباهتهایی به cAST (Zhang et al., 2025) دارد، زیرا هر دو بزرگترین واحدهای نحو را که جا میشوند حفظ کرده و واحدهای کوچکتر مجاور را گروهبندی میکنند تا از نتایج خرد بیاهمیت جلوگیری شود. با این حال، پیادهسازی JetBrains معناشناسیهای خاص هر زبان را با دقت بیشتری در فرآیند کدنویسی گنجانده است.
حل بحران ذخیرهسازی بردار
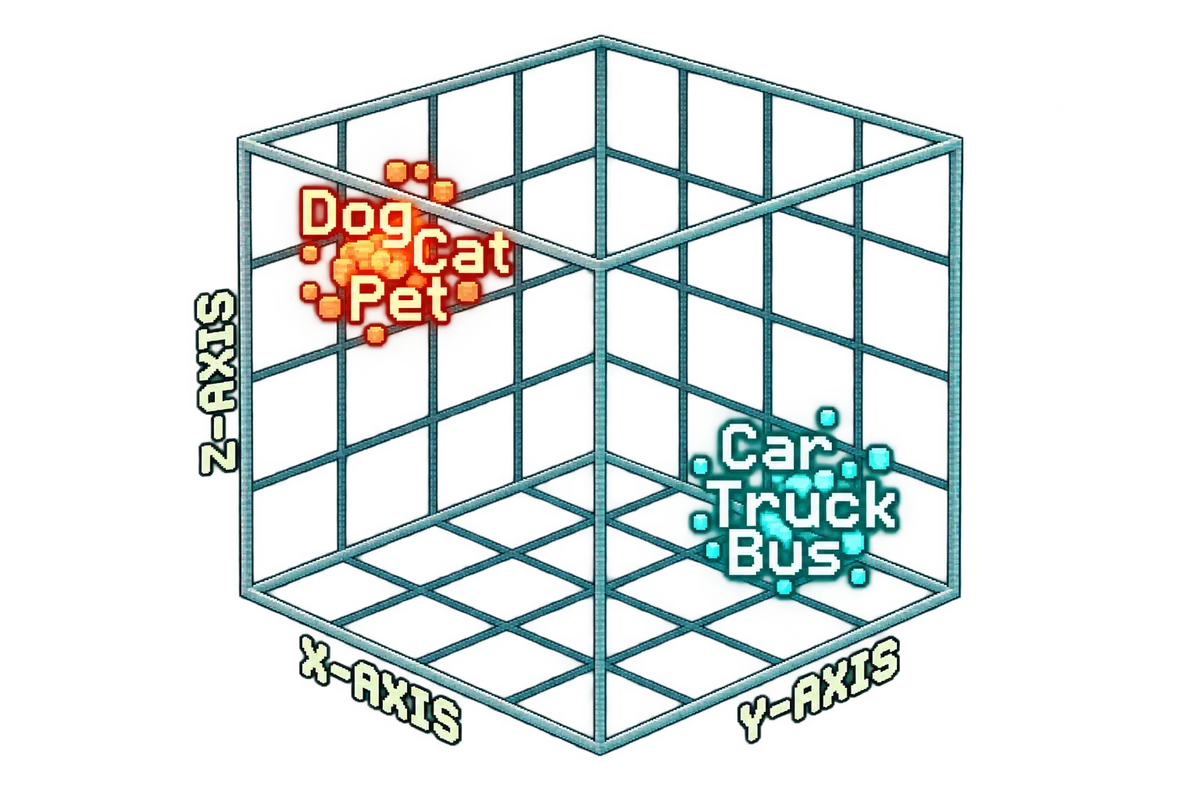
برداریسازی، متن را به لیستی از اعداد (یک بردار) در یک فضای با ابعاد بالا تبدیل میکند. در یک مخزن بزرگ، میلیونها تکه منجر به دهها گیگابایت داده ایندکس میشود. یک بردار با چند هزار بُعد در حالت اعشاری ۳۲ بیتی، حدود ۱۶ کیلوبایت فضا میگیرد. JetBrains با یک انتخاب روبرو بود: کاهش تعداد ابعاد یا کاهش دقت هر بُعد.
آنها دریافتند که حفظ تمام ۴۰۹۶ بُعد با دقت ۱ بیتی (کوانتش باینری)، عملکرد بهتری نسبت به حفظ تنها ۱۲۸ بُعد با دقت کامل ۳۲ بیتی دارد. استدلال آنها این است که هر بُعد مانند یک «پرسش» از متن است (مثلاً: «آیا این کد مربوط به مدیریت خطا است؟» یا «آیا با شبکه در ارتباط است؟»)؛ داشتن پاسخهای بله/خیر تقریبی برای ۴۰۰۰ پرسش، بسیار ارزشمندتر از پاسخهای دقیق برای تنها ۱۰۰ پرسش است. هیچ مقدار دقتی در چند بُعد باقیمانده نمیتواند اطلاعاتی را که از ابعاد دیگر حذف شده است، بازیابی کند.
این تغییر، معیار ریاضی جستوجو را از شباهت کسینوسی (Cosine Similarity) که نیازماد اندازه (Magnitude) است، به فاصله همینگ (Hamming distance) تغییر داد. این کار اجازه میدهد CPU بردارها را با عملیات ساده XOR و شمارش بیتها مقایسه کند و هزینه محاسباتی را از هزاران ضرب به حدود ۱۰۰ دستورالعمل در هر مقایسه کاهش دهد. کوانتش ساده است: مؤلفههای صفر یا مثبت به یک، و مؤلفههای منفی به صفر تبدیل میشوند.
محدودیتهای کوانتش باینری
در حالی که کوانتش باینری برای رتبهبندی کارآمد است، اما محدوده امتیازات شباهت را فشرده میکند. در بردارهای با دقت کامل، فاصله زیادی بین کدهای بیربط و کدهای تقریباً مشابه وجود دارد. اما در بردارهای باینری، تقریباً تمام امتیازها در یک باند باریک قرار میگیرند. بردارهای بیربط ممکن است صرفاً بر اساس شانس در نیمی از بیتها با هم موافق باشند، در حالی که جفتهای بسیار مرتبط ممکن است در دو-سوم بیتها توافق داشته باشند.
این موضوع «آستانهگذاری» (Thresholding) — یعنی دانستن اینکه چه زمانی یک نتیجه بیش از حد بیربط است و نباید نمایش داده شود — را تقریباً غیرممکن میکند. برای قابلیتهایی که کد را به طور خودکار و بدون پرسوجوی کاربر پیشنهاد میدهند (مانند پنلی که هنگام تایپ، پیادهسازیهای موجود را پیشنهاد میدهد)، JetBrains همچنان از اعداد اعشاری ۱۶ بیتی استفاده میکند تا فاصله کاربردی بین امتیازات مرتبط و نامرتبط حفظ شود.
بهینهسازی برای Monorepoها و حریم خصوصی
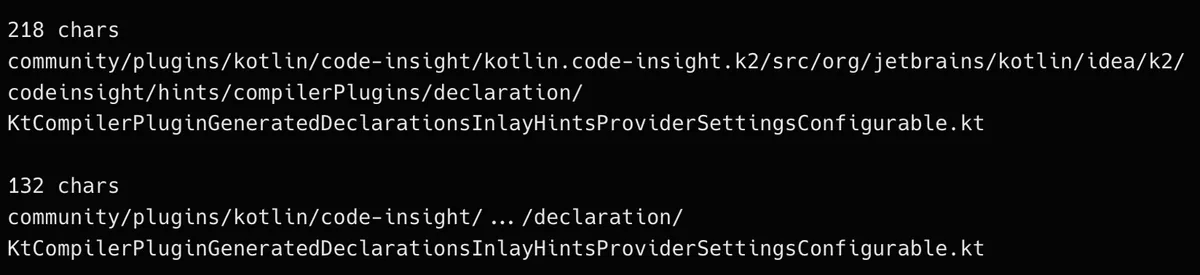
در Monorepoهای عظیم مانند IntelliJ IDEA که بیش از یک میلیون فایل دارد، مسیر فایلها میتواند از ۲۰۰ کاراکتر فراتر رود. میانه مسیر فایلهای منبع ۹ پوشه عمق دارد و طول مسیر آنها ۹۱ کاراکتر است؛ برخی حتی به ۲۱۸ کاراکتر میرسند. این مسیرها اغلب شامل سلسلهمراتب بستههای تکراری (مانند src/org/jetbrains/kotlin/idea/k2) هستند که نویز را به بردار اضافه میکنند.
JetBrains یک قانون «سقف مسیر» (Path-capping) را پیاده کرد که نام ماژول ابتدایی و دو بخش انتهایی (پوشه والد و نام فایل) را حفظ کرده و بخش میانی را با سه نقطه جایگزین میکند. اگر حتی ترکیب والد و نام فایل بیش از حد طولانی باشد، فقط نام فایل حفظ میشود. این کار تضمین میکند که مسیر فایل فضای بیشتری از خودِ کد را در مدل اشغال نکند.
برای مدیریت عدم تقارن بین پرسوجوهای کوتاه زبان طبیعی و تکههای طولانی کد، سیستم پرسوجوها را در دستورالعملهای خاصی میپیچد (مثلاً: «با توجه به این پرسوجوی جستوجو، کدی را پیدا کن که به آن پاسخ میدهد»). این کار بردار پرسوجو را با بردارهای سند در فضای برداری همراستا میکند. علاوه بر این، وقتی کاربر جستوجو را به یک زیرپوشه محدود میکند، آن محدوده با استفاده از همان تابع اختصاری و جداکننده تکههای ایندکس شده در متن پرسوجو رندر میشود تا بردار پرسوجو در منطقه درست قرار گیرد.
حریم خصوصی یک محدودیت طراحی اصلی بود. برای محافظت از مالکیت معنوی، Air Context کد منبع واقعی را روی سرورهای خود ذخیره نمیکند. در عوض، مختصات زیر را ذخیره میکند:
- مرجع خوشه (Cluster reference)
- نوع آیتم (Item type)
- مسیر فایل (File path)
- آفستهای شروع و پایان (Start and end offsets)
- مرجع بردار (Vector reference)
- فیلد متادیتای اختیاری
قطعه کد نهایی به صورت محلی روی دستگاه کاربر با استفاده از این آفستها بازسازی میشود. علاوه بر این، سیستم از مدلهای وزنهای باز (Open Weights) که روی GPUهای خود JetBrains اجرا میشوند استفاده میکند تا تضمین شود هیچ دادهای به ارائهدهندگان شخص ثالث مانند OpenAI یا گوگل ارسال نمیشود و هیچ دادهای برای آموزش مدلهای خارجی استفاده نمیگردد.
دستاوردهای مهندسی
این رویکرد چالش RAG را از «انتخاب مدل» به «مهندسی داده» تغییر میدهد. با اولویت دادن به ابعاد نسبت به دقت و استفاده از تجزیه ساختار-آگاه، تیم سیستمی ساخت که در آن عامل به جای ۱۰ نتیجه کاملاً مرتب شده، یک «محله» از نتایج مرتبط دریافت میکند. برای یک عامل استدلالی، این کافی است، زیرا عامل فارغ از رتبه داخلی، کاندیداهای برتر را میخواند.
این معماری ثابت میکند که مدلهای برداری وزنهای باز اکنون با APIهای میزبانیشده رقابت میکنند، به شرطی که خط لولههای پیشپردازش و کوانتش برای دامنه خاص کد منبع بهینه شده باشند. توسعهدهندگانی که به دنبال پیادهسازی سیستمهای مشابه هستند باید به جای افزایش صرف اندازه مدل، بر کارایی «بایت بر بردار» و یکپارچگی معنایی تکههای خود تمرکز کنند.
گام بعدی شما
- اگر در حال پیادهسازی RAG برای کد هستید، به جای مدلهای بزرگتر، روی کاهش «بایت بر بردار» و تکهبندی ساختار-آگاه تمرکز کنید.
- برای جستوجوهای سریع در مقیاس بالا، فاصله همینگ و کوانتش باینری را جایگزین شباهت کسینوسی کنید.
- از مدلهای وزنهای باز برای حفظ حریم خصوصی دادههای کد در محیطهای سازمانی استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو