تصور کنید صدها صفحه از یک کتاب تخصصی یا اسلایدهای یک ارائه را دارید که دسترسی به متن آنها مسدود است و تنها راه استخراج دادهها، تایپ دستی و طاقتفرساست. ocr-it، افزونهای تخصصی برای مرورگر کروم که در ۲۴ اوت ۲۰۲۶ منتشر شد، این بنبست را با تثبیت یک ناحیه مشخص از صفحه و خودکارسازی فرآیند استخراج متن روی سختافزار کاربر میشکند.
بسیاری از نمایشدهندههای سند در وب — مانند اسلایدهای جاسازیشده یا کتابخوانهای اختصاصی — بهطور عمدی انتخاب متن را مسدود میکنند تا از محتوا محافظت کنند یا چون منبع اصلی تنها یک تصویر تخت است. این موضوع برای پژوهشگرانی که میخواهند حجم زیادی از دادههای تخصصی را برای خلاصهسازی یا تحلیل به یک مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — بدهند، یک مانع بزرگ است. با تبدیل این اسناد محبوس در یک نمایشدهنده به یک فایل متنی، کاربر میتواند نتایج را به Claude یا ChatGPT بسپارد تا در آنها جستوجو کند یا سؤال بپرسد.
برخلاف اکثر ابزارهای نویسهخوانی نوری (OCR) — شبیه به چشم انسان که حروف را میبیند و به کد دیجیتال تبدیل میکند — که دادهها را به سروری دوردست میفرستند، ocr-it یک نسخه محلی از Tesseract را در خود جای داده است. این رویکرد محلی یادآور پیشرفتهای اخیر در مدلهای تخصصی است که دقت استخراج متن از اسناد تاریخی را به ۹۷٪ رساندهاند و بهرهوری پژوهشی را دوچندان کردهاند. طبق مستندات این ابزار، این یعنی هیچ کلید API یا درخواست شبکهای لازم نیست و هیچ تصویری از سختافزار کاربر خارج نمیشود که حریم خصوصی اسناد حساس را بهطور کامل تضمین میکند. این افزونه بهطور کلی هیچ درخواست خروجی (outbound request) ارسال نمیکند.
همانطور که در تحلیلهای قبلی ما دربارهی ابزارهای بهرهوری مبتنی بر هوش مصنوعی اشاره کردیم، جابهجایی پردازش از ابر به لبه (Edge)، امنیت دادهها را به اولویت اول تبدیل کرده است.
مکانیزم تصویربرداری
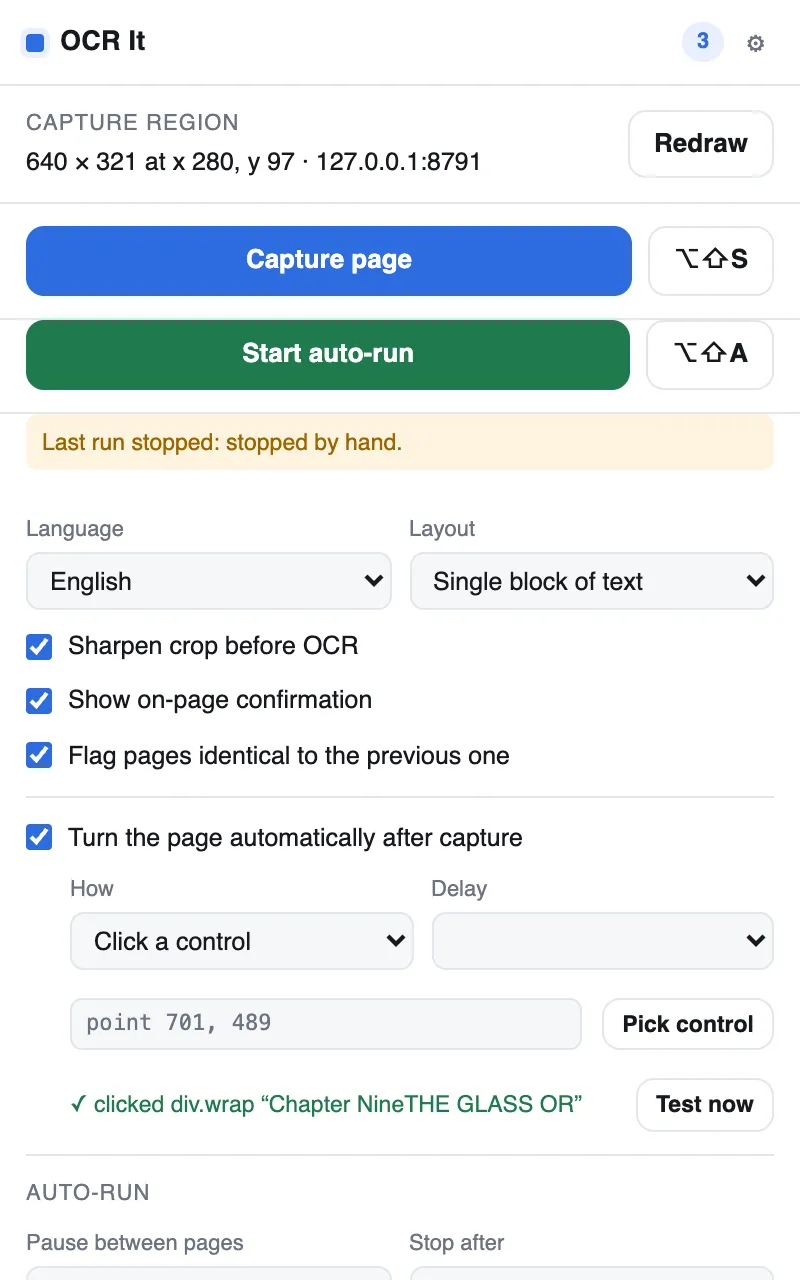
این ابزار به کاربر اجازه میدهد یک بار ناحیه مورد نظر را تعریف کند. با فشردن کلیدهای ⌥⇧R، میتوانید کادری را روی متن بکشید. پیش از ذخیره، امکان جابهجایی کادر، تغییر اندازه با دستگیرهها یا جابهجایی تکپیکسلی با کلیدهای جهتنما وجود دارد (با نگه داشتن کلید ⇧ برای تغییر اندازه). با فشردن Enter، این ناحیه تثبیت میشود.
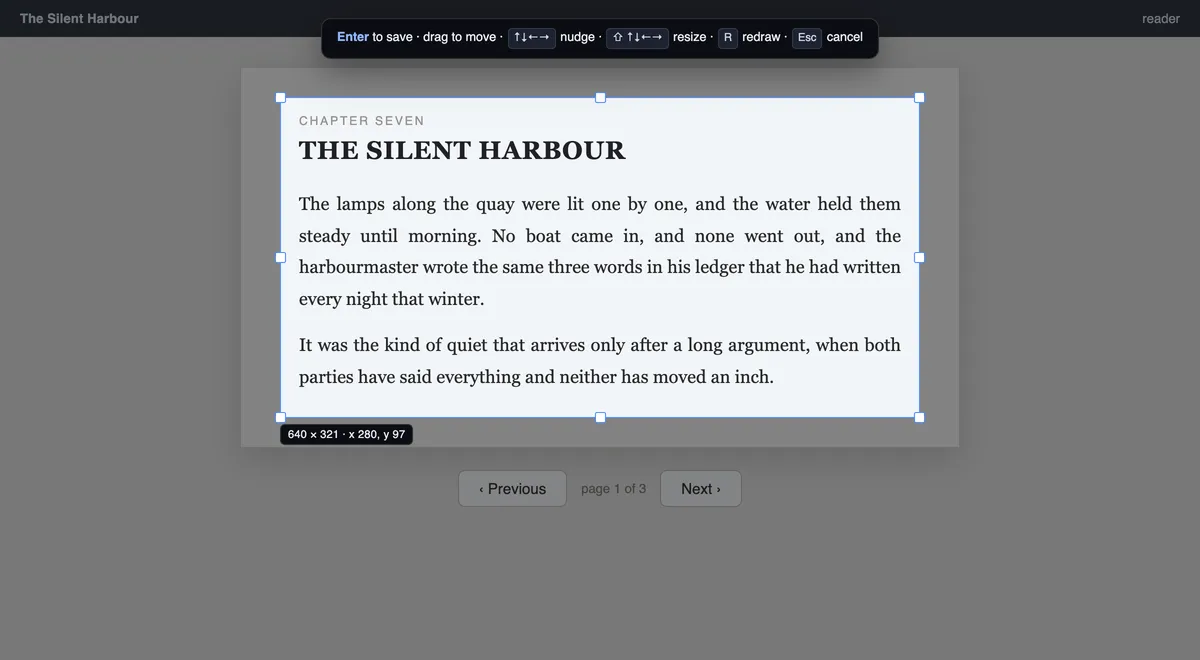
توصیه میشود کادر را کمی داخلیتر از حاشیههای متن رسم کنید. چون هر چیزی درون مستطیل خوانده میشود، این کار باعث میشود شماره صفحات و سرتیترهای تکراری در متن نهایی وارد نشوند و خروجی تمیزتر باشد.
پس از تثبیت ناحیه، یک کلید میانبر (⌥⇧S) اسکرینشات دقیقی از همان مستطیل میگیرد. طبق گزارش توسعهدهندگان، تصویر بلافاصله گرفته شده و OCR در پسزمینه اجرا میشود تا هیچ تأخیری بین صفحات نباشد. تصاویر در صف قرار میگیرند و یک نشانگر روی آیکون نوار ابزار، که همزمان به عنوان شمارنده صفحه عمل میکند، تعداد صفحاتی که هنوز در حال پردازش هستند را نمایش میدهد.
خودکارسازی گردش کار
برای اسناد طولانی، این افزونه یک حالت کاملاً خودکار دارد. با فشردن ⌥⇧A، ابزار وارد یک حلقه میشود: صفحه فعلی را ثبت میکند، دستور ورق زدن میدهد و این روند را تا پایان سند تکرار میکند. برای توقف این فرآیند، کافی است کلید Esc را روی صفحه بزنید.
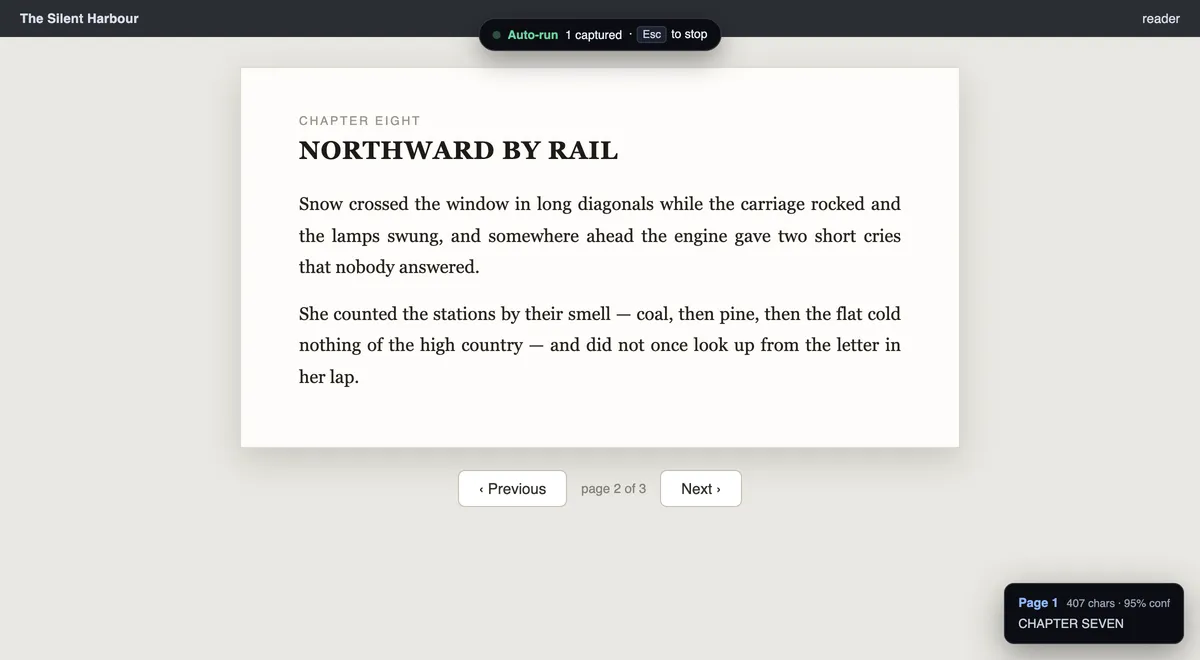
برای مدیریت ورق زدن، ocr-it بهجای استفاده از انتخابگرهای CSS، از یک سیستم کنترل «مبتنی بر نقطه» استفاده میکند. کاربر روی گزینه Pick control کلیک کرده و سپس روی دکمه «صفحه بعد» در نمایشدهنده کلیک میکند. افزونه بهجای یک انتخابگر CSS، مختصات دقیق آن نقطه را ذخیره میکند. قابلیت Test now اجازه میدهد پیش از شروع یک اجرای طولانی، یک دستور پیشروی را بدون ثبت تصویر ارسال کنید؛ این ویژگی نتیجه را گزارش میدهد و استفاده از آن پیش از شروع عملیات توصیه میشود.
چرا کنترلهای مبتنی بر نقطه؟
استفاده از نقطه ذخیرهشده سه مزیت فنی حیاتی نسبت به انتخابگرهای استاندارد دارد:
- تابآوری در برابر DOM: یک نقطه ذخیرهشده در برابر رندرهای مجدد DOM که معمولاً انتخابگرهای CSS را باطل میکنند، مقاوم است.
- آیفریمهای Cross-Origin: اکثر کتابخوانهای جاسازیشده در iframeها هستند. انتخابگرهای استاندارد فریم بالایی نمیتوانند به عناصر داخل یک iframe با منشأ متفاوت دسترسی داشته باشند. این افزونه نقطه را به هر فریم ارائه میدهد؛ فریم مالک از طریق پیمایش اجداد هممنشأ یا دریافت آفستها از طریق postMessage آن را شناسایی میکند. (لازم به ذکر است که از window.screenX استفاده نشده زیرا این مقدار پنجره مرورگر را گزارش میدهد، نه فریم داخلی یک iframe را).
- Shadow DOM: دستور
document.querySelectorنمیتواند داخل یک shadow root را ببیند، اما سیستم مبتنی بر نقطه از طریق shadow rootها به نزدیکترین کنترل واقعی میرسد.
هنگام ورق زدن، افزونه یک توالی کامل از pointerdown $
ightarrow$ mousedown $
ightarrow$ pointerup $
ightarrow$ mouseup $
ightarrow$ click را شبیهسازی میکند تا با تمام نمایشدهندهها سازگار باشد؛ چه آنهایی که با pointerdown فعال میشوند و چه آنهایی که منتظر یک کلیک کامل هستند.
کنترل کیفیت و خروجی
برای جلوگیری از دست رفتن دادهها، یک مسیر بازرسی بصری تعبیه شده است. هر صفحه ثبتشده با یک تصویر بندانگشتی (Thumbnail) از برش گرفته شده نمایش داده میشود تا اگر کادر جابهجا شده یا صفحهای ورق نخورده باشد، کاربر سریعاً متوجه شود و مجبور نباشد بعد از ۸۰ صفحه متوجه خطا شود.
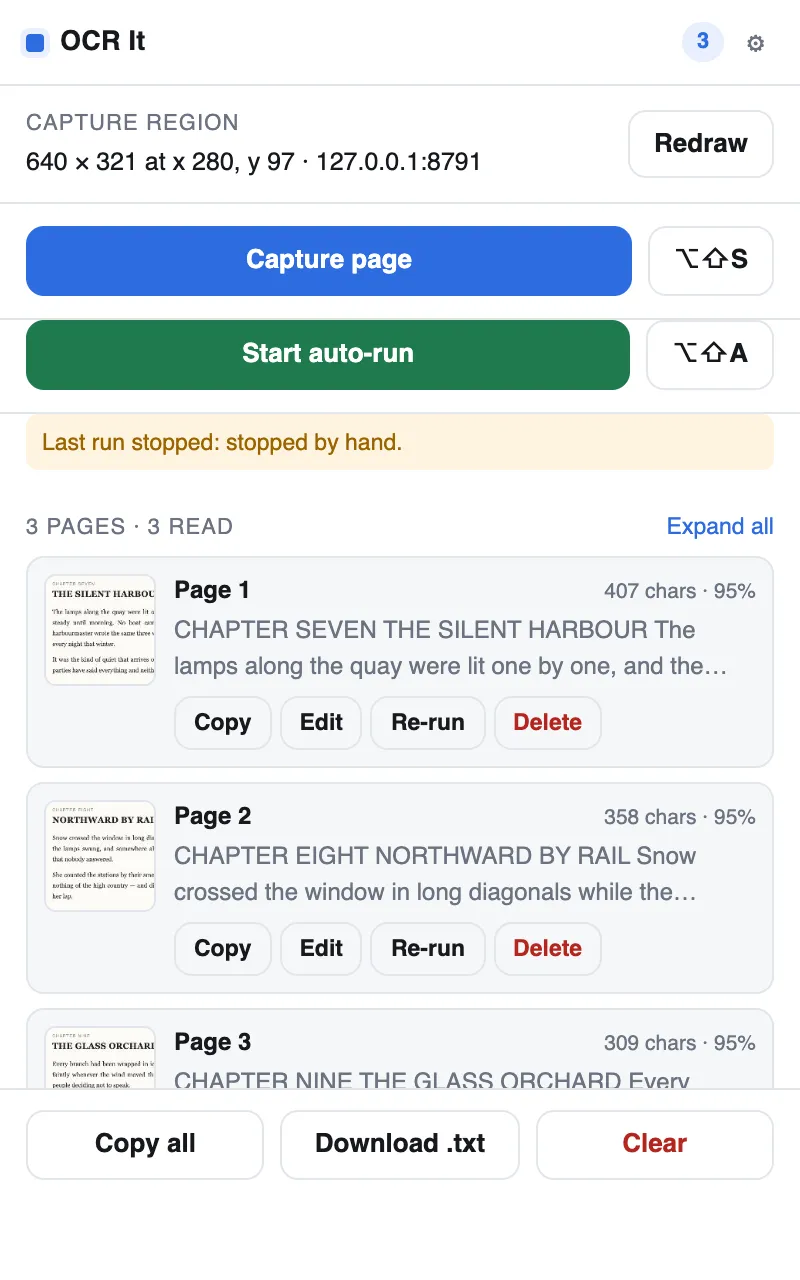
کاربران میتوانند متن OCR را در همانجا ویرایش کنند تا خطاها را اصلاح نمایند. اگر صفحهای بد خوانده شده باشد، میتوان آن را بهتنهایی دوباره اجرا کرد. در هنگام خروجی، توابع Copy all و Download .txt صفحات را به ترتیب و با جداکننده --- page N --- مرتب میکنند.
اگر صفحهای به عنوان DUPLICATE علامت بخورد، یعنی متن آن با صفحه قبلی یکسان است که تقریباً همیشه نشاندهنده شکست در ورق زدن سند و ثبت مجدد همان صفحه است.
پیکربندی فنی
کاربران میتوانند موتور OCR را از طریق پنل تنظیمات بهینه کنند:
- انتخاب زبان: انگلیسی، پرتغالی و اسپانیایی بهصورت پیشفرض موجود هستند. زبانهای دیگر Tesseract را میتوان با اجرای دستور
npm run vendor -- [language code](مثلاًfraبرای فرانسوی،deuبرای آلمانی،jpnبرای ژاپنی) و بهروزرسانی آرایهLANGUAGESدر فایلsrc/shared.jsاضافه کرد. - حالتهای چیدمان: حالت Single block برای تکستونی و حالت Auto برای چیدمانهای ترکیبی است.
- شارپ کردن تصویر: این قابلیت تصویر را حدود ۲ برابر بزرگنمایی کرده و به یک طیف خاکستری کشیده تبدیل میکند. این ویژگی برای نمایشگرهای غیر رتینا شدیداً توصیه میشود.
- تنظیمات اجرای خودکار: کاربران میتوانند وقفه بین صفحات، تعداد تکرارهایی که باعث توقف اجرا میشود و سقف سخت تعداد صفحات را تنظیم کنند.
در مورد مدلهای زبانی، این ابزار از مدلهای «بهترین» (best) استفاده میکند که به اعداد صحیح کوانتیزه شدهاند (@tesseract.js-data/<code>/4.0.0_best_int) و دقیقتر از نسخههای سریع هستند. مدل انگلیسی با ۲.۹ مگابایت بزرگترین و مدل فرانسوی با ۰.۷ مگابایت جزو کوچکترینهاست. کاربران حتی میتوانند زبانها را ترکیب کنند (مثلاً eng+por) تا صفحات دو زبانه را بخوانند، هرچند این کار سرعت و دقت را کمی کاهش میدهد. برای حذف یک زبان، باید فایل .gz مربوطه را از vendor/lang/ و ورودی آن را از LANGUAGES پاک کرد.
قابلیت اطمینان و محدودیتها
برای جلوگیری از حلقههای بینهایت، چندین تریگر ایمنی وجود دارد. اجرا در موارد زیر متوقف میشود:
- تشخیص تکرار: وقتی متن بعد از دو صفحه یکسان، تغییر نکند.
- شکست در ورق زدن: وقتی صفحه بلافاصله ورق نخورد (دلیل شکست از طریق یک toast روی صفحه گزارش میشود).
- سقف صفحات: رسیدن به حد پیشفرض ۳۰۰ صفحه.
- تغییر محیط: بستن تب یا ریاستارت شدن کروم.
وقتی ورق زدن شکست میخورد، افزونه یک حکم صادر میکند: «کنترل صفحه بعد انتخاب نشده»، «نمایشدهنده جاسازیشده مالک این نقطه است» (یعنی یک پلاگین مثل PDF viewer کروم است)، «تنها پسزمینه صفحه است» یا «فریم تودرتو غیرقابل دسترس است» (فریمی که امکان تزریق کد در آن نبود). چون هدف یک نقطه ثابت است، تغییر اندازه پنجره یا تغییر زوم در حین اجرا، هم کنترل ورق زدن و هم ناحیه ثبت تصویر را مختل میکند.
بر اساس مستندات گیتهاب، صحت ابزار به کیفیت منبع بستگی دارد. متنهای رندر شده با وضوح بالا معمولاً بالای ۹۰٪ دقت دارند، اما اسکنهای کمکیفیت یا دستنویسها نیاز به پاکسازی دستی دارند. این چالش استخراج متن از منابع بصری پیچیده، در ابزارهای پیشرفتهتری مانند Palimpsest که برای استخراج متن از ویدیوهای اسکرولشونده طراحی شده نیز با استفاده از الگوریتمهای دقیقتر مدیریت شده است.
یک محدودیت مهم، نمایشدهنده PDF داخلی کروم است. چون این بخش یک پلاگین است، افزونهها نمیتوانند کد تزریق کنند تا ورق زدن را خودکار کنند. کاربران باید در این حالت کلید Page-down را دستی بزنند در حالی که افزونه ثبت OCR را مدیریت میکند. برای PDFهای محلی (file:///…)، کاربران باید به chrome://extensions $
ightarrow$ Details رفته و گزینه "Allow access to file URLs" را فعال کنند.
طراحی معماری
به دلیل نبود DOM و Worker در Service Workerهای MV3 کروم، ocr-it پردازشهای سنگین را به یک offscreen document میسپارد. خط لوله به این ترتیب است:
۱. background.js: مدیریت کلیدهای میانبر، خط لوله ثبت، صف سریال OCR و حلقه اجرای خودکار.
۲. offscreen document: برش کانواس، بزرگنمایی، تبدیل به خاکستری و Worker مربوط به Tesseract.
۳. overlay.js: مدیریت انتخابگر ناحیه/نقطه، HUD روی صفحه و آبشار آفستهای بین فریمها.
۴. popup: مدیریت لیست صفحات، ویرایش، تنظیمات و خروجی.
۵. shared.js: طرح ذخیرهسازی و توابع کمکی مشترک بین Worker و پاپآپ.
این معماری تضمین میکند که رابط کاربری (HUD) ابزار، دو فریم قبل از فراخوانی chrome.tabs.captureVisibleTab ناپدید شود تا در متن نهایی ظاهر نشود. ناحیه در پیکسلهای CSS نسبت به viewport ذخیره میشود؛ در زمان ثبت، عرض اسکرینشات بر innerWidth فعلی تقسیم میشود تا تفاوتهای زوم و رتینا بدون تکیه بر DPR ذخیرهشده، بهدرستی مدیریت شوند.
ثبتها سریال شدهاند و OCR هر بار یک شغل را انجام میدهد تا از خرابی لیست صفحات جلوگیری شود. برشهای اندازه کامل پس از خواندن موفقآمیز صفحه دور ریخته میشوند و تنها تصویر بندانگشتی برای تایید باقی میماند. برای زنده نگه داشتن Service Worker در اجراهای طولانی، خواندنهای storage به عنوان keep-alive عمل میکنند و یک Alarm یک دقیقهای در صورت بازیافت Worker، حلقه را ریاستارت میکند. یک اجرا با تغییر یک توکن لغو میشود که حلقه در هر await آن را بررسی میکند تا در یک نقطه توقف مطمئن متوقف شود.
نصب و آزمایش
نصب این ابزار نیازمند دانلود مخزن یا استفاده از git clone است. کاربران باید chrome://extensions را باز کرده، Developer mode را فعال کنند و از "Load unpacked" برای انتخاب پوشه استفاده کنند. هیچ مرحله Build خاصی نیاز نیست و npm install تنها برای اجرای تستها یا بهروزرسانی Tesseract لازم است. توصیه میشود chrome://extensions/shortcuts بررسی شود تا مطمئن شوید کلیدهای میانبر به دلیل تداخل توسط کروم خالی نشده باشند.
در هنگام نصب، افزونه هیچ دسترسی به سایتها نمیخواهد. برای ثبتهای تک، از activeTab استفاده میکند که کروم هنگام فشردن کلید میانبر آن را اعطا میکند. دسترسیهای دائمی تنها از طریق دکمه Allow در پاپآپ برای اجراهای خودکار یا تعامل با iframeهای Cross-origin درخواست میشود.
پروژه شامل یک مجموعه تست جامع است. با استفاده از npm test، سیستم تست افزونه را در یک کروم بدون سر (headless) از طریق پروتکل DevTools نصب میکند. این سیستم همه چیز، از رویدادهای موس مصنوعی برای کشیدن ناحیه تا تشخیص تکرار و پیشروی خودکار در صفحات ساده، iframeهای Cross-origin و shadow rootهای باز را بررسی میکند. همچنین چک میکند که manifest هیچ دسترسی میزبان (host access) درخواست نکند و یک کلیک روی نوار ابزار برای ثبتهای ساده از طریق activeTab کافی باشد.
برای کروم ۱۳۷ به بالا، سیستم تست از Extensions.loadUnpacked و --enable-unsafe-extension-debugging استفاده میکند زیرا --load-extension نادیده گرفته میشود. از آنجایی که کروم headless نمیتواند اعلانهای دسترسی را نشان دهد، تستهای رفتاری از نسخهای از افزونه استفاده میکنند که دسترسیها در آن تعبیه شده است، در حالی که تستهای دسترسی از Extensions.triggerAction برای اثبات کارکرد مسیر بدون دسترسی استفاده میکنند.
محدودیتهای نهایی
برخی محیطها مانند صفحات chrome://، وباستور و صفحات افزونههای دیگر غیرقابل دسترس هستند. همچنین تنها viewport مرئی قابل ثبت است. علاوه بر این، کروم تعداد اسکرینشاتها را در ثانیه محدود میکند؛ افزونه این مشکل را با تلاش مجدد (retry) با مکانیزم backoff حل کرده که صرفاً باعث صف شدن ثبتها میشود.
این چرخش به سمت ابزارهای کاربردی محلی، بازتابدهنده روندی گستردهتر در اکوسیستم هوش مصنوعی است. این رویکرد با تلاش برای افزودن بینایی و استدلال محلی به مدلهای کدنویسی همسو است تا وابستگی به سرورهای مرکزی کاهش یابد. کاربران بهجای تکیه بر پلتفرمهای ابری همهکاره، به ابزارهای «پل» روی میآورند تا دادههای قفلشده و نامرتب را برای مدلهای استدلالی سطح بالا آماده کنند.
برای یک پژوهشگر، این یعنی هزینه دیجیتالی کردن یک آرشیو ۳۰۰ صفحهای از چندین ساعت کار دستی به چند دقیقه اتوماسیون بدون نظارت کاهش مییابد.
گام بعدی شما
- اگر با اسناد PDF یا اسلایدهایی سر و کار دارید که اجازه کپی متن را نمیدهند، مخزن ocr-it را در گیتهاب بررسی و نصب کنید.
- برای افزایش دقت، حتماً گزینه Image Sharpening را در تنظیمات فعال کنید، بهخصوص اگر از نمایشگرهای قدیمی استفاده میکنید.
- خروجی متنی را پیش از ارسال به LLM، با استفاده از لیست بندانگشتی ابزار بازبینی کنید تا از عدم تکرار صفحات مطمئن شوید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو