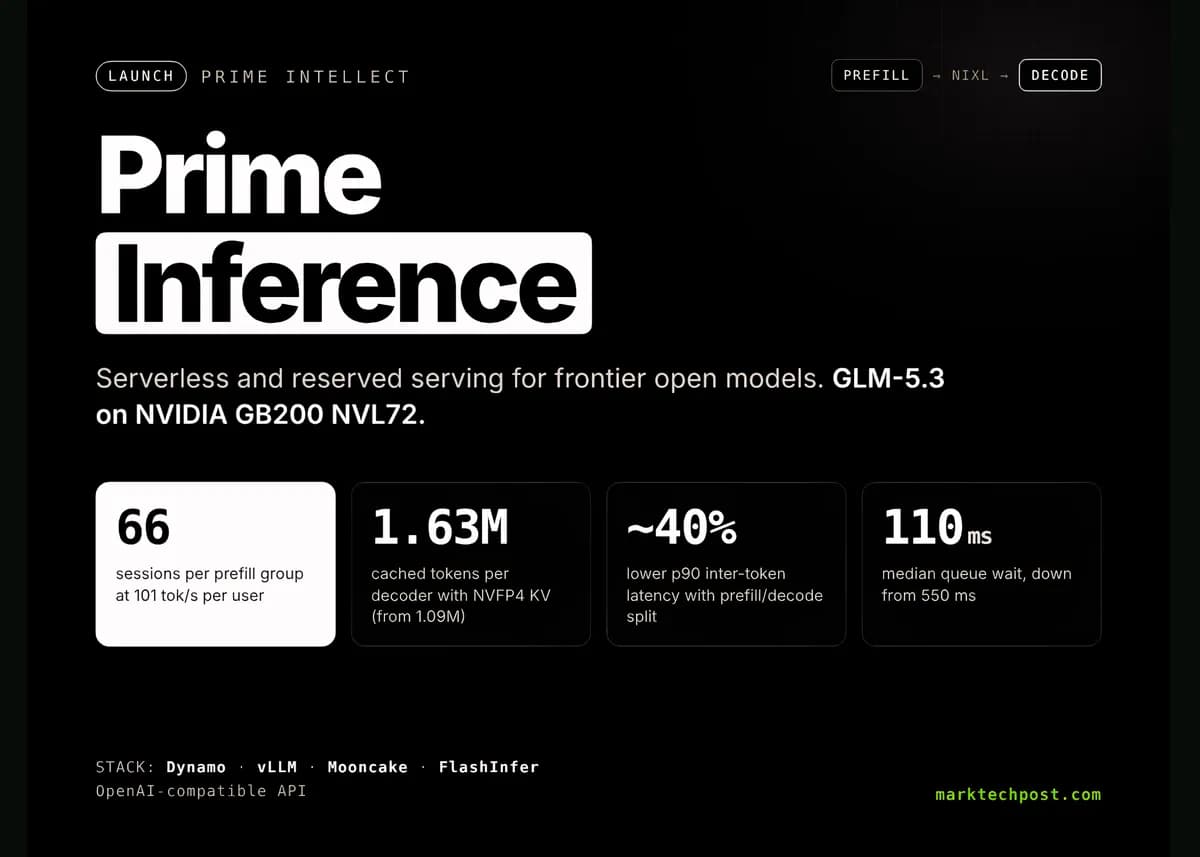
تأخیر در پاسخدهی، بزرگترین مانع برای تبدیل عاملهای هوش مصنوعی از نمونههای آزمایشگاهی به ابزارهای تولیدی است. شرکت Prime Intellect مدعی است که توانسته است تأخیر p90 بینتوکنی را در بارهای کاری عاملمحور (Agentic) تا ۴۰٪ کاهش دهد. این هدف بهطور خاص برای رفع گلوگاه اصلی در تولیدات AI، یعنی تأخیر در نوبتهای گفتگوی عاملمحور با بافتهای متنی طولانی (Long-context) تعریف شده است.
به نقل از گزارشهای فنی این شرکت، پلتفرم Prime Inference در ۲ اکتبر ۲۰۲۶ راهاندازی شد تا ظرفیتهای رزرو شده و نقاط انتهایی بدون سرور (Serverless) را برای مدلهای پیشرو با وزنهای باز (Open Weights) فراهم کند. این رویکرد در راستای تلاشهای گستردهتر برای بهینهسازی مدلهای باز است، مشابه آنچه در پروژه Magnitude برای دو برابر کردن سرعت استنتاج مدلهای باز مشاهده کردیم. مشکل اصلی در اکثر پشتههای سرویسدهی این است که وقتی یک عامل، توکنهای کوتاهی را به پرامپتهای عظیم اضافه میکند، باعث ایجاد جهش در صفهای انتظار (Queue Spikes) میشود.
همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی حافظه در مدلهای زبانی اشاره کردیم، مدیریت بهینه KV Cache کلید حل این بحران است. Prime Intellect لایه سرویسدهی را بهعنوان تکه نهایی یک پشته آموزشی باز میبیند؛ به این معنا که ردپاهای تولیدی (Production Traces) مستقیماً به ابزارهایی مانند prime-rl، تأییدکنندهها (Verifiers) و محیطهای سندباکس بازمیگردند تا یک چرخه بسته بین استقرار و پسآموزش ایجاد شود.
مقیاس و زیرساخت
بر اساس مستندات داخلی، Prime Inference پیش از عرضه عمومی، روزانه نزدیک به یک تریلیون توکن را بهصورت داخلی پردازش میکرد. این ترافیک عظیم حاصل اجرای RL Rollouts، تولید دادههای مصنوعی، ارزیابیها و عاملهای کدنویسی طولانیمدت بود. این تمرکز بر کاهش هزینههای عملیاتی در کارهای پیچیده، یادآور پروژه HydraFusion گیتهاب است که هزینه استنتاج کدنویسی را تا ۶۷٪ کاهش داد.
این پلتفرم برای قابلیت اطمینان بالا طراحی شده و از زمان راهاندازی، پایداری ۱۰۰ درصدی (Uptime) را گزارش کرده است. این سیستم از قابلیت failover خودکار در چندین مرکز داده (Data Center) استفاده میکند تا ترافیک را به سمت استقرارهای سالم هدایت کند. برای توسعهدهندگان، این پلتفرم بهطور کامل با OpenAI سازگار است؛ به گونهای که هر SDK مربوط به OpenAI را میتوان به آدرس https://api.pinference.ai/api/v1 متصل کرد.
کالبدشکافی فنی
طبق گزارش marktechpost.com، این پلتفرم از ترکیب سختافزاری و نرمافزاری پیشرفتهای بهره میبرد:
- سختافزار: در حال حاضر روی NVIDIA Blackwell (مدل GB200 NVL72) اجرا میشود و پشتیبانی از Vera Rubin در نقشه راه آینده ذکر شده است.
- نرمافزار: ترکیبی از NVIDIA Dynamo، vLLM، Mooncake و FlashInfer. این پشته با همکاری Inferact و NVIDIA ساخته شده و اصلاحات آن به صورت Upstream به جامعه متنباز ارائه شده است.
- مسیریابی: ابزار Dynamo مسیریابی آگاه از KV را مدیریت میکند. این ابزار میزان همپوشانی پیشوندهای کششده (Cached Prefix Overlap) را در مقابل کارهای موجود در صف میسنجد تا اطمینان حاصل شود که جلسات بین نوبتهای گفتگو روی یک رمزگشای واحد باقی بمانند. همچنین Mooncake یک لایه دوم KV در DRAM میزبان اضافه میکند.
برای بهینهسازی بارهای کاری عاملمحور — جایی که هر نوبت ممکن است ۶ هزار توکن به یک پرامپت ۱۴۰ هزار توکنی اضافه کند — این شرکت استراتژی جداسازی پیشپُرکردن (Prefill) و رمزگشایی (Decoding) را پیاده کرد. در این ساختار، عملیات پیشپُرکردن و رمزگشایی روی گروههای مجزای GPU اجرا میشوند و رمزگشاها دادههای KV محاسبهشده را از طریق NIXL فراخوانی میکنند. Prime Intellect این ترکیب خاص را با استفاده از SemiAnalysis AgentX و تزریق ورودهای سرد (Cold Arrivals) بنچمارک کرده است. این مدیریت دقیق منابع سختافزاری، شباهتهای ساختاری با راهکار TauGrid مایکروسافت برای سادهسازی مدیریت GPU در محیطهای کوبرنتیز دارد.
بنچمارکهای عملکردی
آزمایش مدل GLM-5.3 روی سختافزار GB200 NVL72 نشان داد که نسبت ۱ به ۴ بین پیشپُرکردن و رمزگشایی، ظرفیت کاربر را به حداکثر میرساند. در این حالت، سیستم توانست ۶۶ جلسه را بهازای هر گروه پیشپُرکردن مدیریت کند، در حالی که سرعت هر کاربر روی ۱۰۱ توکن در ثانیه و خروجی هر GPU روی ۱۰۰ توکن در ثانیه ثابت ماند.
بهینهسازیهای کلیدی دیگر عبارتند از:
- توپولوژی: ساختار DEP8 ظرفیت حافظه پیشوند (Prefix-cache) قابل استفاده را تقریباً ۵ برابر بیشتر از TEP8 روی همان سختافزار فراهم میکند.
- مدیریت صف: کاهش توکنها در هر گام از ۸ هزار به ۴ هزار بهازای هر GPU، زمان انتظار میانه صف را از ۵۵۰ میلیثانیه به ۱۱۰ میلیثانیه رساند و زمان میانه تا اولین توکن (TTFT) حدود ۲۰٪ کاهش یافت.
- فشردهسازی KV: استفاده از NVFP4 حجم هر ردیف حافظه MLA را از ۵۷۶ به ۳۵۲ بایت کاهش داد و تعداد توکنهای ذخیرهشده در هر رمزگشا را از ۱.۰۹ میلیون به ۱.۶۳ میلیون توکن رساند.
- سرعت کرنل: یک کرنل native sparse-MLA توانست در ۱۵ توکن پرسوجو به سرعت ۱۲.۰ میکروثانیه برسد، در حالی که این مقدار در حالت staged برابر ۱۷.۷ و در حالت FP8 برابر ۱۳.۷ میکروثانیه بود.
- چیدمان: ساختار BLHNC تعداد توصیفگرهای انتقال (Transfer Descriptors) را از ۱۹,۵۵۹ به حدود ۱,۹۴۰ کاهش داد و میانگین زمان انتقال را از ۱۴۶ میلیثانیه به ۷۸ میلیثانیه رساند.
برای رفع خطاهای رایج در فراخوانی ابزارها (Broken Tool Calls)، تیم توسعه یک سازنده تگ ساختاری را برای فرمت ابزار GLM به Dynamo اضافه کرد. با استفاده از xgrammar در vLLM، سیستم توکنهایی را که با طرحواره (Schema) ابزار در تضاد هستند ماسک میکند و نرخ خطای فراخوانی ابزار را به نزدیک صفر میرساند. آنها همچنین باگهای تجزیه (Parsing) را برطرف کردند؛ برای مثال مشکلی که در آن کاراکتر < در داخل کدها بهصورت اشتباه رمزگشایی میشد.
این چرخش به سمت سرویسدهی جداساز شده، معیار میزبانی مدلهای باز را تغییر میدهد. Prime Intellect ثابت کرد که با فاصله گرفتن از تخصیص یکپارچه (Monolithic) GPU و استفاده از مسیریابی تخصصی و مدیریت حافظه KV، میتوان بدون تحمل جریمههای تأخیر در پنجرههای متنی طولانی، حلقههای عاملمحور با توان عملیاتی بالا را پشتیبانی کرد.
گام بعدی شما
- توسعهدهندگان میتوانند در حال حاضر با تغییر نقطه اتصال (Endpoint) در SDKهای OpenAI به api.pinference.ai، این نقاط انتهایی را تست کنند.
- بررسی مستندات vLLM برای پیادهسازی xgrammar جهت کاهش خطاهای Tool Call در پروژههای داخلی.
- رصد نقشه راه Prime Intellect برای استفاده از قابلیتهای آتی مانند استنتاج دستهای (Batch Inference) و استقرار اختصاصی با یک کلیک (One-click Dedicated Deployments).
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو