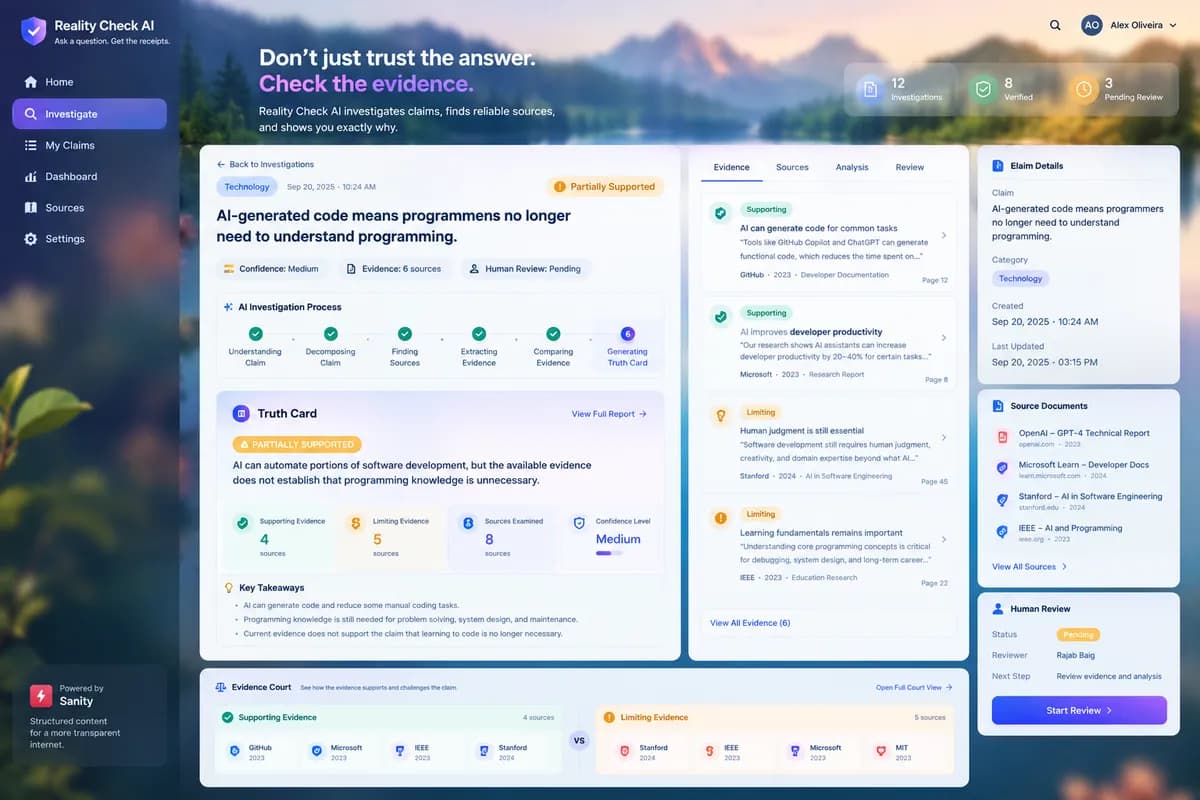
یک پاسخ متقاعدکننده از هوش مصنوعی لزوماً به معنای درست بودن آن نیست، حتی اگر لحنی مقتدرانه داشته باشد. این نقص بنیادین، دلیل خلق Reality Check AI است که در ۲۳ سپتامبر ۲۰۲۶ معرفی شد تا خروجیهای مدلها را نه به عنوان حقیقت نهایی، بلکه نقطه شروع یک بازرسی ساختاریافته ببیند. این اپلیکیشن تأکید میکند که یک پاسخ تولید شده توسط AI میتواند حتی زمانی که شواهد ضعیف یا منابع قدیمی هستند، متقاعدکننده به نظر برسد.
به جای ارائه یک پاسخ ساده و متنی، این سیستم یک «کارت حقیقت» (Truth Card) ساختاریافته ایجاد میکند. این کارت شامل جزئیات دقیقی است: ادعای اصلی، تفسیر مدل، شواهد تأییدکننده و ردکننده، اطلاعات کامل منابع، بندهای استخراجشده (excerpts)، تحلیل هوش مصنوعی، سطوح اطمینان و وضعیتهای بازبینی انسانی و تأیید است.
بسیاری از کاربران با هوش مصنوعی مثل یک پیشگو رفتار میکنند؛ سؤالی میپرسند (مثلاً «آیا این موضوع درست است؟») و پاسخی صفر و یکی (درست یا غلط) میگیرند. این رویکرد در شرایط خاص شکست میخورد: زمانی که ادعاها مبهم باشند، شواهد ضعیف باشند، منابع با یکدیگر اختلاف نظر داشته باشند، منبع قدیمی شده باشد، هوش مصنوعی ادعا را اشتباه بفهمد یا نتیجهگیری مدل فراتر از آنچه شواهد واقعاً میگویند باشد. همانطور که در تحلیل قبلی ما دربارهی شکست عاملهای هوش مصنوعی در اجرای فرآیندهای پیچیده اشاره کردیم، مشکل اصلی نبودِ زنجیره شواهد است. Reality Check AI تمرکز را از «پاسخ» به «ردپای شواهد» تغییر میدهد. برای مثال، در حالی که یک چتبات معمولی به ادعای «حالت تاریک (Dark Mode) در نمایشگرهای OLED باعث صرفهجویی در باتری میشود» صرفاً پاسخ «بله» میدهد، Reality Check AI میپرسد: «چه شواهد دقیقی از این ادعای خاص حمایت میکنند؟»
تصور کنید با این ادعا روبرو شوید که «یادگیری برنامهنویسی بیفایده است چون هوش مصنوعی میتواند کد بنویسد». یک چتبات استاندارد ممکن است یک نظر کلی و عمومی بدهد. اما Reality Check AI یک «کارت حقیقت» میسازد که ادعا را از شواهد جدا کرده و رابطه دقیق میان آنها را حفظ میکند.
مکانیزم گراف شواهد
این سامانه به جای تولید یک پاسخ متنی ساده، یک گراف شواهد میسازد. این گراف از یک سلسلهمراتب سختگیرانه پیروی میکند: «ادعا ← شواهد ← منبع». این ساختار تضمین میکند که هیچ نتیجهگیریای بدون لینک مستقیم به یک بند قابلتأیید از منبع وجود نداشته باشد. در این اپلیکیشن، خروجی هوش مصنوعی هرگز به عنوان منبع نهایی حقیقت تلقی نمیشود و شواهد در تمام مراحل برای کاربر قابل مشاهده باقی میمانند.
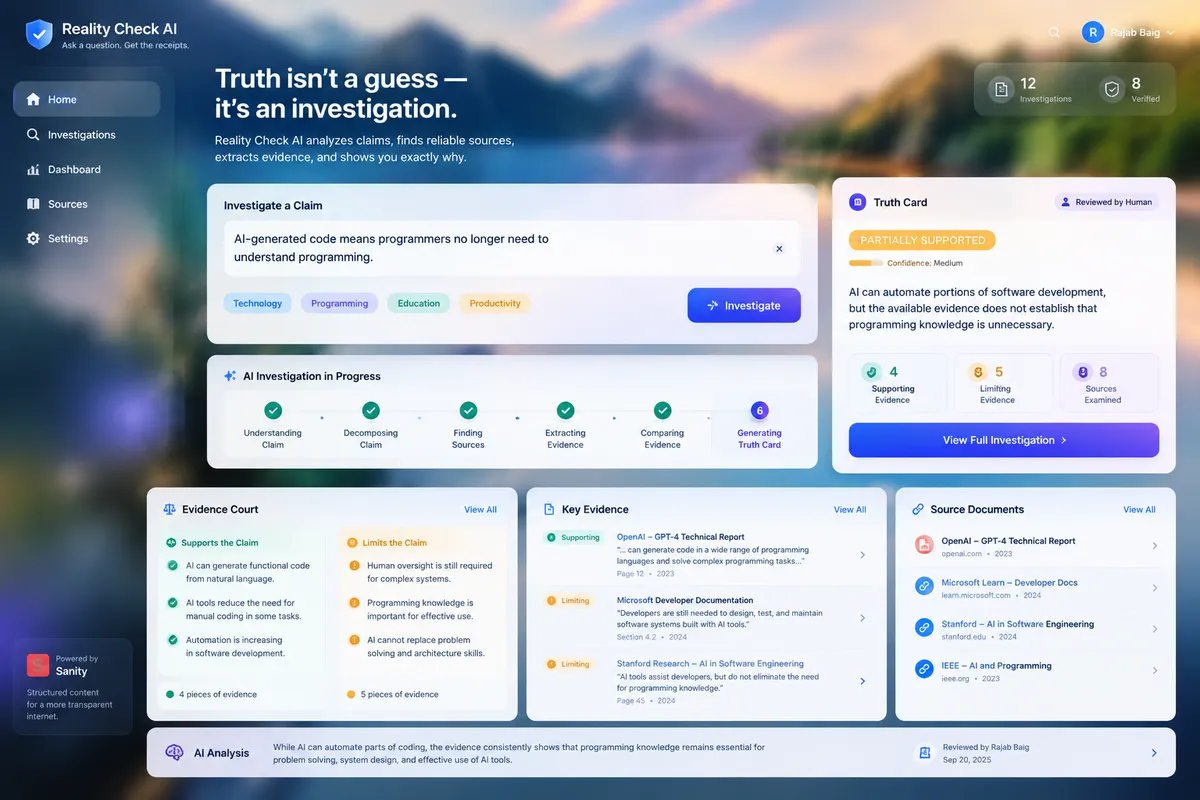
برای رسیدن به این هدف، اپلیکیشن از یک عامل (Agent) هوش مصنوعی تخصصی استفاده میکند که چندین نقش مجزا را ایفا میکند:
- تجزیهکننده ادعا (Claim Parser): تبدیل جملات غیررسمی و محاورهای به دادههای ساختاریافته.
- تجزیهگر ادعا (Claim Decomposer): شکستن ادعاهای پیچیده به گزارههای کوچکتر و قابل آزمایش. برای مثال در مورد «یادگیری برنامهنویسی»، این عامل سه ایده مجزا را شناسایی میکند: ۱. هوش مصنوعی میتواند کد تولید کند، ۲. هوش مصنوعی کدنویسی دستی را کاهش میدهد، و ۳. بنابراین دانش برنامهنویسی غیرضروری است. سپس متوجه میشود که گزاره سوم لزوماً و بهطور خودکار از دو گزاره اول حاصل نمیشود. این رویکرد دقیق به تلفیق تحلیلهای ایستا و مدلهای زبانی شباهت دارد که برای خودکارسازی بازرسیهای حساس در قراردادهای هوشمند به کار گرفته شده است.
- یافتن و استخراج شواهد (Evidence Finder & Extractor): شناسایی منابع مرتبط و بیرون کشیدن بندهای خاص. این عامل رکوردهای شواهد را استخراج کرده و نوع آن (تأییدکننده یا ردکننده)، منبع، متن دقیق بند و مکان آن (بخش، صفحه یا URL) را ثبت میکند.
- شناسایی تناقضات (Contradiction Detector): جستوجوی فعال برای یافتن مدارکی که با ادعا در تضاد هستند؛ مانند مستندات فنی که بر ضرورت تداوم حضور انسان در توسعه نرمافزار تأکید دارند.
- تولید حکم (Verdict Generator): ارائه یک نتیجهگیری نهایی بر اساس وزندهی به شواهد یافت شده.
- عامل ارجاع (Citation Agent): حفظ رابطه سختگیرانه و دقیق بین نتیجه نهایی و شواهد زیربنایی.
لایه محتوای Sanity
این پروژه از Sanity به عنوان دریاچه محتوای ساختاریافته (Structured Content Lake) استفاده میکند. به جای ذخیره سادهی تاریخچه گفتگوها (Conversation Log)، سیستم مستندات دائمی ذخیره میکند. این امر به سامانه اجازه میدهد تحقیقات قبلی را به خاطر بسپارد و از منابع یک تحقیق در ادعاهای دیگر مجدداً استفاده کند. این تلاش برای تبدیل گفتگوهای پراکنده به دادههای قابل حسابرسی، یادآور سرمایهگذاری در QueryStory است که هدفش تبدیل چتهای AI به گزارشهای تجاری مستند است. Sanity به عنوان لایه دائمی شواهد عمل میکند تا تحقیقات حتی پس از پایان گفتگو با AI، قابل بازرسی، جستوجو و استفاده مجدد باشند.
مدل دادهای این سامانه به پنج نوع سند اصلی تقسیم شده است:
- ادعا (Claim): ذخیره متن ادعا، دستهبندی (مانند تکنولوژی، علم، برنامهنویسی، بهرهوری، کسبوکار یا زندگی روزمره)، ادعای نرمالسازی شده، موضوع، وضعیت، حکم، سطح اطمینان، خلاصه و slug. برای مثال، یک رکورد ممکن است وضعیت «بررسی شده» و امتیاز اطمینان ۰.۸۲ داشته باشد.
- منبع (Source): ردیابی ناشر، URL، تاریخ انتشار، حوزه قضایی و یادداشتهای مربوط به اعتبار. منابع میتوانند شامل مستندات دولتی، تحقیقات دانشگاهی، مستندات فنی، مقالات علمی، اسناد شرکتی، سازمانهای استاندارد یا آمارهای رسمی باشند.
- شواهد (Evidence): حلقه حیاتی که یک ادعا را به یک بند خاص از منبع متصل میکند. این بخش شامل عنوان، نوع شواهد، میزان مرتبط بودن، سطح اطمینان، تفسیر و هویت کسی (یا عاملی) است که آن را استخراج کرده است.
- تحقیق (Investigation): سوابق فرآیند استدلال عامل هوش مصنوعی. این سند سؤال، تاریخ شروع و پایان، نسخه عامل، منابع بررسی شده، شواهد یافت شده، خلاصه استدلال و حکم نهایی را ردیابی میکند.
- بازبینی (Review): فضایی اختصاصی برای بازرسان انسانی جهت تأیید یا رد یافتههای AI. در اینجا نام بازبین، تصمیم (تأیید شده، نیاز به بازبینی، رد شده، قدیمی یا مورد مناقشه)، نظرات و شواهد خاص بررسی شده ثبت میشود.
فراتر از حقیقت صفر و یکی
در دنیای واقعی، ادعاها بهندرت فقط «درست» یا «غلط» هستند. به همین دلیل، این سامانه هفت وضعیت تأیید را برای انعکاس این پیچیدگی پیادهسازی کرده است: تأییدشده (Supported)، تا حدی تأییدشده (Partially Supported)، نامشخص (Unclear)، ردشده (Contradicted)، قدیمی (Outdated)، مورد مناقشه (Disputed) و شواهد ناکافی (Insufficient Evidence).
هر تحقیق دارای یک سطح اطمینان (بالا، متوسط یا پایین) است. این امتیاز معیار «حقیقت» نیست، بلکه معیار «قدرت شواهد» است. سیستم بین «اطمینان به شواهد» و «خودِ حقیقت» تمایز قائل میشود. امتیاز اطمینان بر اساس معیارهای زیر محاسبه میشود:
- تعداد منابع مرتبط یافت شده.
- اعتبار و مرجعیت آن منابع.
- میزان توافق بین منابع مختلف.
- میزان جزئیات و دقت شواهد.
- تازگی دادههای منبع.
- میزان ابهام در ادعای اصلی.
- وجود شواهد متناقض.
تأیید انسانی در چرخه (Human-in-the-Loop)
برای جلوگیری از تبدیل شدن هوش مصنوعی به یک مرجع بدون نظارت، فرآیند بازبینی انسانی در پلتفرم ادغام شده است. یک بازبین انسانی میتواند یک ادعا را باز کرده، زنجیره شواهد AI را بررسی کند و یا حکم را تأیید کند و یا درخواست بازبینی مجدد دهد. این رویکرد بر این باور استوار است که حضور انسان در حلقه (Human-in-the-Loop) تنها راهکار قابلاعتماد برای ترمیم و نظارت بر سیستمهای عملیاتی AI است. برای مثال، بازبین ممکن است اشاره کند که اگرچه شواهد بخش اول ادعا را تأیید میکنند، اما نتیجهگیری نهایی بیش از حد قوی است و توسط مدارک پشتیبانی نمیشود.
برای شفافیت بیشتر، رابط کاربری «دادگاه شواهد» (Evidence Court) طراحی شده است. وقتی شواهد متناقض هستند، UI به صورت بصری محیطی شبیه دادگاه را نمایش میدهد که در آن شواهد موافق و مخالف (مثلاً شواهد A در مقابل شواهد B) در مقابل هم قرار میگیرند تا در نهایت یک بررسی جامع توسط AI منجر به تعیین وضعیت نهایی شود. این یک رابط کاربری بهیادماندنی است تا به جای تظاهر به اینکه AI یک قاضی قانونی است، رقابت میان شواهد را نشان دهد.
معماری فنی
این پشته فنی بر پایه Next.js، React، TypeScript و Tailwind CSS بنا شده است. عامل هوش مصنوعی از طریق فراخوانیهای ابزاری ساختاریافته (Structured Tool Calls) و با استفاده از پرسوجوهای GROQ با بکاند Sanity تعامل میکند. این عامل از ابزارهای خاصی مانند createClaim()، searchSources()، createEvidence()، analyzeEvidence()، findContradictions()، updateClaim()، createInvestigation() و requestHumanReview() استفاده میکند.
برای مثال، یک پرسوجوی GROQ میتواند فوراً یک ادعا، حکم آن و تمام شواهد تأییدکننده (شامل URL منبع اصلی و تفسیر AI از آن بند خاص) را استخراج کند. این پرسوجو نوع claim را هدف قرار داده، بر اساس slug فیلتر میکند و سپس تمام اسناد evidence را که به ID آن ادعا ارجاع میدهند، به همراه جزئیات source مرتبط فراخوانی میکند.
این معماری، هوش مصنوعی را از یک چتبات به یک عامل بازرس تبدیل میکند. هدف این است که از جمله «هوش مصنوعی میگوید این درست است» به «هوش مصنوعی میگوید این ادعا بر اساس این چهار سند خاص تأیید میشود» برسیم. تجربه کاربری نیز منعکسکننده این تغییر است: صفحه اصلی دارای یک ورودی ساده برای ادعاهاست و سپس یک ردیاب پیشرفت (Progress Tracker) در لحظه نشان میدهد که AI در حال درک ادعا، شکستن آن به گزارهها، یافتن منابع و در نهایت تولید کارت حقیقت است.
ردپای شواهد و مقیاسپذیری
این تغییر در رویکرد به این معناست که پاسخ AI تنها بخشی از سیستم است. اشیاء دائمی — یعنی ادعاها، منابع و بازبینیها — به داراییهای واقعی پلتفرم تبدیل میشوند. هر ادعا یک URL منحصربهفرد دارد (مثلاً /claims/learning-to-code-ai) که شامل بیانیه اصلی، تفسیر AI، حکم نهایی و یک خط زمانی کامل از شواهد، از لحظه کشف تا تأیید است.
برای کسانی که ابزارهای AI میسازند، این مدل نشان میدهد که محتوای ساختاریافته فراتر از یک CMS ساده است و میتواند به عنوان لایه حافظه دائمی برای استدلالهای عاملمحور (Agentic Reasoning) عمل کند. با مجبور کردن AI به «نشان دادن رسیدها» (Show its receipts)، سیستم یک زنجیره نظارتی قابل حسابرسی برای اطلاعات ایجاد میکند. فلسفه اصلی این است که هر نتیجهگیری باید قابل ردیابی باشد: شواهد ← منبع ← بند دقیق ← تفسیر هوش مصنوعی.
در آینده، این سامانه برای نظارت پیشدستانه (Proactive Monitoring) طراحی شده است. در فازهای بعدی، عامل میتواند بهطور خودکار تشخیص دهد که چه زمانی یک سند منبع اصلی تغییر کرده است. اگر منبعی که در ۱۲ ادعای مختلف استفاده شده بهروزرسانی شود، عامل میتواند بهطور خودکار آن ادعاها را مجدداً بررسی کند، شواهد قبلی را با جدید مقایسه کند، احکام بهروز شده تولید کند و درخواست بازبینی انسانی دهد. این امر اپلیکیشن را از یک پایگاه داده ایستا به یک سیستم تأیید پویا و قدرت گرفته از AI تبدیل میکند.
داشبورد و اکتشاف
اپلیکیشن یک داشبورد جامع برای ردیابی وضعیت تمام تحقیقات ارائه میدهد. این داشبورد شامل آمارهای سطح بالا مانند تعداد کل تحقیقات، تعداد ادعاهای تأیید شده در مقابل رد شده و تعداد مواردی است که در انتظار بازبینی انسانی هستند. کاربران میتوانند این نتایج را بر اساس دستهبندی (مانند علم، برنامهنویسی یا زندگی روزمره) یا بر اساس وضعیت فیلتر کنند.
قابلیت جستوجو به کاربران اجازه میدهد موضوعات خاصی مانند «باتری»، «بهرهوری» یا «خواب» را جستوجو کنند. نتایج جستوجو شامل ادعا، حکم فعلی، سطح اطمینان، تعداد رکوردهای شواهد متصل و تاریخ آخرین تأیید است. این ساختار تضمین میکند که پایگاه دانش به جای مجموعهای از جلسات چت ایزوله، به عنوان یک دفتر کل قابل جستوجو از حقایق تأیید شده رشد کند.
گام بعدی شما
- اگر ابزارهای AI میسازید، به جای ذخیره تاریخچه چت، از مدلهای دادهای ساختاریافته برای ثبت استدلالها استفاده کنید.
- در مواجهه با ادعاهای AI، همیشه درخواست «بند دقیق منبع» (Exact Excerpt) را بکنید تا توهم مدل را شناس کنید.
- معماری Sanity و GROQ را برای ایجاد حافظه دائمی در عاملهای هوش مصنوعی بررسی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو