یک فایل Deployment در کوبرنتیز و یک درخواست curl، تنها فاصلهٔ میان سیلیکون خام GPU و یک رابط هوش مصنوعی فعال است. این واقعیت در ۲۵ ژوئن ۲۰۲۶ با ارائه یک چارچوب کاربردی تثبیت شد که ثابت میکند سرویسدهی به یک API محلی دیگر نیازمند تیمهای عظیم مهندسی نیست.
سرویسدهی به مدلها در یک خوشه (Cluster) بهطور سنتی بسیار شکننده است؛ زیرا منطق مقیاسپذیری وبهای معمولی در مواجهه با وزنهای عظیم مدل و محدودیتهای حافظه GPU شکست میخورد. این مقاله، تکملهای بر مجموعه مطالعات ماست که پیشتر مفاهیمی چون توکنها، اندازه مدل و درسهای مقیاسدهی OpenAI در کوبرنتیز را بررسی کردیم. همانطور که در تحلیل قبلی ما دربارهی لایههای قابلیت اطمینان و LiteLLM اشاره کردیم، تمرکز این مرحله بر زیرساخت هسته است: یعنی رساندن مدل به نقطهای که واقعاً پاسخ دهد. برای درک بهتر، کوبرنتیز را مانند صاحبخانهای تصور کنید که اتاق (Pod) و برق (GPU) را فراهم میکند، در حالی که موتور سرویسدهنده، مستأجری است که کار واقعی را انجام میدهد.
موتور زیرساختی
کوبرنتیز بهطور پیشفرض نمیداند چگونه یک مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — را سرویس دهد. کوبرنتیز مدیریت زمانبندی، شبکه و تخصیص GPU را بر عهده دارد، اما کارهای سنگین بر دوش vLLM میافتد. کوبرنتیز پاد را زمانبندی میکند، شبکه را متصل میکند، Secret را نصب میکند و از پلاگین دستگاه NVIDIA درخواست یک GPU میکند. پس از آن، سرور مدل در داخل کانتینر باید عملیات تخصصی LLM را اجرا کند.
vLLM بهعنوان سرور مدل عمل میکند که وزنها را از Hugging Face دانلود کرده، حافظه GPU را مدیریت میکند و یک سرور HTTP سازگار با OpenAI ارائه میدهد. طبق مستندات این ابزار، vLLM انتخابی ایدهآل است زیرا جزئیات دشواری مانند حلقههای دستهبندی (Batching) و مسیرهای توکنساز (Tokenizer) را پنهان میکند، بدون اینکه ساختار کلی استقرار را از اپراتور بگیرد. شما همچنان نام مدل، درخواست GPU، پورت، Secret توکن و لاگها را میبینید، اما مجبور نیستید برای اثبات کارکرد سیستم، یک Wrapper برای API بنویسید. این رویکرد در واقع بخشی از تلاش گستردهتر برای کاهش پیچیدگیهای عملیاتی است، مشابه آنچه در رویکرد سادهسازی ارکستراسیون پروژه OpenFugu برای توسعهدهندگان مشاهده میکنیم.
سازوکارهای vLLM
در این پیکربندی خاص، vLLM هنگام استارتآپ پنج وظیفه حیاتی را انجام میدهد:
- خواندن نام مدل از خط فرمان
- استفاده از توکن Hugging Face برای احراز هویت و دسترسی به مخزن مدل
- دانلود فایلهای مدل یا بازاستفاده از وزنهای کششده
- مقداردهی اولیه به توکنساز و زمان اجرای مدل
- راهاندازی یک سرور HTTP روی پورت ۸۰۰۰ برای دریافت درخواستها
بدون موتوری مثل vLLM، توسعهدهندگان باید بهصورت دستی حلقههای دستهبندی را بنویسند و مسیرهای توکنساز را مدیریت کنند تا فقط بفهمند استقرار مدل درست کار میکند یا خیر. در اینجا vLLM موتور است و API مدل، هدف نهایی.
گام اول: اعتبارسنجی رویت GPU
قبل از استقرار، باید تأیید کنید که خوشه سختافزار را میبیند. بر اساس پیشفرضهای بخش چهارم، درایورهای NVIDIA، runtime کانتینر و GPU Operator فعال هستند. برای بررسی ظرفیت، دستور زیر را اجرا کنید:kubectl get nodes -o=custom-columns=NAME:.metadata.name,GPU:.status.allocatable.nvidia\.com/gpu
خروجی سالم باید به این شکل باشد: NAME GPU gpu-worker-01 1.
اگر این ستون خالی یا <none> بود، بلافاصله متوقف شوید. در این حالت ورکلود در وضعیت Pending میماند زیرا کوبرنتیز نمیتواند ورکلود را زمانبندی کند تا زمانی که گره ظرفیت nvidia.com/gpu را اعلام کند.
گام دوم: ایمنسازی دسترسی به مدل
حتی برای مدلهای عمومی مثل Qwen/Qwen2.5-1.5B-Instruct، استفاده از توکن Hugging Face هدفمند است. تیمهای عملیاتی معمولاً با مدلهای عمومی شروع کرده و بعداً به مدلهای خصوصی یا لایسنسدار کوچ میکنند؛ اگر مسیر توکن از ابتدا در Deployment باشد، این جابهجایی بسیار سادهتر است.
گردشکار پیادهسازی توکن:
- ایجاد توکن: از بخش توکنهای Hugging Face یک توکن با دسترسی Read ایجاد کنید.
- جداسازی ورکلود: یک فضای نام اختصاصی بسازید:
kubectl create namespace llm-demo. - تنظیم متغیر شل: دستور
export HF_TOKEN="hf_your_token_here"را اجرا کنید. - ایجاد Secret: با دستور
kubectl create secret generic hf-token -n llm-demo --from-literal=HF_TOKEN="${HF_TOKEN}"توکن را ذخیره کنید.
برای جلوگیری از نشت امنیتی در Git، هرگز توکنها را مستقیماً در مانیفستها ننویسید.
گام سوم: مانیفست استقرار
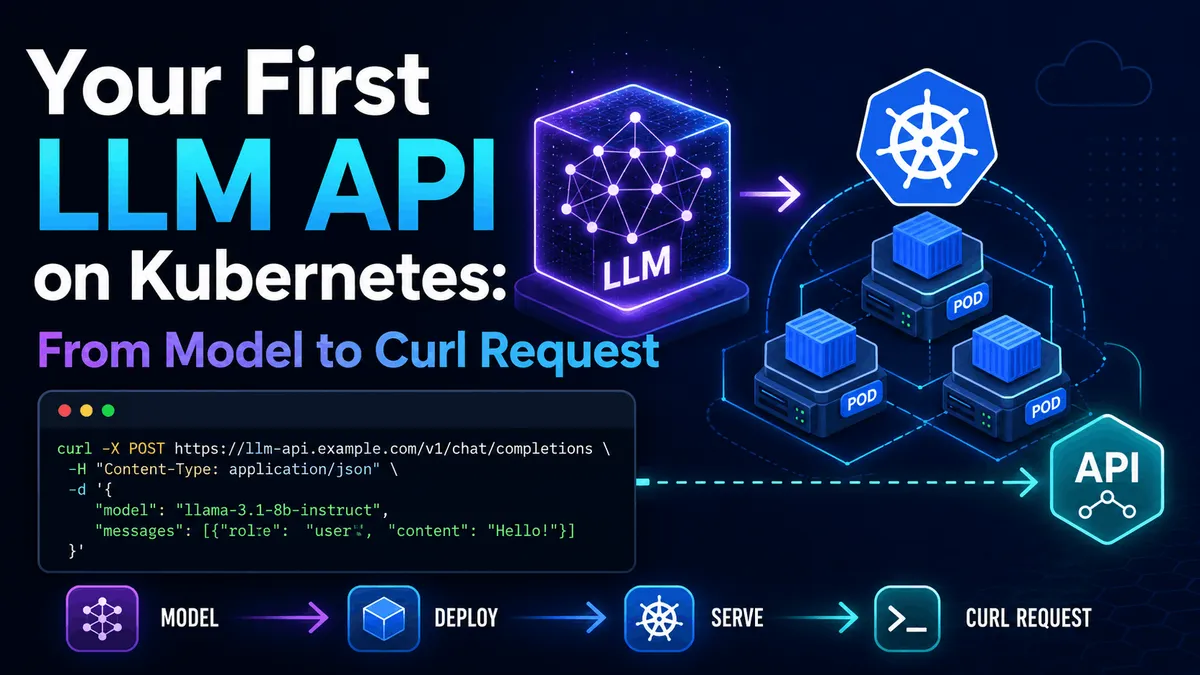
هسته عملیات، یک مانیفست YAML است که یک Deployment و یک Service را تعریف میکند. این استقرار از تصویر vllm/vllm-openai:latest استفاده کرده و دستور vllm serve Qwen/Qwen2.5-1.5B-Instruct را روی پورت ۸۰۰۰ اجرا میکند.
جزئیات فنی:
- درخواست منابع GPU: مقدار
nvidia.com/gpu: 1به زمانبند میگوید کدام گره میتواند پاد را میزبانی کند. - نگاشت دوگانه توکن: توکن به هر دو متغیر
HF_TOKENوHUGGING_FACE_HUB_TOKENمتصل شده چون کتابخانههای مختلف نامهای متفاوتی میخواهند. - مدیریت حافظه مشترک: یک
emptyDirبا محدودیت ۲ گیگابایت به مسیر/dev/shmمتصل شده است. سرورهای مدل بهشدت از حافظه مشترک استفاده میکنند و بدون این تنظیم، خطاهای عجیبی رخ میدهد. - شبکه: یک سرویس ClusterIP به نام
qwen-vllmپورت ۸۰۰۰ را هدف قرار میدهد تا یک نقطه دسترسی پایدار در خوشه ایجاد شود. - منطق انتخاب مدل: برای اولین تجربه از
Qwen/Qwen2.5-1.5B-Instructاستفاده کنید. اگر GPU شما بسیار کوچک است، مدل ۰.۵ میلیاردی و اگر حافظه بیشتری دارید، مدل ۷ میلیاردی را امتحان کنید.
گام چهارم: تلهٔ «در حال اجرا» در برابر «آماده»
یکی از رایجترین اشتباهات این است که تصور کنیم وضعیت Running در پاد به معنای فعال بودن API است. در سرویسدهی مدل، وضعیت «آماده بودن» (Readiness) به دانلود وزنها، مقداردهی GPU و استارت سرور گره خورده است. پاد تنها زمانی آماده است که سرور روی پورت ۸۰۰۰ گوش دهد.
مراحل تأیید:
با دستور kubectl get pods -n llm-demo -w وضعیت را دنبال کنید. سپس با دستور زیر لاگها را بررسی کنید تا لحظه فعال شدن سرور را ببینید:kubectl logs -n llm-demo -f deployment/qwen-vllm
اگر پاد با خطای OOM (کمبود حافظه) کرش کرد، اندازه مدل را متناسب با ظرفیت GPU کاهش دهید.
گام پنجم: اجرا و تأیید نهایی
برای عبور از پیچیدگیهای Ingress و DNS، از kubectl port-forward استفاده کنید تا یک تونل محلی ایجاد شود:kubectl port-forward -n llm-demo svc/qwen-vllm 8000:8000
حالا با یک درخواست curl به نقطه دسترسی /v1/chat/completions صحت عملکرد را بررسی کنید:
curl http://127.0.0.1:8000/v1/chat/completions \ -H "Content-Type: application/json" \ -d '{ "model": "Qwen/Qwen2.5-1.5B-Instruct", "messages": [ { "role": "system", "content": "You are a concise Kubernetes assistant." }, { "role": "user", "content": "Explain what a Kubernetes Service does in two sentences." } ], "max_tokens": 120, "temperature": 0.2 }'
پارادوکس نام مدل
درخواست باید نام مدل را در بدنه JSON داشته باشد، حتی اگر سرور فقط یک مدل میزبانی کند. این کار برای رعایت قرارداد API شرکت OpenAI است تا در سیستمهای پیچیده، Gateway بداند درخواست را به کدام مدل هدایت کند. برای شروع، مقدار را دقیقاً مشابه نامی قرار دهید که در دستور vllm serve استفاده کردید.
عیبیابی چرخه حیات
وقتی سیستم مختل میشود، علائم معمولاً به لایههای خاصی اشاره دارند:
- پاد در وضعیت Pending: کوبرنتیز گره مناسب نمییابد. دستور
describe podرا اجرا کنید تا رویدادهای زمانبند را ببینید. - فقدان nvidia.com/gpu: مسیر پلاگین دستگاه خراب است. دوباره وضعیت رویت GPU را بررسی کنید.
- خطای دانلود Hugging Face: توکن گم شده یا منقضی شده است. Secret را بهروز کرده و Deployment را ریاستارت کنید.
- خطای مقداردهی CUDA: عدم تطابق درایور یا تصویر کانتینر با سختافزار گره.
- کرش با خطای OOM: مدل برای اجرا به حافظه بیشتری نیاز دارد. از مدلهای کوچکتر استفاده کنید.
- خطای Connection Refused: سرور هنوز در حال بارگذاری وزنهاست یا دستور port-forward متوقف شده است.
تحلیل: چرخش در زیرساخت
این انتقال از «مدل بهعنوان یک فایل» به «مدل بهعنوان یک سرویس کوبرنتیزی»، خط پایه مهندسی هوش مصنوعی را تغییر میدهد. با تبدیل LLM به یک ورکلود استاندارد و تحت نظارت، تیمها میتوانند از سرورهای GPU دستی و تکگیره به سمت زیرساختهای بازتولیدپذیر حرکت کنند. این استقلال از APIهای تجاری نه تنها کنترل بیشتری روی دادهها میدهد، بلکه در راستای بهینهسازی هزینههای جاری API مدلهای زبانی است که در تحلیلهای پیشین بررسی کردیم.
تأیید حلقه پایه
هر پلتفرم LLM باید قبل از افزودن پیچیدگی، این ۶ سؤال را پاسخ دهد:
۱. آیا کوبرنتیز میتواند ورکلود را روی GPU زمانبندی کند؟
۲. آیا کانتینر GPU را میبیند؟
۳. آیا سرور مدل میتواند مدل را دانلود و بارگذاری کند؟
۴. آیا API درخواستها را میپذیرد؟
۵. آیا مدل پاسخ تولید میکند؟
۶. آیا هنگام شکست هر یک از این مراحل، خطاها قابل مشاهده هستند؟
اگر این حلقه ناپایدار باشد، مقیاسدهی خودکار (Autoscaling) و Gatewayها شما را نجات نمیدهند؛ آنها فقط مشکل را موقتاً پنهان میکنند.
گام بعدی شما
- پیادهسازی کوانتایزیشن (Quantization) برای بهینهسازی مصرف حافظه و افزایش سرعت استنتاج.
- جایگزینی
port-forwardبا یک Ingress Controller رسمی برای دسترسی عمومی و مدیریت TLS. - تعریف استراتژیهای Health Check پیشرفته برای تشخیص توقف مدل در لایههای CUDA.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو