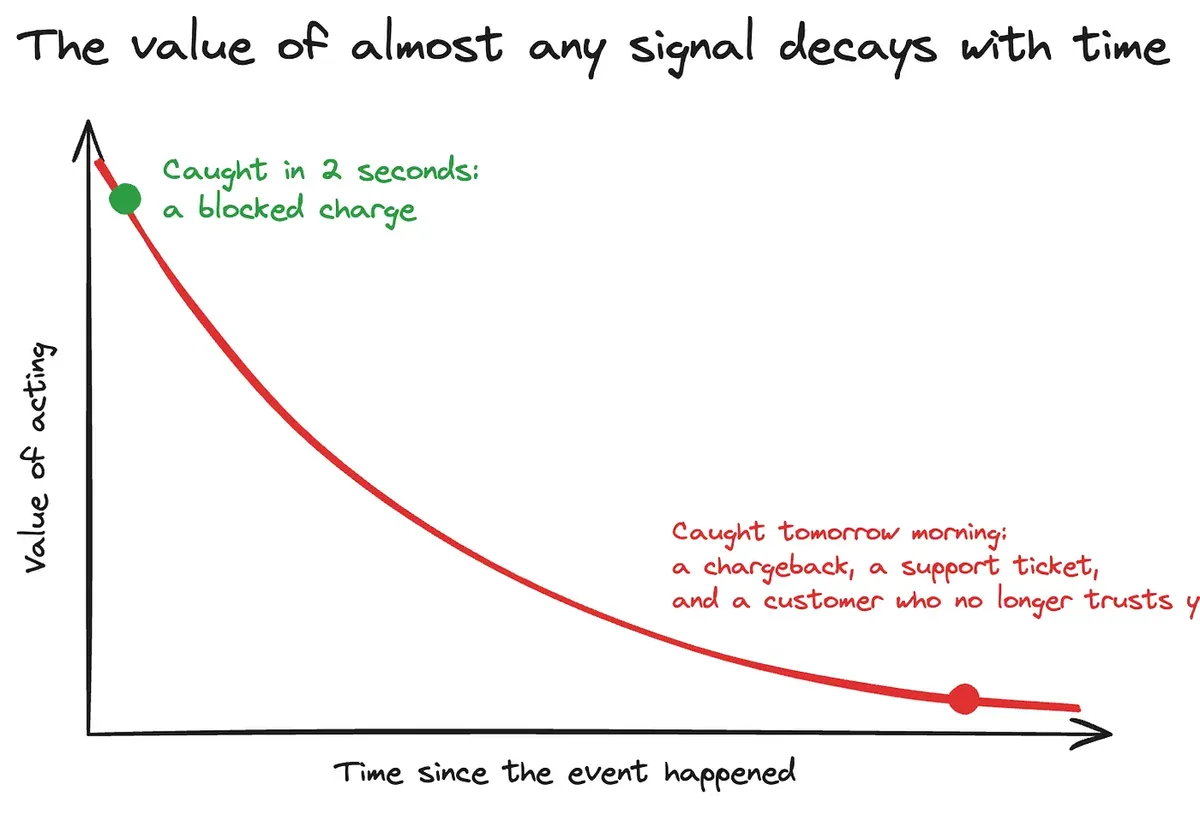
تصور کنید تفاوت بین شناسایی لرزش یک پمپ صنعتی در همین لحظه — که تنها یک دستور تعمیر ساده است — و خرابی کامل همان پمپ در هفته آینده که منجر به توقف کل تولید میشود، چقدر است؟ برای بستن این پنجرهی تخریب، IBM و Confluent مدلهای بنیادی سری زمانی (TSFM) را مستقیماً به جریان دادهها آوردند؛ قابلیتی که در حال حاضر در دسترسی زودهنگام (Early Access) روی Confluent Cloud در بستر AWS فعال شده است.
برای دههها، هوش صنعتی با یک موازنه هزینهبر روبرو بود. شرکتها یا مدلهای اختصاصی برای تعداد کمی از داراییهای بسیار گرانقیمت میساختند — فرآیندی که ماهها زمان متخصصان را میگرفت — یا به حاشیه ایمنی بالا و موجودی اضافی تکیه میکردند تا خلأها را بپوشانند. این «هزینه حاشیه» در واقع مالیاتی بود که بابت ناتوانی در پیشبینی اکثر سیگنالهای کسبوکار پرداخت میشد. تیمها تنها چند صد سری داده را که بیشترین سودآوری را داشتند مدلسازی میکردند و بقیه را با تحمل خطا و تلورانس اضافی رها میکردند؛ یعنی اغلب زمانی اقدام میکردند که پنجره فرصت برای مداخله بسته شده بود.
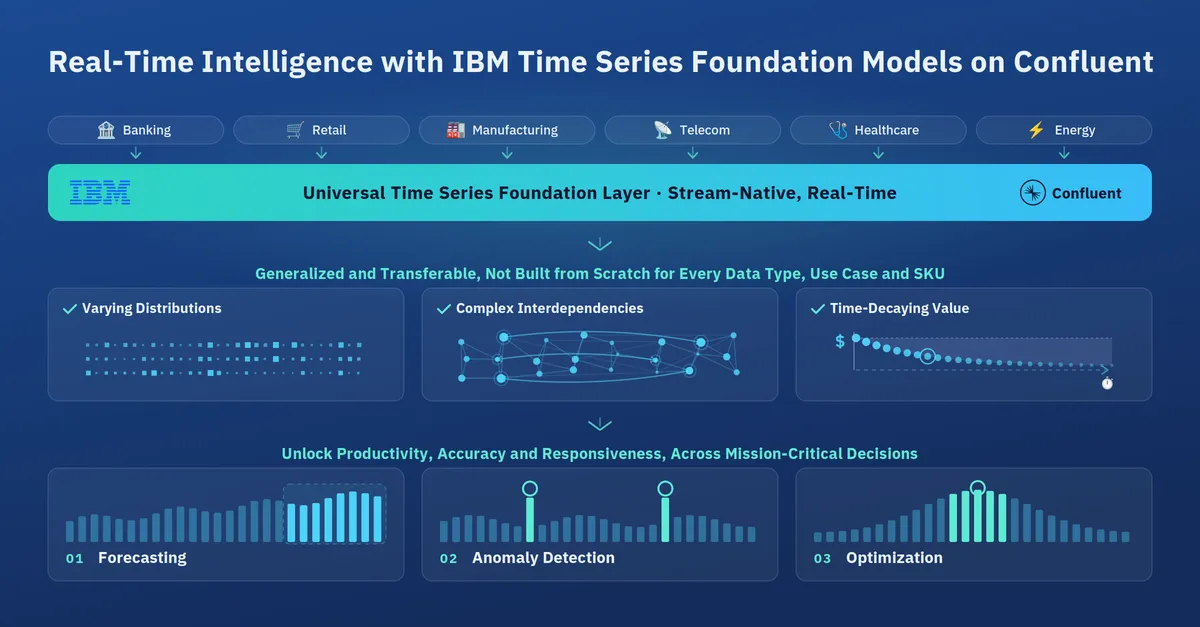
مدلهای بنیادی (Foundation Model) — شبیه به یک متخصص همهفنحریف که اصول کلی یک حرفه را میداند و میتواند سریعاً با هر پروژه جدید سازگار شود — اقتصاد این بازی را تغییر میدهند. این مدلها با تعمیم دادن الگوها در میان سیگنالهای وسیع و متنوع، هزینهها را کاهش میدهند. یک TSFM که یک بار روی دادههای متنوع آموزش دیده است، میتواند روی سری دادهای که هرگز ندیده است تعمیم یابد. بهجای آموزش یک مدل برای هر سنسور، یک مدل واحد میتواند پنجرهای از اندازهگیریها را بررسی کند و پیشبینی کند چه اتفاقی میافتد، یا تشخیص دهد رفتار فعلی چقدر با حالت نرمال فاصله دارد، یا پیدا کند که کدام تاریخچه بیشترین شباهت را به وضعیت فعلی دارد. این تغییر، قدرت را از تیمهای متمرکز علوم داده به متخصصان عملیاتی — مثل برنامهریزان تقاضا، تحلیلگران تقلب و مهندسان فرآیند — که در واقع مالک تصمیمات هستند، منتقل میکند.
همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی زیرساختهای داده اشاره کردیم، حذف لایههای واسط بین داده و مدل، کلید افزایش سرعت واکنش در سیستمهای صنعتی است. در واقع، بسیاری از معماریهای سنتی داده امروز عامل اصلی پیشبینیهای نادرست هوش مصنوعی هستند و نیاز به رویکردهایی مانند ادغام بومی دارند.
مکانیزم ادغام
به نقل از مستندات رسمی، این ادغام بهصورت «بومیِ جریان» (stream-native) اجرا میشود. این یعنی مدلها درست در جایی که دادهها حرکت میکنند مستقر شدهاند، در Confluent Cloud میزبانی میشوند و مستقیماً از طریق Apache Flink و با استفاده از SQL فراخوانی میشوند. این رویکرد، پیشبینی، تشخیص ناهنجاری و بهینهسازی را از یک «پروژه ساختاری» که باید ساخته شود، به یک «قابلیت فراخوانی» تبدیل میکند که میتوانید از آن استفاده کنید.
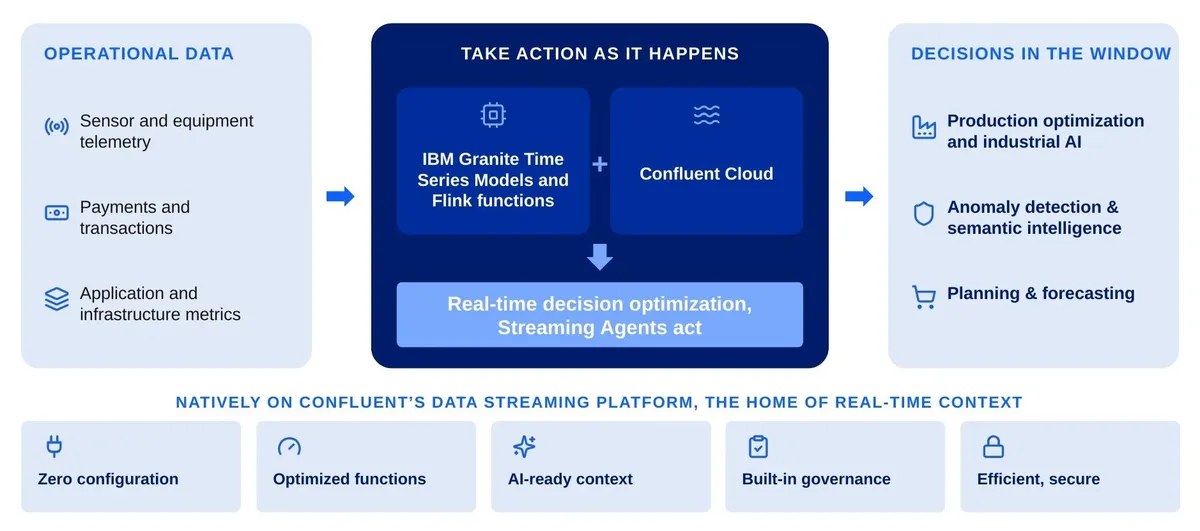
این معماری مشکل «وضعیت» (state) را حل میکند. پیشبینی و تشخیص ناهنجاری فرآیندهایی وضعیتمند هستند؛ یعنی مقدار بعدی تنها در مقایسه با تاریخچه اخیر معنا دارد و یک ناهنجاری تنها در مقابل درک جاری از حالت نرمال وجود دارد. Flink این وضعیت را بهصورت کلیدگذاریشده برای هر سری داده مدیریت میکند و به دلیل تحمل خطا (fault-tolerant)، نیاز به یک پایگاهداده مجزا یا ارسال درخواست به دیتابیس برای هر فراخوانی مدل را از بین میبرد.
سبد مدلهای ارائه شده
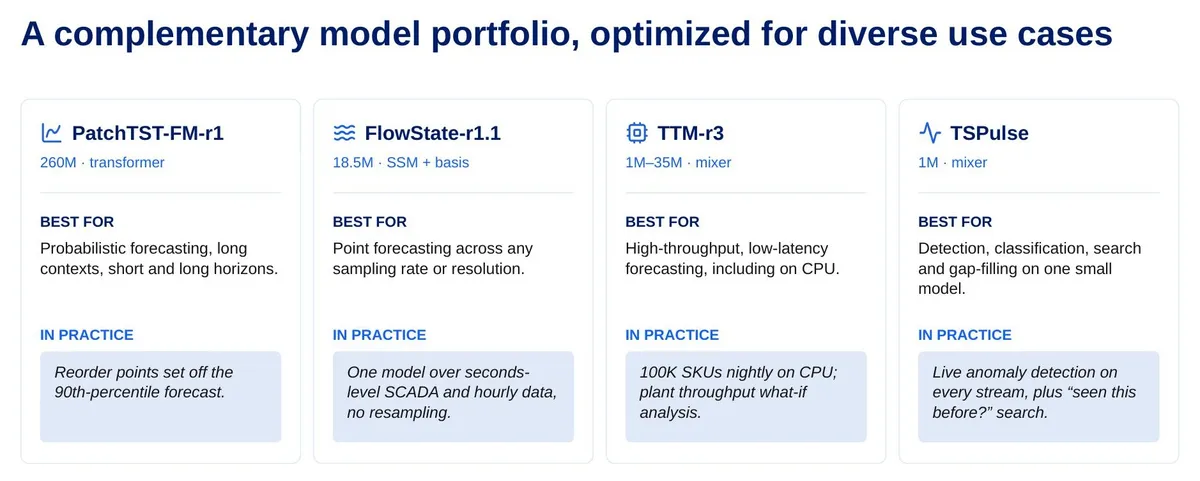
بهجای یک مدل واحد «بهترین»، IBM چهار مدل مکمل را برای پاسخ به پرسشهای مختلف تجاری ارائه داده است. هر تصمیم، پرسش متفاوتی از آینده میپرسد: یک چرخه برنامهریزی به طیفی از نتایج نیاز دارد، یک میز معاملات به دقیقترین عدد در هر نرخ نیاز دارد و یک تیم امنیتی باید لحظهای را بداند که یک جریان دیگر مانند خودش رفتار نمیکند.
کاربران میتوانند تنها با تغییر یک پارامتر SQL، مدل را عوض کنند بدون اینکه نیاز باشد کل خط لوله (pipeline) را بازطراحی کنند. برای مثال، یک فراخوانی ساده با دستور SELECT AI_FORECAST میتواند هر یک از چهار مدل را با تغییر مقدار مدل در JSON_OBJECT اجرا کند.
یک پیادهسازی خاص به این شکل است:SELECT AI_FORECAST( load_kw, event_time, JSON_OBJECT('model' VALUE 'ttm', 'horizon' VALUE 12) ) OVER ( ORDER BY event_time RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW ) AS forecast FROM meter_readings;
- PatchTST-FM: دادهها را تکه به تکه (patch by patch) میخواند، شبیه به روشی که یک مدل زبانی (LLM) متن را پردازش میکند. در این مدل، هر متغیر در کانال خود نگه داشته میشود تا یک سیگنال نویزی نتواند بقیه را پایین بکشد. این مدل یک توزیع کامل را برمیگرداند و به برنامهریزان اجازه میدهد نقاط سفارش مجدد را بر اساس صدک ۹۰ام تعیین کنند، نه فقط یک میانگین ساده.
- FlowState: یک خلاصه جاری را با هر نقطه داده بهروز میکند. به دلیل اینکه دینامیکهای آن در زمان پیوسته است، میتواند دادههای SCADA در سطح ثانیه و دادههای بازار در سطح ساعت را با کارایی یکسان بخواند.
- TTM: مکانیزمهای سنگین توجه (attention) را حذف کرده و از شبکههای ترکیب (mixing networks) بسیار کوچک در طول زمان و در میان متغیرها استفاده میکند. این امر اجازه میدهد یک مدل با یک میلیون پارامتر، شبانه ۱۰۰ هزار سری داده را در حالی که روی CPUهای استاندارد اجرا میشود، پوشش دهد.
- TSPulse: دیدگاههای زمانی و فرکانسی را در یک مدل کوچک چند-وظیفهای ترکیب میکند. این مدل در تشخیص ناهنجاری، طبقهبندی، پر کردن شکافهای دادهای و پاسخ به این پرسش حیاتی اپراتور تخصص دارد که: «آیا قبلاً چنین چیزی دیدهایم؟»
کاربردهای دنیای واقعی
IBM و Confluent این مدلها را با شرکای طراحی در صنایع فولاد، سیمان، خمیر و کاغذ، غذا و مخابرات آزمایش کردهاند. نتایج نشاندهنده افزایش بهرهوری ۵ تا ۱۰ برابری است و هر نقطه افزایش دقت میتواند میلیونها دلار ارزش داشته باشد. IBM پیش از عرضه عمومی، این مدلها را در محصولات و عملیات داخلی خود اجرا کرد. این مدلها توسط بیش از ۴۴ میلیون دانلود پشتیبانی میشوند.
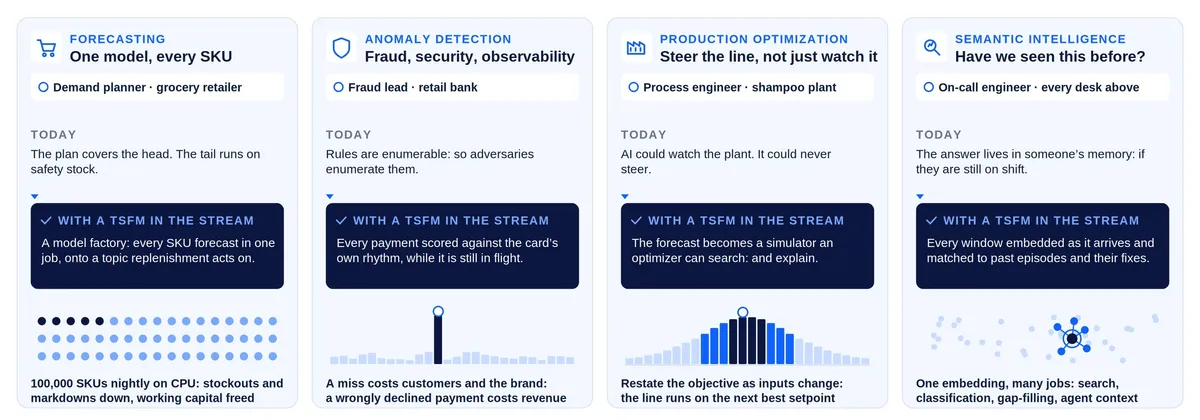
پیشبینی و برنامهریزی: در خردهفروشی، یک برنامهریزان تقاضا میتواند یک مدل مشترک را روی کل کاتالوگ محصولات اعمال کند. مدل برای کالاهای جدید (SKU) که تاریخچهای ندارند، با یافتن محصولات مشابه عمل میکند و از اتمام موجودی جلوگیری کرده و سرمایه در گردش را آزاد میکند. این مدل میتواند یک کالای دو ساله و یک کالای سه ماهه را در یک عملیات پردازش کند و شبانه ۱۰۰ هزار SKU را روی CPU مدیریت نماید. چون هر پیشبینی روی یک Topic در کافکا قرار میگیرد، تبدیل به ماشهای برای تامین مجدد، تخصیص و قیمتگذاری میشود و اجازه میدهد تخفیفها پیش از قدیمی شدن موجودی اعمال شوند. نتیجه، حفظ درآمد در قفسه و آزاد شدن سرمایه در گردش است که اغلب بزرگترین ردیف در توجیه اقتصادی کسبوکار است.
تشخیص ناهنجاری: در خدمات مالی، تابع AI_DETECT_ANOMALIES میتواند پرداختها را در حین انتقال امتیازدهی کند. با حفظ درک از حالت «نرمال» برای هر کارت، میتواند یک تراکنش متقلبانه را شناسایی کند — مثلاً کارتی که دو سال در سه کد پستی خرید خواربار میکرده و ناگهان ساعت ۳ صبح یک کیف پول در خارج از کشور را شارژ میکند — پیش از آنکه پول جابجا شود. چون مدل روی جریان دادههای خود بانک شخصیسازی شده است، میتوان آن را با تایید موارد جدید بازتنظیم کرد تا با الگوهای در حال تکامل مهاجمان همگام شود. این موضوع در حالی که تجارت به سمت «عاملمحور» (agentic) میرود و عاملها پرداختها را با سرعت ماشین انجام میدهند، حیاتی است. هر امتیازدهی، حرکت بعدی را فعال میکند: مسدود کردن پرداخت، ارجاع به تحلیلگر به همراه نزدیکترین موارد مشابه گذشته، یا سپردن آن به یک عامل هوشمند. در این مسیر، همگرایی مدلها در عاملهای هوش مصنوعی میتواند چالشهای جدیدی در زمینه اعتماد ایجاد کند که باید در طراحی سیستمهای مالی لحاظ شود.
بهینهسازی تولید: در تولیدات صنعتی، مثلاً یک کارخانه شامپو، مهندس فرآیند میتواند از مدل بهعنوان شبیهساز استفاده کند. با مشروط کردن پیشبینی به تنظیمات قابل کنترل (مانند دما، سرعت همزن و نرخ دوزینگ)، سیستم میتواند به دنبال بهینهترین نقطه برای حداکثر تولید یا حداقل مصرف انرژی بگردد. این امر به کارخانه اجازه میدهد در لحظه و زمانی که تامینکننده سورفاکتانت تغییر میکند یا یک بچ عطر رفتار متفاوتی دارد، دوباره بهینهسازی شود. یک تولیدکننده مواد غذایی در حال حاضر با یک فرآیند شروع کرده و ۴۰۰ کارخانه در پشت آن قرار دارد. دستاوردها قابل توجه است: یک نقطه بهبود در عملیاتی که صدها میلیون دلار گردش مالی دارد، یک ردیف هفترقمی در سود است.
هوش معنایی: با استفاده از بردار معنایی (Embedding)، سیستم پنجرههای زمانی را به بردارهای فشردهای تبدیل میکند که شکل پنجره را در زمان و فرکانس ثبت میکند. این به پلتفرم اجازه میدهد یک «سابقه» پیدا کند — یعنی انحراف فعلی در رفتار یک ماشین را با یک اتفاق تاریخی و راهکار خاصی که دفعه پیش جواب داده بود، تطبیق دهد. این Embeddingها همچنین باعث پیشبرد طبقهبندی، پر کردن شکافها و بازیابی زمینهای توسط عاملهای AI میشوند. این امر مدل را از یک کتابدارِ گذشته به یک بهینهسازِ تصمیماتی تبدیل میکند که هنوز در جریان هستند.
مزایای عملیاتی و حاکمیت
این همکاری با حذف نیاز به یک پشته (stack) مجزای یادگیری ماشین، هزینههای ورود/خروج داده در ابر (ingress/egress fees) و نیاز به تامین GPUهای اختصاصی برای استنتاج (Inference) را از بین میبرد. کل خط لوله — از سیگنال تا پیشبینی — از طریق نحو آشنای SQL مدیریت میشود.
- پیکربندی صفر: Confluent مدیریت سرویسدهی مدل، مقیاسدهی و عملیات زمان اجرا را بر عهده دارد و نیاز به مدیریت اعتبارنامههای تامینکننده یا ایجاد پل بین خط لولههای داده و مدل را حذف میکند. کاربران مدلهای IBM Granite Time Series را مستقیماً از Flink SQL فراخوانی میکنند.
- زمینه بهروز: مدلها روی تلهمتری زنده سنسورها، فعالیتهای پرداخت و متریکهای اپلیکیشن عمل میکنند، نه دادههای قدیمی دستهای (batch). نتایج در Topicهای کافکا نوشته شده و به سیستمهای هشدار، داشبوردها، Lakehouseها و عاملهای AI ارسال میشوند.
- حاکمیت داخلی: خط لولههای استنتاج از همان طرحها (schemas)، تبار (lineage) و کنترلهای دسترسی پیروی میکنند که در بقیه پلتفرم وجود دارد. Topicهای کافکا برای حسابرسی، عیبیابی و اجرای مجدد استنتاج روی دادههای تاریخی، بادوام و قابل بازپخش (replayable) باقی میمانند. برای سازمانهایی که به دنبال استانداردهای سختگیرانهتر هستند، استفاده از چارچوبهایی مانند R.A.H.S.I برای مدیریت ریسک دادهها میتواند مکمل این حاکمیت داخلی باشد.
- امنیت ارتقایافته: دادهها برای استنتاج در همان محیط Confluent Cloud میمانند و در سراسر پلتفرم از سیاستهای RBAC و حریم خصوصی پیروی میکنند.
- زمان سریعتر برای رسیدن به ارزش: تیمها میتوانند در عرض چند دقیقه و با استفاده از SQL، از دادههای جریانی به یک خط لوله پیشبینی و تشخیص ناهنجاری فعال برسند، بهجای اینکه یک پشته ML مجزا یا خط لولههای داده نقطه-به-نقطه بسازند.
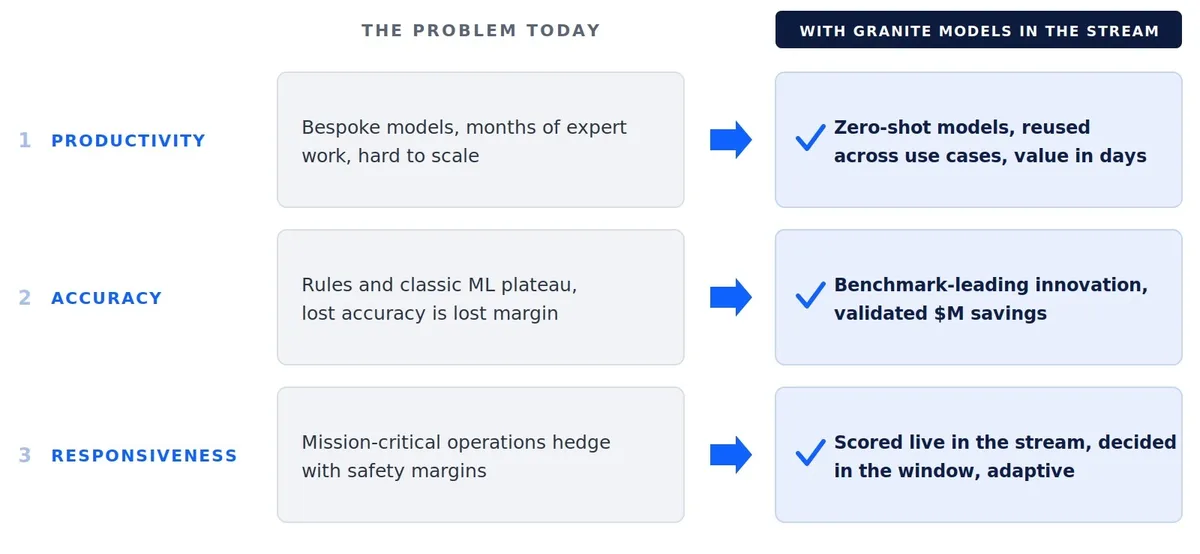
این رویکرد شکاف بین دادههای عملیاتی (چه اتفاقی میافتد) و هوش تحلیلی (معنای آن چیست) را پر میکند. چون نتایج دوباره در Topicهای کافکا نوشته میشوند، میتوانند بلافاصله عاملهای AI پاییندستی یا سیستمهای هشدار را برای بررسی و اولویتبندی رویدادها فعال کنند. IBM Granite همچنین یک چارچوب حاکمیت AI سازمانی را با شفافیت در منشأ مدل و مجوزها به همراه میآورد.
این تغییر نشان میدهد که آینده AI سازمانی تنها درباره LLMهای بزرگتر نیست، بلکه درباره جاسازی مدلهای بنیادی تخصصی با پارامترهای کوچک مستقیماً در لولهکشیهای کسبوکار است. وقتی مدل بهجای یک پروژه، تبدیل به یک فراخوانی تابع شود، سد ورود برای بهینهسازی در لحظه از بین میرود.
کاربران در حال حاضر میتوانند در برنامه Early Access ثبتنام کنند تا این مدلها را روی جریانهای داده خود در Confluent Cloud اعمال کنند، که در این دوره هیچ هزینهای ندارد. انتظار میرود پس از آن، این قابلیتها به Confluent Platform در محیطهای On-premises منتقل شود و همان تواناییها را به محیطهای هیبریدی بیاورد. این حلقه بازخورد هدف اصلی است: آنچه کاربران روی جریانهای خود مییابند، به مدلها میآموزد که در آینده به چه چیزی تبدیل شوند.
گام بعدی شما
- اگر از Confluent Cloud استفاده میکنید، برای برنامه Early Access ثبتنام کنید تا مدلهای Granite را روی جریانهای داده خود تست کنید.
- بررسی کنید کدام متغیرهای عملیاتی شما (مانند دما یا نرخ تراکنش) دارای الگوهای تکرارشونده هستند تا از مدل TTM برای پیشبینی آنها استفاده کنید.
- ساختار SQL خود را برای پذیرش توابع
AI_FORECASTوAI_DETECT_ANOMALIESآماده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است؛ برای درک اینکه چگونه مدلهای کوچک روی CPU جایگزین GPUهای گرانقیمت میشوند، به تحلیل ما دربارهی کوانتایزیشن مراجعه کنید.



گفتگو