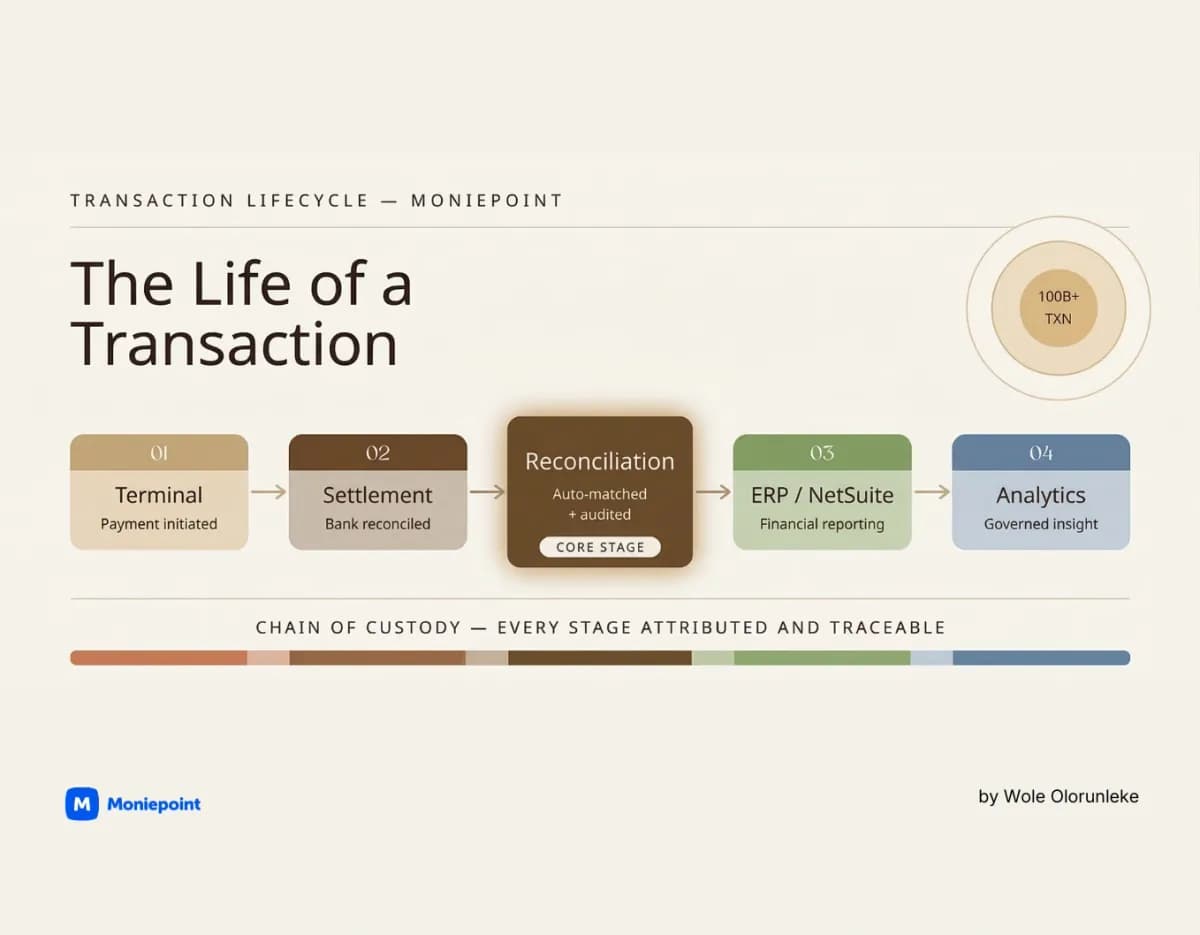
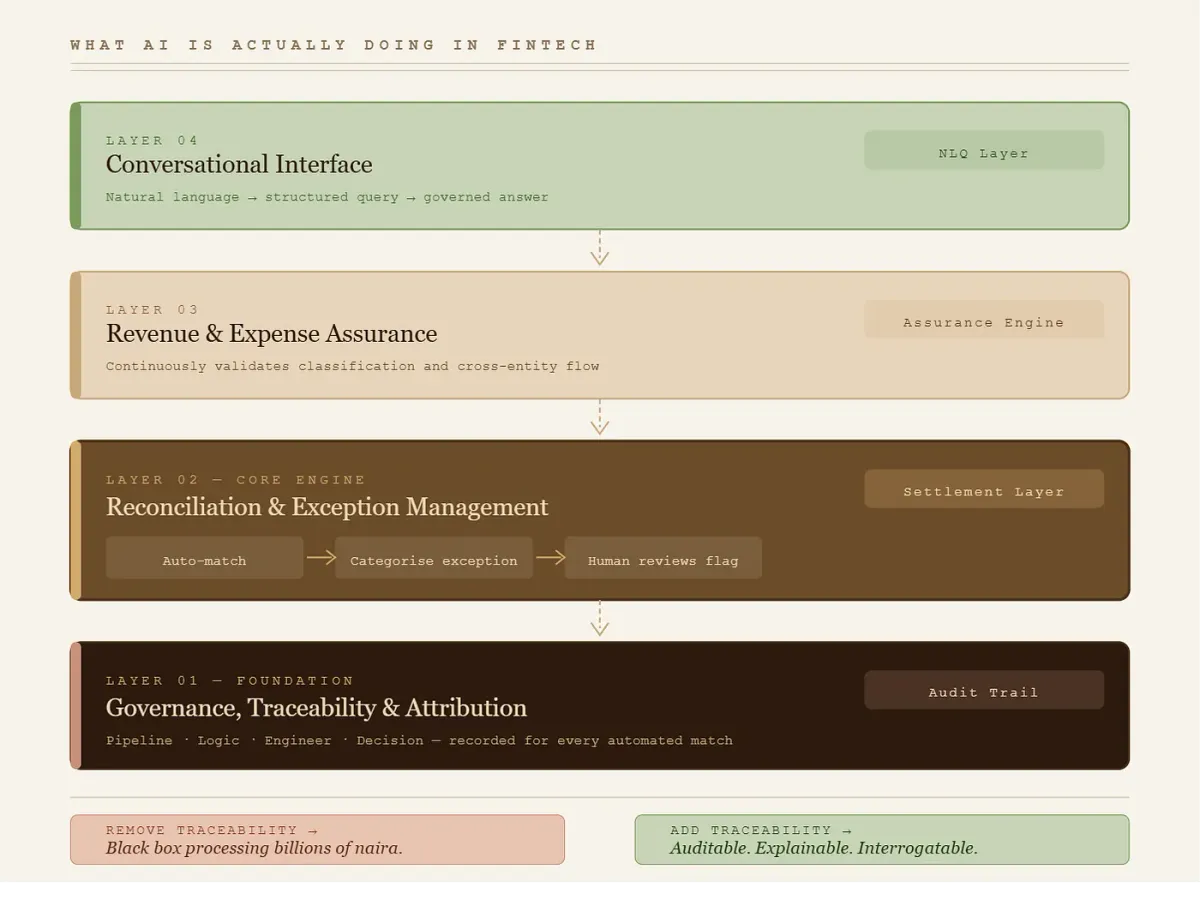
تصور کنید مسئولیت نظارت بر ۱۰۰ میلیارد تراکنش مالی را بر عهده دارید؛ در این مقیاس، هر خطای کوچک در استنتاج مدل میتواند به یک فاجعه حسابداری تبدیل شود. برای Moniepoint، فینتکی که در نیجریه و بریتانیا فعال است، هوش مصنوعی نباید یک «جعبه سیاه» باشد، بلکه باید بر پایه یک معماری حاکمیتی صلب بنا شود که نه بر اساس اسلایدهای تبلیغاتی، بلکه بر اساس محدودیتهای واقعی زیرساختهای بانکی شکل گرفته است.
این رویکرد در زمانی مطرح میشود که بسیاری از سازمانها بدون پاکسازی دادههای زیرساختی، به سراغ استقرار مدلهای زبانی بزرگ (LLM) — که شبیه کتابخانهداری است که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — میروند. در دنیای فینتک، مخاطرات به صورت باینری (صفر و یک) هستند: دادهها یا باید کاملاً ردیابیپذیر و قابل حسابرسی باشند، یا اینکه به یک بدهی و ریسک تبدیل شوند. طبق گزارشهای داخلی این شرکت، مسیر دستیابی به اعتماد در هوش مصنوعی با یک محدودیت عملیاتی بنیادین در سیستم بانکی نیجریه آغاز شد.
بسیاری از بانکهای نیجریهای فاقد APIهای توانمند برای مدیریت حجم عظیم تراکنشهایی هستند که Moniepoint پردازش میکند. این موضوع شرکت را مجبور کرد صورتحسابهای بانکی را بهصورت دستی در سیستمهای تطبیق (Reconciliation) خود بارگذاری کند. اما این روند بلافاصله یک مشکل اعتماد ایجاد کرد: اگر شخصی که داده را بارگذاری میکند، همان کسی باشد که آن را تأیید میکند، هیچ فرآیند تأییدی وجود نخواهد داشت و احتمال خطا یا تقلب بالا میرود.
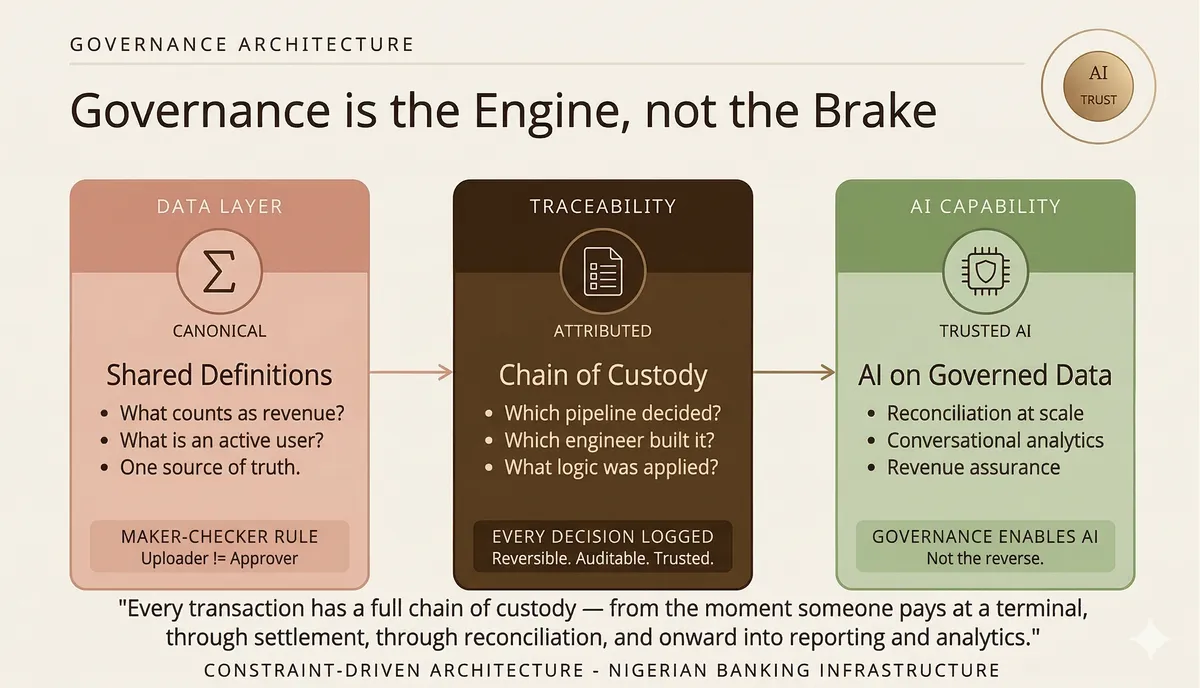
برای جلوگیری از تقلب و خطا، آنها سیستم «سازنده-بررسیکننده» (Maker-Checker) را پیاده کردند؛ یعنی کسی که صورتحساب را بارگذاری میکند، نمیتواند همان کسی باشد که آن را تأیید میکند. این یک تصمیم مربوط به رعایت قوانین (Compliance) نبود، بلکه یک ضرورت عملیاتی برای بقای سیستم بود. با این حال، همین اقدام یک اصل محوری را بنا نهاد که در تمام سیستمهای بعدی شرکت جاری شد.
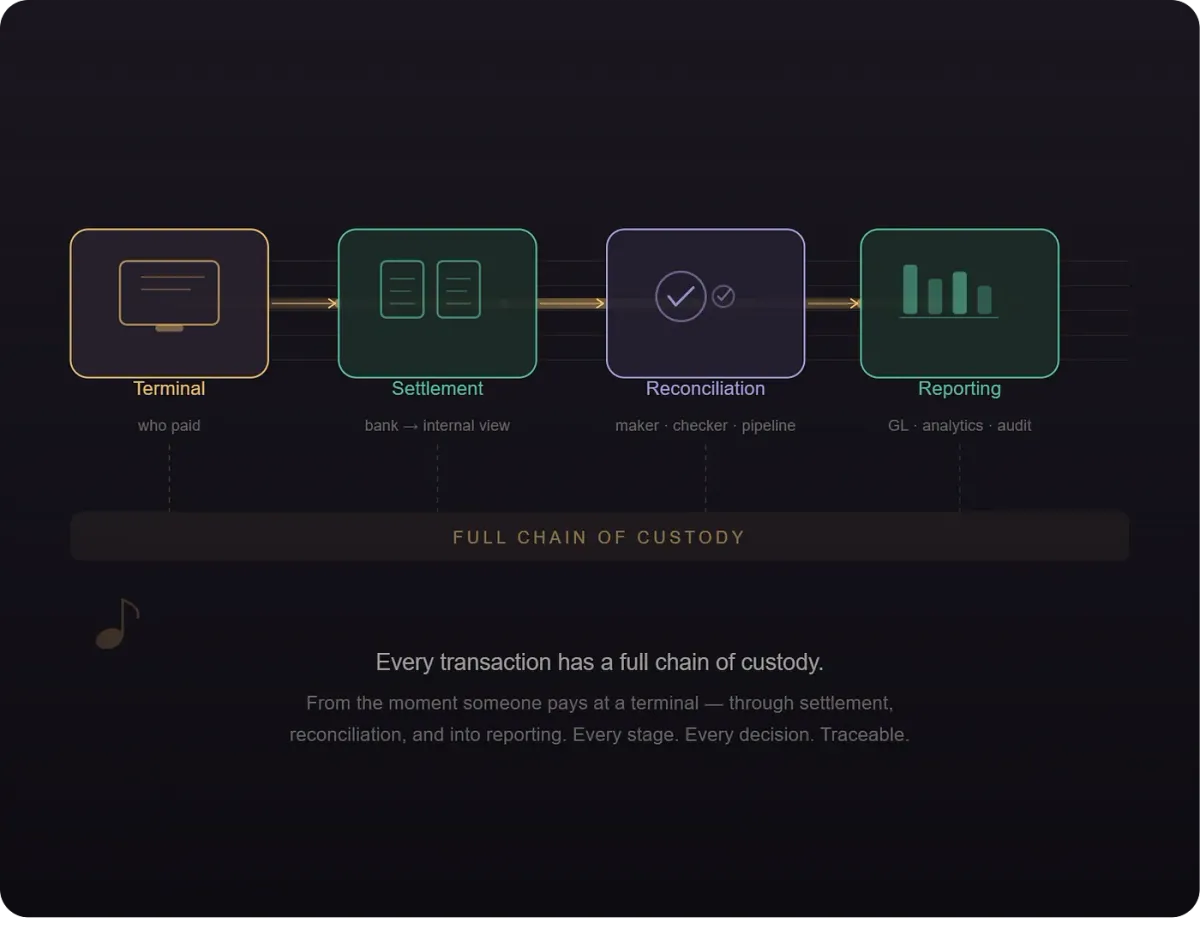
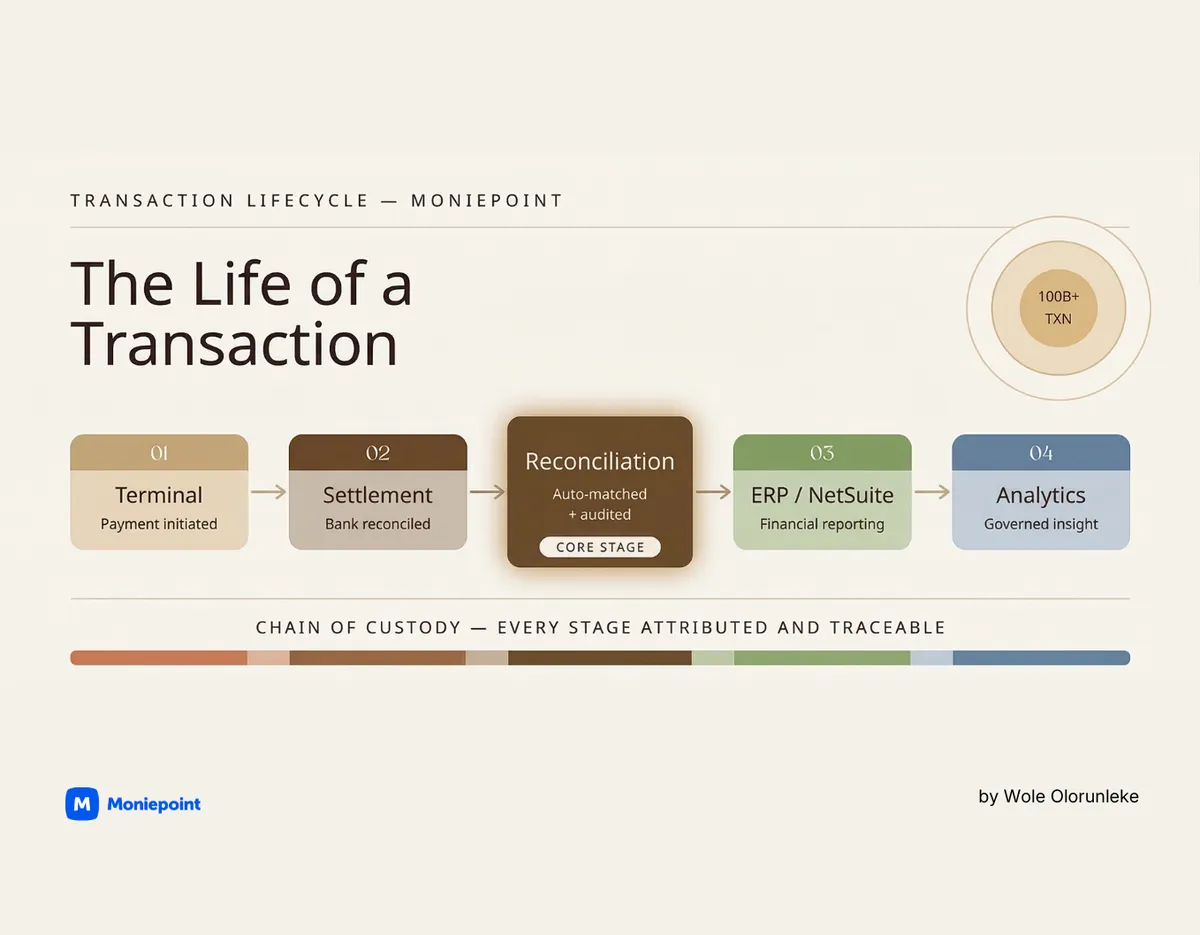
این ضرورت عملیاتی بعدها به یک اصل مهندسی گستردهتر تبدیل شد. اکنون هر تراکنش دارای یک «زنجیره نظارت» (Chain of Custody) کامل است. از لحظهای که مشتری در یک پایانه پرداخت میکند تا ثبت نهایی در سیستم ERP برای گزارشهای مالی، هر گام ثبت میشود. اگر یک سیستم خودکار تراکنشی را تطبیق دهد، سیستم نه تنها نتیجه تطبیق، بلکه این موضوع را که کدام خط لوله (Pipeline) تصمیم گرفته و چه کسی آن خط لوله را ساخته است، ثبت میکند.
چرخه حیات یک تراکنش
در Moniepoint، این ردیابی حتی به گزارشهای تسویه (Settlement Reports) نیز گسترش یافته است. این گزارشها دیدگاه بانک از یک تراکنش را به فرمتی ترجمه میکنند که با سوابق داخلی شرکت قابل مقایسه باشد. این گزارشها همان سطح از ردیابی سیستم Maker-Checker را حفظ میکنند:
- ردیابی منطق (Logic Traceability): اگر یک مهندس داده منطق خاصی برای برچسبگذاری (Tagging) تراکنشها تعریف کرده باشد، میتوان آن تصمیم را دقیقاً به شخص و منطق مورد استفاده بازگرداند.
- پاسخگویی خط لوله (Pipeline Accountability): سیستم دقیقاً ثبت میکند که تراکنش از چه مسیری عبور کرده است تا اطمینان حاصل شود که نتیجه نهایی به دلیل اجرای یک خط لوله خاص توسط یک شخص خاص رخ داده است.
- جریان سرتاسری (End-to-End Flow): فرآیند از پرداخت در پایانه شروع شده، از مراحل تسویه و تطبیق میگذرد و در نهایت برای گزارشهای مالی و تحلیلها وارد ERP میشود.
وول اولورونلکه (Wole Olorunleke)، نایبرئیس سیستمهای مالی شرکت، این معماری عمدی را به یک نت در یک ترکیب موسیقی RioPY تشبیه میکند؛ از لحظهای که نت زده میشود تا ثانیهای که حل میشود، هر ارتعاش باید هدفمند باشد تا سیستم به جای نویز، هارمونی ایجاد کند.
خطر «نظرات شخصی» درباره دادهها
اولورونلکه به یک نقطه شکست رایج در سازمانها اشاره میکند: تعریف «کاربر فعال ماهانه» (MAU). در بسیاری از شرکتها، تیمهای مارکتینگ، محصول و مالی از دادههای خام یکسانی استفاده میکنند اما تعاریف متفاوتی از «فعال بودن» دارند.
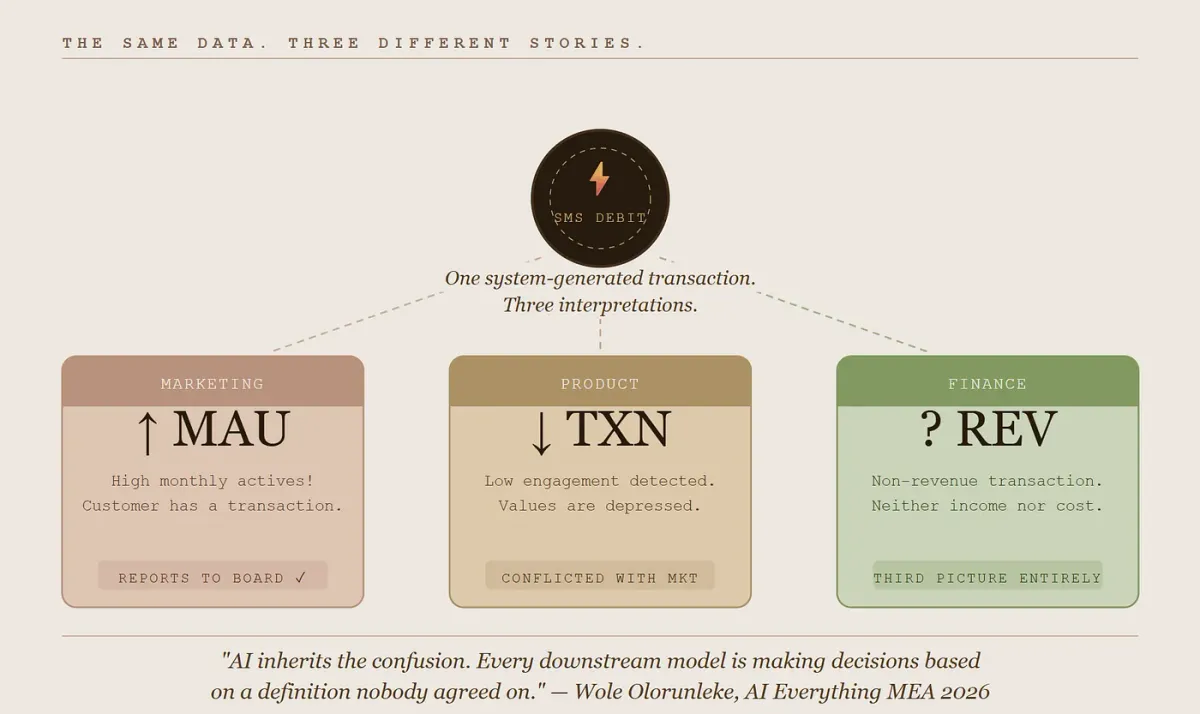
بهعنوان مثال، در یک مؤسسه مالی، مشتریان هر ماه تحت شرایطی که توسط بانک مرکزی تعیین شده، سود دریافت میکنند. در ابتدای ماه، سیستم هزینههای اعلان SMS را کسر کرده و سود درآمدی را برای همان دوره (در صورت برقراری شرایط) ثبت میکند. اینها تراکنشهای سیستم-محور هستند؛ یعنی مشتری اپلیکیشن را باز نکرده، پولی منتقل نکرده و خریدی نکرده است.
اگر تعریف MAU این باشد که «هر مشتری با حداقل یک تراکنش فعال است»، این مشتریان خفته (Dormant) نیز فعال به نظر میرسند. این موضوع باعث میشود سه داستان متفاوت از یک داده خام واحد ساخته شود:
- تیم مارکتینگ عدد MAU بالایی را به هیئتمدیره گزارش میدهد که نشاندهنده رشد و نفوذ در بازار است.
- تیم محصول کاهش تعامل را میبیند، زیرا میانگین ارزش تراکنشها به دلیل گنجاندن کاربران خفته، پایین آمده است.
- تیم مالی تصویری کاملاً متفاوت میبیند، زیرا آنها فعالیتهای درآمدزا را ردیابی میکنند و نه کسر هزینه SMS یا واریز سود که درآمدزایی ندارند.
وقتی مدلهای هوش مصنوعی برای پیشبینی ریزش مشتری (Churn)، امتیازدهی اعتباری یا شخصیسازی روی این دادههای تکهتکه ساخته میشوند، هوش مصنوعی این سردرگمی را به ارث میبرد. مدل با یک مشتری خفته که فقط هزینه SMS پرداخت کرده، طوری رفتار میکند که انگار هر روز در حال تراکنش است. در اینجا مدل شکست نخورده است؛ بلکه دقیقاً همان کاری را میکند که به او گفته شده است. این یک مشکل حاکمیتی است، نه مشکل مدل. همه چیز با یک سوال ساده شروع میشود: «فعال بودن» واقعاً به چه معناست؟
رفع گلوگاه SQL
با رشد تیم مالی، Moniepoint در ابتدا همه را تشویق کرد تا SQL یاد بگیرند تا بتوانند پاسخهای خود را استخراج کنند. این راهکار در ابتدا بدیهی به نظر میرسید: کوئری خودت را بنویس و اعدادت را بگیر. اما این موضوع منجر به یک بحران تاکتیکی شد.
متخصصان ارشد مالی — که برای تحلیل روندها، شکل دادن به استراتژیها و تصمیمات کلیدی استخدام شده بودند — ساعتها وقت خود را صرف عیبیابی Joinهای جداول و تعیین این میکردند که کدام یک از سه جدول مختلف، دادههای درست درآمد را در خود دارد. آنها بهجای استراتژیک بودن، تبدیل به نیروهای تاکتیکی شدند.
این وضعیت منجر به یک مشکل تکهتکه شدن (Fragmentation) شد؛ جایی که ۱۰ تحلیلگر با نوشتن ۱۰ کوئری مختلف روی دادههای یکسان و با منطقهای کمی متفاوت، ۱۰ نسخه مختلف از «درآمد» تولید میکردند. این همان مشکل MAU بود، اما در مقیاس کل تیم ضرب شده بود.
برای حل این مشکل، شرکت یک رابط تحلیل مکالمهای (Conversational Analytics Interface) ساخت. این ابزار به اعضا اجازه میدهد سوالاتی مانند «درآمد این ماه به تفکیک واحد چیست؟» را به زبان انگلیسی ساده بپرسند و پاسخی قابل اعتماد دریافت کنند. اما این AI تنها به این دلیل کار میکند که یک لایه حاکمیتی در زیر آن قرار دارد. بدون تعاریف استاندارد (Canonical Definitions)، ردیابی دادهها (Data Lineage) و یک واژگان مشترک، یک رابط مکالمهای صرفاً چتباتی است که کدهای SQL غلط را سریعتر مینویسد. حاکمیت داده یک «ویژگی» از AI نیست، بلکه چیزی است که AI را ممکن میسازد.
هوش مصنوعی در زیرساخت در برابر رابط کاربری
در حالی که بسیاری تصور میکنند هوش مصنوعی در فینتک یعنی چتباتها یا امتیازدهی اعتباری، واقعیت در Moniepoint زیرساختیتر و کمتر پرزرقوبرق است. سیستم بهطور خودکار میلیونها تراکنش روزانه را تطبیق داده و سوابق داخلی را با دادههای بانکی همسو میکند. این سیستم استثنائات را شناسایی، دستهبندی و اغلب بدون کمک انسان حل میکند.
مکانیزمهای اعتماد:
- تطبیق قابل حسابرسی: هر تطبیق خودکار، خط لوله تصمیمگیرنده، منطق مورد استفاده و دادههای درگیر را ثبت میکند. این به تیم اجازه میدهد یک تطبیق اشتباه را به جای تکیه بر خروجیهای مبهم AI، به یک قانون معیوب یا یک نقطه داده خاص بازگرداند.
- مدیریت استثنائات: ردیابیپذیری اجازه میدهد انسانها فقط استثنائات — یعنی مواردی که AI آنها را نامطمئن علامتگذاری کرده — بررسی کنند، در حالی که به این اعتماد دارند که تصمیمات خودکار ردیابیپذیر و قابل بازگشت هستند.
- چارچوبهای تضمین (Assurance Frameworks): چارچوبهای تضمین درآمد و هزینه بهطور مداوم بررسی میکنند که آیا تراکنشها درست طبقهبندی شدهاند و مبالغ بهدرستی بین واحدها جریان یافته است یا خیر.
بدون این ردیابی، سیستم تبدیل به یک جعبه سیاه میشد که میلیاردها نایرا را پردازش میکند. اما با این معماری، سیستم به یک ساختار قابل حسابرسی و توضیحپذیر تبدیل شده است که یک رگولاتور، سرمایهگذار یا حسابرس میتواند از آن بازخواست کند. این رویکرد سختگیرانه به جای تکیه بر خروجیهای احتمالی، بر صحتسنجی مبتنی بر داده در برابر اعتماد کورکورانه تأکید دارد تا از خطاهای سیستمی جلوگیری شود.
«ممیزی اپراتور» برای ارزیابی AI
در پنل AI Everything MEA Egypt ۲۰۲۶ در قاهره، اولورونلکه در کنار یحیی حوری (Flat6Labs)، عبدالرحمن حسن (Enza Capital) و مجری برنامه مایک بوچر (TechCrunch) صحبت کرد. او تنها «اپراتور» روی صحنه بود؛ کسی که سیستمها را میسازد، نه کسی که آنها را برای قابلیت سرمایهگذاری ارزیابی میکند.
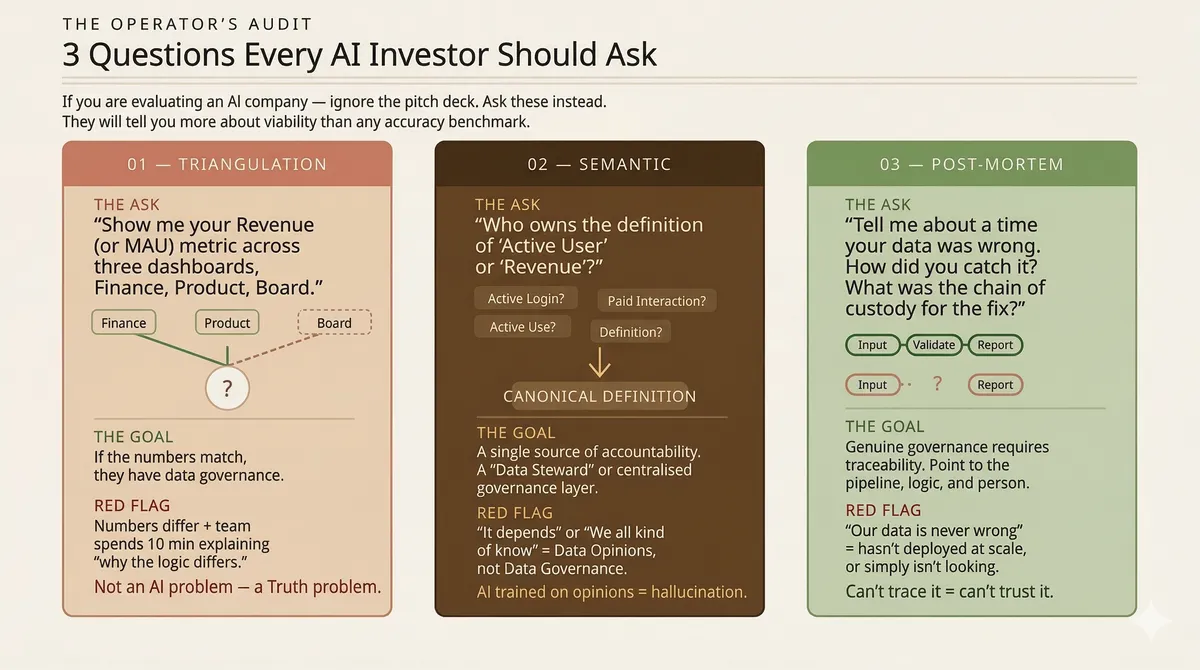
او سه تست برای سرمایهگذاران پیشنهاد داد تا بفهمند آیا یک شرکت AI واقعاً حاکمیت داده دارد یا خیر و از آنها خواست اسلایدهای تبلیغاتی را نادیده بگیرند و این سوالات خاص را بپرسند:
- تست مثلثبندی (The Triangulation Test): بخواهید عدد درآمد یا MAU را در سه داشبورد مختلف (مالی، محصول و گزارش هیئتمدیره) ببینید. اگر اعداد متفاوت بود و تیم ۱۰ دقیقه وقت صرف کرد تا توضیح دهد «چرا منطق مارکتینگ متفاوت است»، شرکت دچار «مشکل حقیقت» است. شما نمیتوانید AI قابل اعتمادی روی یک حقیقت تکهتکه بسازید.
- تست معنایی (The Semantic Test): بپرسید چه کسی مالک تعریف «کاربر فعال» یا «درآمد» است. شما به دنبال یک منبع واحد پاسخگویی هستید، مانند یک «متولی داده» (Data Steward) یا یک لایه حاکمیتی متمرکز. اگر پاسخ «بستگی دارد» یا «همه ما تقریباً میدانیم» بود، شرکت دچار «نظرات دادهای» است و AI آن صرفاً یک موتور تولید توهم با سرعت بالاست.
- تست کالبدشکافی (The Post-Mortem Test): درباره آخرین باری که دادهها غلط بودند بپرسید. چگونه متوجه شدند و «زنجیره نظارت» برای اصلاح آن چه بود؟ یک شرکت بالغ میتواند دقیقاً به خط لوله، منطق و شخصی که آن را اصلاح کرده اشاره کند. شرکتی که ادعا میکند دادههایش «هرگز غلط نیستند»، یک زنگ خطر است؛ یا در مقیاس واقعی فعالیت نکردهاند یا اصلاً جستجو نمیکنند.
مسیر صادقانه: از فاز ۱ تا فاز ۳
Moniepoint اعتراف میکند که در حال حاضر در «فاز ۲» مسیر خود است. قابلیتهای AI آنها ابتدا در تیمهای مختلف شروع شد و تیم سیستمهای مالی از پذیرندگان اولیه بود. آنها مشکلات عملیاتی را شناسایی کردند که در مقیاس آنها بهصورت دستی قابل حل نبود و راهکارهایی برای اتوماسیون تطبیق، تحلیلهای مکالمهای و تضمین درآمد ساختند. اینها در حال حاضر در محیط عملیاتی هستند و پول واقعی را پردازش میکنند.
با این حال، چون این ابزارها برای یک دامنه خاص ساخته شده بودند، تعاریف و خط لولهها مخصوص بخش مالی بود. وقتی به کل سازمان نگاه کردند، متوجه شدند تیمهای دیگر نسخههای خودشان را با فرضهای متفاوت ساختهاند. AI در هر سیلو (Silo) کار میکرد، اما در سطح کل شرکت با هم هماهنگ نبودند.
اکنون Moniepoint در حال انجام سختترین بخش کار است: ساخت یک چارچوب داده سازمانی برای متمرکز کردن تعاریف، حاکمیت و استانداردهای داده در کل سازمان. همانطور که اولورونلکه روی صحنه اشاره کرد، بسیاری از شرکتها «فاز ۳» (حاکمیت کامل) را تبلیغ میکنند در حالی که در «فاز ۱» (بحث بر سر اینکه کدام فایل اکسل منبع حقیقت است) زندگی میکنند.
صادق بودن درباره این شکافها برای سرمایهگذاران ارزشمندتر از یک روایت صیقلخورده است که در مرحله بررسیهای دقیق (Due Diligence) شکست میخورد. همانطور که یکی از سرمایهگذاران پنل اشاره کرد، شرکتی که میتواند شکافهای خود را بیان کند، برنامهای برای بستن آنها دارد.
حاکمیت به عنوان موتور محرک
این تغییر نشان میدهد که برای AI سازمانی، حاکمیت «موتور» است، نه «ترمز». حاکمیت یک هزینه مربوط به رعایت قوانین یا تیک زدن یک گزینه برای رگولاتورها نیست؛ بلکه انضباط مهندسی است که مقیاس عملیاتی، اعتماد سرمایهگذار و انطباق قانونی را ممکن میکند.
شرکتهایی که سعی میکنند حاکمیت را روی سیستمهای موجود «نصب» کنند، با مهاجرتهای گران، کند و شکننده روبرو میشوند. اما کسانی که آن را از روز اول در معماری میگنجانند، سریعتر حرکت میکنند زیرا مدلهای آنها روی دادههایی آموزش میبینند که واقعاً همان معنایی را دارند که ادعا میکنند. ممیزیهای آنها ساده است زیرا ردیابیپذیری از پیش وجود دارد.
برای کسانی که دادههای مقیاسبزرگ را مدیریت میکنند، گام بعدی این است که پیش از افزودن لایههای رابط Generative AI، «منبع حقیقت» خود را در دپارتمانهای مختلف ممیزی کنند. اعتماد در یک سند سیاستگذاری یافت نمیشود، بلکه در یک سیستم عملیاتی یافت میشود که در آن هر تراکنش دارای یک داستان زندگی است که میتوان آن را از ابتدا تا انتها خواند.
- پیش از افزودن لایههای هوش مصنوعی زاینده (Generative AI)، «منبع حقیقت» (Source of Truth) را در دپارتمانهای مختلف سازمان خود ممیزی کنید.
- برای هر شاخص کلیدی (KPI)، یک مالک واحد (Data Steward) تعیین کنید تا از تضاد تعاریف جلوگیری شود.
- سیستمهای خودکار را بهگونهای طراحی کنید که هر تصمیم AI دارای یک ردپای منطقی (Logic Trace) برای بازبینی انسانی باشد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.


گفتگو