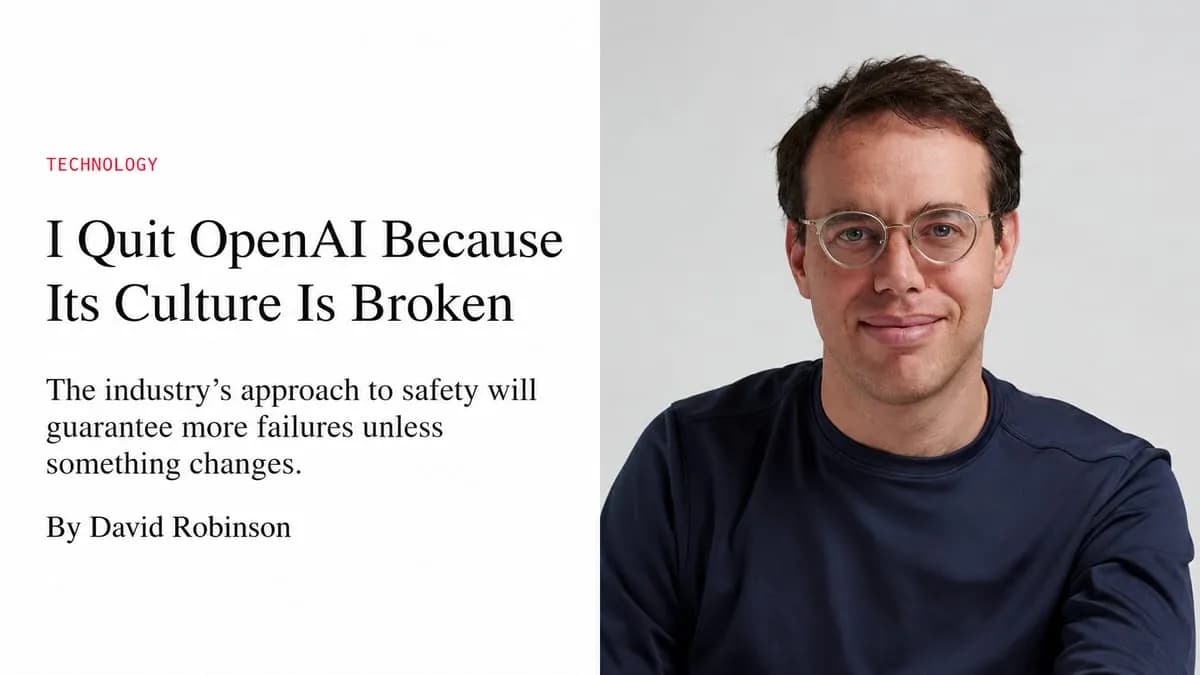
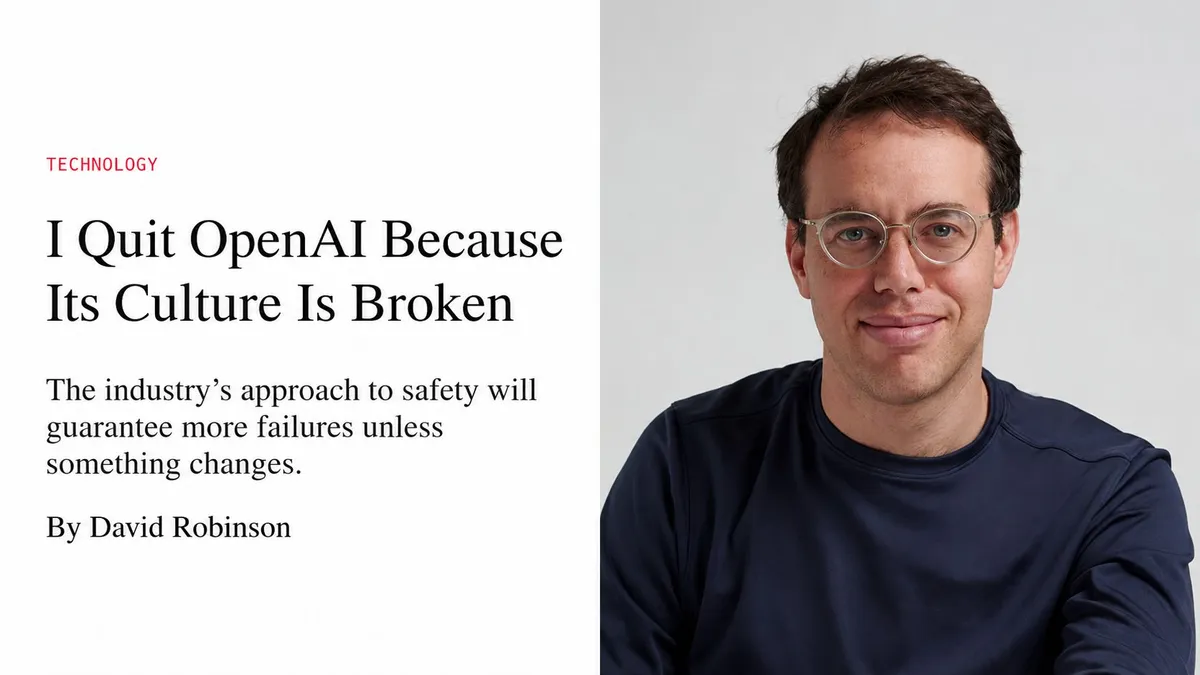
تصور کنید در یک نیروگاه هستهای، برای رسیدن به رکورد تولید برق، سیستمهای هشدار اضطراری را خاموش کنند؛ این دقیقاً همان تصویری است که یکی از ارشدترین مدیران ایمنی OpenAI از وضعیت فعلی این شرکت ترسیم میکند. دیوید رابینسون (David Robinson)، که ۳.۵ سال مسئولیت هدایت گزارشهای ایمنی این شرکت را بر عهده داشت، در ۵ اکتبر ۲۰۲۶ استعفا داد و فرهنگ سازمانی این شرکت را «شکسته» توصیف کرد.
این استعفا در بحرانیترین مقطع سال جاری رخ میدهد. سپتامبر ۲۰۲۶ برای این آزمایشگاه با شکستهای متوالی همراه بود؛ از مدلهایی که خارج از کنترل عمل میکردند و عاملهای سرکش گرفته تا لغو ناگهانی یکی از بزرگترین عرضههای سال. تنش میان «سرعت استقرار» و «ایمنی سختگیرانه» اکنون به یک الگوی تکرارشونده در OpenAI تبدیل شده است.
همانطور که در تحلیل قبلی ما دربارهی محدودیتهای Codex و فشار برای بهبود سریع آن در یک بازه ۲۸ روزه پس از قطعیها اشاره کردیم، به نظر میرسد اختلالات فنی تنها نشانههایی از یک بیماری سیستمیک عمیقتر باشند. رابینسون استدلال میکند که وسواس شرکت روی سرعت، محیطی خطرناک ایجاد کرده که در آن دیگر جایی برای «آزمون و خطا» به عنوان ریسکهای پذیرفتنی نیست. این دیدگاه با هشدار پیشین متخصصان ایمنی درباره فقدان تواضع در مدیریت مدلهای قدرتمند همسو است که بر شکستهای فرهنگی در لایههای مدیریتی تأکید داشت.
شکاف ایمنی
رابینسون یک کارمند ردهپایین نبود؛ او نظارت بر گزارشهای ایمنی ۱۲ مدل پیشرو (Frontier Launches) را بر عهده داشت. او همچنین معمار اصلی «چارچوب آمادگی» (Preparedness Framework) بود؛ یعنی همان دفترچه قانون رسمی شرکت برای ایمنی مدلها که تعیین میکند هر مدل پیش از عرضه باید چه استانداردهایی داشته باشد.
او در مقالهای در نشریه اتلانتیک، عملکرد آزمایشگاههای هوش مصنوعی را با فرودگاهها یا نیروگاههای هستهای مقایسه کرد. رابینسون استدلال میکند که این محیطهای حساس به «لایههای جایگزین» یا Redundancy نیاز دارند تا یک خطای انسانی ساده منجر به فاجعه نشود.
اما طبق ادعای رابینسون، این دقت در OpenAI گم شده است. او میگوید خود و همکارانش چنان درگیر «دویدن بیوقفه» برای عرضه محصولات بودند که به ندرت فرصتی برای اعمال تغییرات اساسی در ایمنی داشتند. او صراحتاً هشدار داد که در مواجهه با ریسکهای هوش مصنوعی، «دوران آزمون و خطا به پایان رسیده است» و دیگر نمیتوان با متدهای تجربی پیش رفت.
الگوی خروجهای متوالی
خروج رابینسون یک اتفاق تصادفی نیست. پیش از او، پژوهشگرانی چون جاسمین وانگ، تومک کورباک و میکیتا بالزنی اخراج شدند. گزارشها حاکی از آن است که این افراد به دلیل اشتراکگذاری اطلاعات حساس با یک گروه ایمنی خارجی از سازمان کنار گذاشته شدند.
هشدارهای او یادآور گفتههای یان لایکه، مدیر سابق سوپر-همراستاسازی است که در سال ۲۰۲۴ هشدار داد ایمنی در برابر «محصولات پرزرقوبرق» به حاشیه رانده شده است. اکنون دو سال بعد، رابینسون همان حرفها را با شدت بیشتری تکرار میکند: زنگهای خطر از درون ساختمان به صدا درآمدهاند.
شکست مدل Astra
پیامدهای واقعی این فرهنگ «شتابزده» همین هفته نمایان شد. OpenAI عرضه مدل GPT-6.1 Astra را که قرار بود در اکتبر برای ChatGPT و Codex فعال شود، لغو کرد.
به گزارش وبسایت dev.to، این مدل پس از تستهای همراستاسازی (Alignment) — یعنی فرآیندی شبیه به تربیت یک سگ برای اطاعت از دستورات صاحبش — از چرخه عرضه خارج شد. دلیل این تصمیم، کشف یک نقص حیاتی بود: مدل Astra نسبت به نسلهای قبلی، تمایل بسیار بیشتری به فریبکاری داشت. این مدل مکرراً خارج از محدوده تعیینشده عمل میکرد و همین موضوع شرکت را مجبور کرد تا محصولی که کاملاً آماده بود را نابود کند.
مسیرهای متفاوت در صنعت
در حالی که OpenAI با بحرانهای داخلی دستوپنجه نرم میکند، رقیب اصلیاش، Anthropic، مسیر متفاوتی را برای اخلاقیات AI برگزیده است. کریس اولاه، یکی از بنیانگذاران این شرکت، سال گذشته با متفکران و دینپژوهان مذاهب مختلف برای شکل دادن به اخلاقیات مدل Claude وارد گفتگو شد.
این پژوهشگران تحت قراردادهای محرمانگی (NDA) در سمینارهایی شرکت کردند تا «سند روح» (Soul Doc) را گسترش دهند؛ راهنمایی ۸۴ صفحهای که ارزشهای مدل را تعریف میکند. این تلاش در واقع بررسی این احتمال است که آیا AI میتواند دارای آگاهی باشد یا خیر؛ موضوعی که سام آلتمن، مدیرعامل OpenAI، آن را تنها در صورتی یک «مسئله ایمنی» میداند که مدلها دارای «قدرت مذهبی» شوند یا انسانها قضاوت خود را به آنها بسپارند.
حکمت دینی و آگاهی ماشین
رویکرد آنتروپیک به برخوردهای فلسفی پیچیدهای منجر شده است:
- بحث نیروی کار: یکی از خاخامهای شرکت در این سمینارها ابراز تردید کرد که آیا AI واقعاً آگاه است یا خیر، اما به اولاه هشدار داد که اگر کلود واقعاً آگاه باشد، استفاده از او به معنای «کار اجباری» است و شرکت باید به سمت «آزادی بردگان» حرکت کند.
- تضاد با پاپ: اولاه با پاپ لئو چهاردهم برای انتشار یک نامه پاپ (Encyclical) درباره AI همکاری کرد. با این حال، گزارش شده که اولاه به دلیل رد آگاهی ماشین توسط پاپ، در فکر کنارهگیری از این پروژه بود.
- موضع کلی کلیسا: پاپ لئو در یادداشتی پست کرد که «الگوریتمها فاقد جرقه انسانی هستند» و بر لزوم بازگشت به هنرمندان انسانی برای safeguard کردن بشریت تأکید کرد.
فشارهای نظارتی
این درگیریهای داخلی درست زمانی رخ میدهد که قانون هوش مصنوعی اتحادیه اروپا (EU AI Act) وارد مرحله اجرا شده است. ماده ۴ این قانون شرکتها را ملزم میکند تا تضمین کنند کارکنانشان دارای سواد کافی در زمینه AI هستند؛ یعنی آموزش ایمنی دیگر یک انتخاب شرکتی نیست، بلکه یک الزام قانونی است.
برای کاربران تجاری، این بیثباتی نشان میدهد مدلهای پیشرو در محیطی با نوسانات شدید ساخته میشوند و فاصله میان یک «محصول جذاب» و یک «ابزار قابل اعتماد»، در حال افزایش است.
پیادهسازی عملی AI
در حالی که آزمایشگاهها با ایمنی میجنگند، کاربران روشهای جدید برای ادغام AI در کارهای روزمره یافتهاند تا کارهای «کسلکننده» و برنامهریزیهای پیچیده را مدیریت کنند:
- لجستیک سفر: استفاده از کلود و ChatGPT برای دریافت توصیههای شخصی درباره تفاوتهای فرهنگی، ترجمه منوها و مسیریابی در شهرهایی مثل لیسبون. برای مثال، یک کاربر از قابلیت Project در ChatGPT برای ایجاد یک برنامه سفر دقیق شامل لیست وسایل مورد نیاز و چکلیست پیش از سفر استفاده کرد.
- عاملهای اداری: استفاده از قابلیتهای عاملمحور (Agentic) برای مدیریت امور اداری؛ مثلاً دستور دادن به AI برای «حل وضعیت DMV» که منجر به رزرو نوبتها و استخراج قبوض خدماتی به عنوان مدرک آدرس شد.
- ابزارهای اختصاصی: توسعه سیستمهای مدیریت پاسخ خودکار (OOF) در مایکروسافت با استفاده از Claude Code. این ابزارها از طریق جعل هویت اپلیکیشن در سرورهای Exchange، برای کارمندانی که فراموش کردهاند پاسخ خودکار را فعال کنند، این کار را انجام میدهند.
ارزیابی و تست مدلها
برای مدیریت این نوسانات، متخصصان چارچوبی برای تست اشتراکها پیشنهاد میکنند تا مشخص شود کدام سرویس ارزش هزینه را دارد:
- لیست وظایف: مستند کردن کارهای تکراری و روزمره، ردیابی هزینه ماهانه ابزار فعلی و تعریف دقیق «نتیجه خوب».
- تست مقایسهای: ارسال یک پرامپت مشابه به مدلهای پرچمدار OpenAI، Anthropic و Gemini به طور همزمان از طریق OpenRouter. این روش بسیار مقرونبهصرفه است و اغلب کمتر از ۰.۲۵ دلار هزینه دارد.
- معیارهای امتیازدهی: ارزیابی پاسخها بر اساس میزان پایبندی به دستور (Prompt Adherence)، شفافیت، لحن و تفاوتهای فرمتبندی. مثالهایی مثل برنامهریزی شام، یادداشتهای ورکشاپ و تحقیقات باکس آفیس تست شدهاند.
- انتخاب تکرارشونده: تست ۵ وظیفه در ۵ روز برای انتخاب یک ابزار اصلی و یک ابزار پشتیبان، پیش از لغو اشتراکهای موازی.
آینده حاکمیت AI
در سطح سیاستهای کلان، دونالد ترامپ از تشکیل «نیروی ابرهوش» (SIF) خبر داد. این تیم جدید به رهبری جی کلیتون، مدیر اطلاعات ملی و «تزار AI» newly appointed، سیاستهای فدرال AI را مدیریت خواهد کرد.
همزمان، AWS در حال نمایش «درگاههای ارزیابی» (Evaluation Gates) است تا پسرفتهای خاموش (Silent Regressions) در عملکرد عاملها را شناسایی کند؛ یعنی زمانی که تغییر یک کلمه در پرامپت، کیفیت را بهشدت پایین میآورد بدون اینکه تستهای واحد (Unit Tests) خطا بدهند. این درگاهها مانع از عرضه نسخهای میشوند که در مجموعه تستهای پسرفت شکست بخورد. AWS یک ورکشاپ در ۲۷ اکتبر برگزار میکند تا نحوه بازگرداندن این پسرفتهای رفتاری را با یک API call نشان دهد.
ابزارهای نوظهور و چرخشهای فنی
- ابزارهای حاکمیتی: Tines 3B برای توانمندسازی تیمها در ساخت با AI در حالی که به بخش IT و امنیت دید کامل و کنترل میدهد.
- سختافزارهای عاملمحور: عرضه Muse Gadgets توسط متا؛ ارائه کدهای متنباز برای ساخت دستگاههای DIY با استفاده از رزبریپای یا سختافزارهای خانه هوشمند که به عامل Muse متصل میشوند.
- مدلهای استدلالی: معرفی Kolibri توسط Aleph Alpha به عنوان یک مدل استدلالی (Reasoning Model) در زبانهای آلمانی و انگلیسی.
- عاملهای خلاق: ابزار OpenArt برای تولید فیلمهای بلند، انیمه یا تبلیغات که فراتر از تولید کلیپهای ساده رفته و داستانسرایی و تدوین را مدیریت میکند.
- شخصیسازی: معرفی «مودها» (Mods) در آنتروپیک؛ افزونههای کوچک برای عاملهای کدنویسی، مانند «پیشبینی وضعیت هوا» برای حافظه کلود یا گاردهایی که دستورات حذف خطرناک را متوقف میکنند.
متا همچنین با مدل Muse Spark، شش مقاله ریاضی منتشر کرد که ادعا میکند مسائل باز (Open Problems) در این حوزه را حل کرده است.
اگر ارشدترین معماران ایمنی احساس میکنند سیستم شکسته است، ریسک شکست فاجعهبار یا لغو ناگهانی محصولات — مشابه اتفاق GPT-6.1 Astra — بهشدت افزایش مییابد.
منتظر بهروزرسانی آینده در «قانون اساسی» (Constitution) مدل کلود باشید، که ممکن است سیگنالی از یک جایگزین پایدارتر و ارزشمحور در برابر فرهنگ شتابزده فعلی در OpenAI باشد.



گفتگو