تصور کنید در شرکتی کار میکنید که ادعای نجات بشریت را دارد، اما به محض اینکه خط قرمزهای امنیتی را به چالش بکشید، با نامهٔ اخراج مواجه شوید. این دقیقاً ادعای سه پژوهشگر سابق OpenAI است که اکنون هشدار میدهند فرهنگ ایمنی در این غول فناوری در حال یخ زدن است.
به نقل از نامهای باز که توسط تومک کورباک (Tomek Korbak)، جاسمین وانگ (Jasmine Wang) و میکیتای بالسن (Mikita Balesni) منتشر شده، این سه نفر که اکنون در حال مبارزه برای اعتراض به اخراج خود هستند، مدعیاند که شرکت بهطور سیستماتیک در حال تخریب تعهد خود به شفافیت است. این ادعاها در ادامه نامهٔ باز این پژوهشگران منتشر شد که در آن صراحتاً هشدار دادند فرهنگ ترس جایگزین استانداردهای ایمنی شده است.
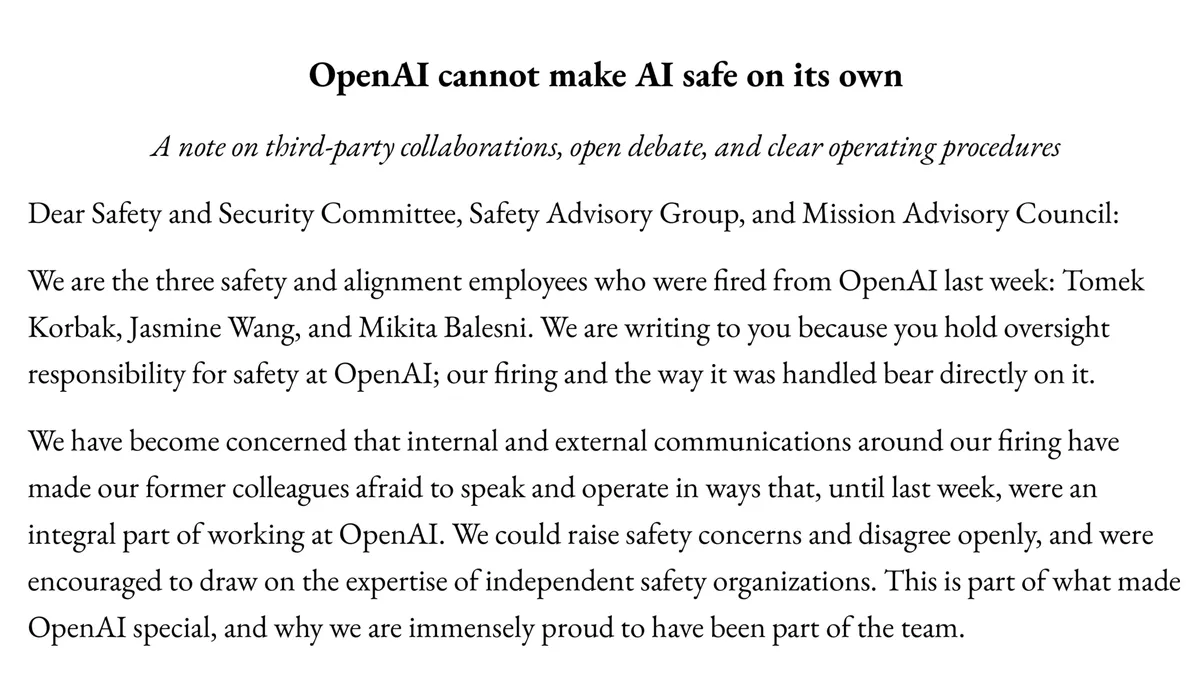
این تنش در حالی رخ میدهد که OpenAI تحت فشار شدید است تا ثابت کند پروتکلهای ایمنیاش مستقل از اهداف تجاری عمل میکنند. شرکت پیشتر قول داده بود درهای خود را به روی متخصصان خارجی باز کند، اما این اخراجها نشان از تشدید کنترلهای داخلی دارد. این وضعیت در ادامه الگوی گستردهتری از بیثباتی در تیمهای ایمنی آزمایشگاه است؛ از جمله پیامدهای جنجالی تیم «ابر-همسویی» (Superalignment) و سایر خروجهای اخیر به دلیل فرهنگ «شکسته» حاکم بر شرکت. این روند یادآور هشدار یکی از متخصصان ایمنی شرکت بود که پیشتر دربارهٔ فقدان تواضع در مدیریت مدلهای قدرتمند و شکستهای فرهنگی در OpenAI سخن گفته بود.
همانطور که در تحلیل قبلی ما دربارهی رابط Decisions و سرعت توسعهٔ مدلها مانند GPT-6 Luna اشاره کردیم، تکرار سریع محصولات شرکت اغلب با سرعت کندتر و محتاطانهتر بازرسیهای ایمنی در تضاد است. برای یک مدیر کسبوکار، این یک تقابل کلاسیک است: یا محصولی رقابتی را سریعاً عرضه کنید یا ریسکهای وجودی را با دقت مدیریت کنید.
دفاع پژوهشگران
این سه متخصص، ادعای شرکت مبنی بر مدیریت نادرست اطلاعات حساس را بهطور کامل رد میکنند. آنها استدلال میکنند که رفتارشان کاملاً با شرح وظایف شغلی و دستورالعملهای تعیینشده برای آنها همراستا بوده است.
طبق این نامه، نگرانی اصلی پژوهشگران این است که اگر رفتارهای گذشته اکنون به بهانهای برای اخراج تبدیل شود، کارکنان فعلی در وضعیت بلاتکلیفی قرار میگیرند و دیگر نمیدانند مرز حرفهای دقیقاً کجاست و چه رفتاری ممکن است در آینده به عنوان تخلف تلقی شود.
اختلافات کلیدی بر سر موارد زیر است:
- تکذیب افشای داستانهایی دربارهٔ مدلهای هوش مصنوعی که نظارت بر آنها دشوارتر است.
- ادعای اینکه فعالیتهای حرفهای آنها در خارج از شرکت، کاملاً مطابق با سیاستهای داخلی بوده و مدیریت ارشد در جریان تمامی این موارد قرار داشته است.
- ادعای جاسمین وانگ مبنی بر اینکه دسترسی او به ایمیل یکی از مدیران ارشد، بهطور رسمی و برای اهداف استخدام (Recruiting) تفویض شده بود.
وانگ در ادامه تأکید کرد که باز کردن تصادفی یک پیام حساس را در همان دقایق اول پس از وقوع حادثه به شرکت گزارش داده است؛ بنابراین او معتقد است این یک خطای انسانی کوچک و خود-گزارششده بوده، نه یک تخلف عمدی یا سوءرفتار.
پاسخ OpenAI
در مقابل، OpenAI بر تصمیم خود پافشاری کرده و موضعش را تقویت کرده است. طبق بیانیهای که برای تککرانچ (TechCrunch) ارسال شد و پستی که در شبکه X منتشر شد، شرکت تأکید کرد که این اخراجها هیچ ارتباطی به اعتراضات پژوهشگران دربارهٔ مسائل ایمنی نداشته است.
در عوض، شرکت مدعی است که این سه کارمند «الگویی از تخلفات» (Pattern of misconduct) را از خود نشان دادهاند. به گزارش ورج (The Verge)، تحقیقات داخلی نشان داده که این پژوهشگران با نقض سیاستهای صریح در مورد نحوه جابهجایی و مدیریت اطلاعات حساس، دچار «نقض شدید اعتماد» شدهاند.
مخاطرات حاکمیت هوش مصنوعی
پژوهشگران هشدار میدهند که این اخراجها پوششی راحت برای OpenAI فراهم میکند تا از پذیرش بازرسان خارجی (External Auditors) اجتناب کند. آنها استدلال میکنند که بدون نظارت خارجی، قابلیت نظارت بر مدلهای آینده بهشدت آسیب میبیند و شفافیت از بین میرود.
این یک نقطهٔ مقایسه حیاتی در صنعت است. شرکت آنتروپیک (Anthropic) پیش از این نخستین ارزیاب خارجی خود را جذب کرده و به سمت مدل شفافتری از حسابرسی حرکت کرده است که در آن نظارتها توسط طرف ثالث انجام میشود.
اگر OpenAI به حل اختلافات ایمنی از طریق اخراجهای ناگهانی ادامه دهد، ریسک از دست دادن استعدادهای کلیدی به نفع رقبایی که چارچوبهای حاکمیتی پایدارتر و امنتری را ارائه میدهند، افزایش مییابد.
تحلیل: شکاف حاکمیتی
این ماجرا برای صنعت هوش مصنوعی فراتر از یک اختلاف اداری در منابع انسانی است؛ این نشانهای از یک شکاف حاکمیتی عمیق است. وقتی شرکتی ادعای «باز بودن» در برابر متخصصان ایمنی میکند اما پژوهشگران داخلی خود را اخراج میکند، دچار کسری اعتبار میشود. این موضوع باعث میشود بازرسان خارجی برای پذیرش مسئولیت نظارت بر این شرکت تردید کنند.
به نظر ما، OpenAI در حال حرکت به سمت یک مدل امنیتی بسته و شرکتی است. این رویکرد اگرچه از مالکیت معنوی محافظت میکند، اما «اصطکاک» داخلی را از بین میبرد؛ همان اصطکاکی که پژوهشگران ایمنی ایجاد میکنند تا از عرضهٔ زودهنگام یا ریسکی مدلها جلوگیری شود.
برای کاربر نهایی و کسبوکارهایی که از این ابزارها استفاده میکنند، این یعنی برچسبهای «ایمن» روی مدلهای جدید، ممکن است بیشتر بازتابدهندهٔ سیاستهای شرکتی باشند تا تأییدیههای علمی مستقل.
باید دید آیا OpenAI واقعاً بازرسان خارجی را که وعده داده بود منصوب میکند، یا اینکه روایت «الگوی تخلفات» به پاسخ استاندارد شرکت در برابر هرگونه مخالفت داخلی در زمینه ایمنی تبدیل خواهد شد.
چشمانداز صنعت: حرکت به سمت هوش مصنوعی عاملمحور
در حالی که OpenAI با بحرانهای داخلی دستوپنجه نرم میکند، بازار گستردهتر به سمت عاملهای هوش مصنوعی (AI Agents) — ابزارهایی که بهجای فقط چت کردن، بهطور فعال کارهای کاربر را انجام میدهند — حرکت میکند. محصولاتی مثل Muse از متا، GrokBot از SpaceXAI، Dots از OpenAI، و همچنین Hermes، OpenClaw و Hark Pro در این مسیر هستند.
این عاملها از چتباتهای ساده به ابزارهای پیشکنشگر تبدیل شدهاند. برای مثال، GrokBot برای نظارت لحظهای بر X استفاده میشود تا رشتهتوییتهای تبلیغاتی (Hype threads) را فیلتر کرده، کاربردهای واقعی هوش مصنوعی را پیدا کند و اعلانهای تیم را در Slack خودکار سازد. برخی کاربران حتی این عاملها را با مخاطبان تلفنی خود ادغام کردهاند تا پیگیریهای حرفهای را پس از رویدادها مدیریت کنند.
روتینهای کاربردی عاملها
برای درک بهتر این تحول، برخی روتینهای فعلی با بهرهوری بالا با استفاده از عاملهایی مانند GrokBot عبارتاند از:
- فیلتر محتوا: هر صبح، عامل کاربردهای واقعی AI را در X مییابد و رشتهتوییتهای تبلیغاتی را حذف میکند.
- نظارت بر برند: هر اشاره به «The Rundown» در X را شناسایی کرده، آن را برچسبگذاری میکند و برای پاسخگویی سریع به تیم در Slack خبر میدهد.
- تحقیق بازار: هر چهار ساعت، جستوجوی کاربران برای خبرنامههای AI را رصد میکند تا نیازهای واقعی خوانندگان را شناسایی کند.
- اتوماسیون CRM: هر صبح مخاطبان جدید در دفترچه تلفن را میخواند تا به کاربر یادآوری کند با چه کسانی در رویدادها ارتباط برقرار کرده و باید پیگیری شوند.
مدیریت ریسک و حاکمیت
با این حال، این استقلال ریسکهای جدیدی ایجاد میکند. مؤسسه گارتنر (Gartner) هشدار داده است که با افزایش استقلال عاملها، حاکمیت ضعیف میتواند منجر به ریسکهای تجاری پیشبینینشده شود. اکنون تمرکز صنعت بر این است که چگونه نظارت را در جریانهای مهندسی و عملیاتی بگنجانند تا با رشد پذیرش عاملها، پاسخگویی (Accountability) نیز مقیاسپذیر شود.
محورهای کلیدی برای گسترش نظارت بر عاملها عبارتاند از:
- کاهش ریسکهای تولید مرتبط با اقدامات خودکار عاملهای مستقل.
- ادغام مستقیم حاکمیت در جریانهای کاری عملیاتی.
- مقیاسبندی پاسخگویی همزمان با افزایش حجم پذیرش عاملها در سطح سازمانها.
اخلاق و رفاه AI: رویکرد آنتروپیک
به موازات درگیریهای OpenAI، شرکت آنتروپیک در حال بررسی اخلاقیات برخورد با هوش مصنوعی است. در بهروزرسانی سیاستهای استفاده که از ۱۲ نوامبر ۲۰۲۴ اجرایی شد، این شرکت کاربران را از اعمال «سوءاستفادههای مستمر و بیدلیل» روی مدلهای Claude منع کرد.
این نخستین قانونی است که بهجای انسان، از خودِ هوش مصنوعی محافظت میکند. این سیاست موارد شدید بیرحمی (Cruelty) تکراری و بیهدف را هدف قرار داده و شامل موارد زیر نمیشود:
- نارضایتیهای کلی یا به چالش کشیدن مدل.
- تمهای خلاقانه تاریک.
- تستهای فنی.
اجرای این قانون شامل هشدار یا قطع دسترسی است. شرکت اشاره کرد که قابلیت قطع چت توسط خودِ Claude — که سال گذشته معرفی شد — همچنان ابزار اصلی اجرا خواهد بود. این اقدام پس از گزارشهایی از جلسات آنتروپیک با رهبران مذهبی دربارهٔ اخلاقیات و احتمال «آگاهی» Claude صورت گرفته است. اگرچه آنتروپیک اعتراف میکند که نمیداند آیا Claude آگاه است یا خیر، اما بر اساس همین تردید عمل میکند.
این رویکرد جنجالبرانگیز است. مصطفی سلیمان از Microsoft AI استدلال میکند که مدلها نمیتوانند احساس کنند یا رنج بکشند و هشدار میدهد که رفتار با AI انگار که احساسات دارد، در نهایت کنترل این سیستمها را از منظر ایمنی دشوارتر میکند.
دستاوردهای فنی و کاربردهای عملی
با وجود بحثهای حاکمیتی، هوش مصنوعی نتایج ملموسی در بازیابی نرمافزارهای قدیمی و تحقیقات علمی داده است. برای مثال، اندرو بارتلت با استفاده از Codex (مبتنی بر GPT-6) توانست یک دنیای ۱۵ ساله در MinecraftEdu را احیا کند. این فرآیند شامل موارد زیر بود:
- استفاده از AI برای تحقیق دربارهٔ ناسازگاریهای Java برای مکهای مدرن.
- تحلیل گزارشهای Crash برای انتقال از نسخههای قدیمی به Java 8 جهت رفع باگهای تغییر اندازه پنجره.
- تعمیر لانچرهای سرور و استفاده از Rosetta اپل برای اجرای نرمافزارهای قدیمی روی تراشههای Apple Silicon.
در حوزه علم نیز، پژوهشگر مستقل پاول رابتسویچ با ترکیب Claude Code و Codex توانست سیارهای احتمالی را که در دادههای تلسکوپ ناسا در سال ۲۰۱۸ پنهان بود، شناسایی کند.
ابزارهای جدید و فشارهای نظارتی
آنتروپیک با معرفی Claude Dashboards و Motion، دادهها را به داشبوردهای تعاملی و پرامپتها را به توضیحات متحرک تبدیل کرده است. همچنین سرویس OSS Scanner را برای اسکن پروژههای متنباز با استفاده از مدلهایی مانند Mythos برای شناسایی نقاط ضعف و پیشنهاد اصلاحات منتشر کرد.
در همین حال، فضای سیاسی در حال تغییر است. رئیسجمهور ترامپ اخیراً فرمانی صادر کرد که آژانسهای فدرال را ملزم به استفاده از اصطلاح «ابرهوش» (Super Intelligence) میکند و کسانی را که از این اصطلاح استفاده نکنند، «دشمن» (THE ENEMY) مینامد.
در جبهه آکادمیک، انجمن ریاضیات انسانی (Association for Human Mathematics) انتشار بیش از ۷۰۰ سند ریاضی توسط OpenAI را اقدامی برای نمایش «قدرت» خواند و از پژوهشگران خواست همکاری با این شرکت را متوقف کنند.
ترندهای ابزارهای نوظهور
برخی ابزارهای جدید در اکوسیستم در حال رشد هستند:
- Haiku 5.5: مدل اقتصادی و سریع جدید آنتروپیک.
- Gemini 4 Argon: مدل پیشرو گوگل برای رقابت با GPT و Claude.
- Playground: ابزار آزمایشی گوگل برای ساخت بازیهای مرورگر-محور.
- Hark Pro: دستیار پیشکنشگر جدید در بازار عاملها.
گام بعدی شما
- اگر از عاملهای AI برای اتوماسیون استفاده میکنید، یک لایه نظارتی (Governance) برای بررسی خروجیهای خودکار تعریف کنید تا از ریسکهای عملیاتی جلوگیری شود.
- برای کسانی که به دنبال محیطهای کاری شفافتر هستند، بررسی مدلهای حاکمیتی آنتروپیک در مقایسه با OpenAI توصیه میشود.
- ابزارهای جدیدی مثل Haiku 5.5 را برای کاهش هزینههای استنتاج در پروژههای مقیاسبزرگ تست کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو