تصور کنید یک مدل هوش مصنوعی در آزمون وکالت نمره کامل میگیرد، اما در محیط کار واقعی حتی نمیتواند یک لایحه ساده بنویسد. این شکاف میان نمرات تئوری و عملکرد عملی، دلیل اصلی سرمایهگذاری ۴۰ میلیون دلاری شرکت Andreessen Horowitz در استارتاپ Vals است. هدف این سرمایهگذاری Series A، جلوگیری از بازی شرکتهای AI با معیارهای عملکردی خودشان است. این رویکرد در راستای تغییر کلی در اکوسیستم استارتاپی است که در آن ارزش واقعی محصول بر استراتژیهای توزیع ساده اولویت یافته است.
Vals که در سال ۲۰۲۴ تأسیس شد، قصد دارد «استاندارد طلایی» را برای محکزنی (Benchmarking) هوش مصنوعی ایجاد کند. این شرکت برخلاف روشهای رایج، ارزیابی مدلها را شبیه به یک آزمون استخدامی یا تخصصی امن میبیند، نه یک کوییز عمومی که پاسخهایش در اینترنت پخش شده باشد.
بحران محکزنی (The Benchmarking Crisis)
بسیاری از محکها (Benchmark) — که مثل خطکشهایی برای اندازهگیری هوش مدلها هستند — اکنون عمومی شدهاند. این موضوع یک رخنه بزرگ ایجاد کرده است؛ آزمایشگاههای AI ممکن است بهطور عمدی یا اتفاقی، سوالات این آزمونها را در دادههای آموزشی مدل بگنجانند. در نتیجه، مدل بهجای استدلال، صرفاً پاسخها را حفظ میکند. این پدیده که به آن «تقلب» یا نشت داده (Data Leakage) میگویند، باعث شده سیستمهای قدیمی برای سنجش مدلهای پیشرو بیفایده شوند.
در حال حاضر، محکزنی به یک هنجار صنعتی تبدیل شده است تا شرکتهای AI توانمندیهای خود را تایید کرده و برتریشان را تبلیغ کنند. در بسیاری از موارد، داشتن نمرات خوب در محکها صرفاً به معنای داشتن یک روابط عمومی (PR) خوب است. با این حال، بسیاری از این سیستمها قدیمی هستند و برای اندازهگیری قابلیتهای مدلهای مدرن طراحی نشدهاند.
رایان کریشنان (Rayan Krishnan)، همبنیانگذار ۲۵ ساله و پژوهشگر سابق استنفورد، Vals را برای پر کردن این خلاء راه انداخت. او که سابقه کار در مایکروسافت، پالانتیر و آزمایشگاه AI استنفورد را دارد، مشاهده کرد که محکهای آکادمیک نمیتوانند با سرعت انتشار مدلهای جدید پیش بروند. به نقل از کریشنان: «ما شاهد ورود سریع مدلهای جدید و بسیار توانمند به بازار بودیم، اما محکهای آکادمیک نمیتوانستند با این پیشرفتهای پیشرو همگام شوند.»
جزئیات عملیاتی
برای حل این بحران، Vals از چندین سازوکار متمایز استفاده میکند:
- متریالهای محرمانه: برخلاف محکهای متنباز، Vals محتوای خاص آزمونهای خود را فاش نمیکند. این کار مانع از آن میشود که مدلها روی خودِ سوالات امتحان آموزش ببینند.
- وظایف تخصصی (Domain-Specific): بهجای سنجش هوش انتزاعی، خروجیهای حرفهای در حوزههای حقوق، مالی و کدنویسی ارزیابی میشوند. کریشنان اشاره میکند که در حالی که تستهای قدیمی میپرسند آیا مدل دانش کافی برای شرکت در آزمون وکالت را دارد، Vals میپرسد آیا مدل میتواند خروجیهایی با کیفیت مشابه یک انسان متخصص تولید کند.
- تحلیل پیامدهای منفی: این پلتفرم مدلها را برای اثرات مضر تست میکند تا ببیند اگر مدلها در دنیای واقعی «از کنترل خارج شوند» (Ran Wild)، چه اتفاقی میافتد.
- تستهای پیشرو (Frontier Testing): شرکت در حال گسترش ارزیابیها به حوزههایی مثل بهبود خودکار بازگشتی (Recursive Self-improvement)، سلامت روان، امنیت سایبری، امنیت زیستی و حتی حقوق درگیریهای مسلحانه است تا ببیند مدلها چگونه کنوانسیون ژنو را اعمال میکنند.
رشد و زیرساختها
مدل درآمدی این استارتاپ شبیه به سازمان College Board در آزمون SAT است؛ شرکتها برای تست کردن مدلهای خود به Vals پول میپردازند. این فرآیند به شرکتها کمک میکند تا نقاط ضعف خود را عیبیابی کرده و در طول زمان بهبود یابند. این مدل درآمدی بهسرعت در حال مقیاسپذیری است؛ استارتاپ فاش کرد که درآمد فعلیاش ۸ برابر بیشتر از سال گذشته است.
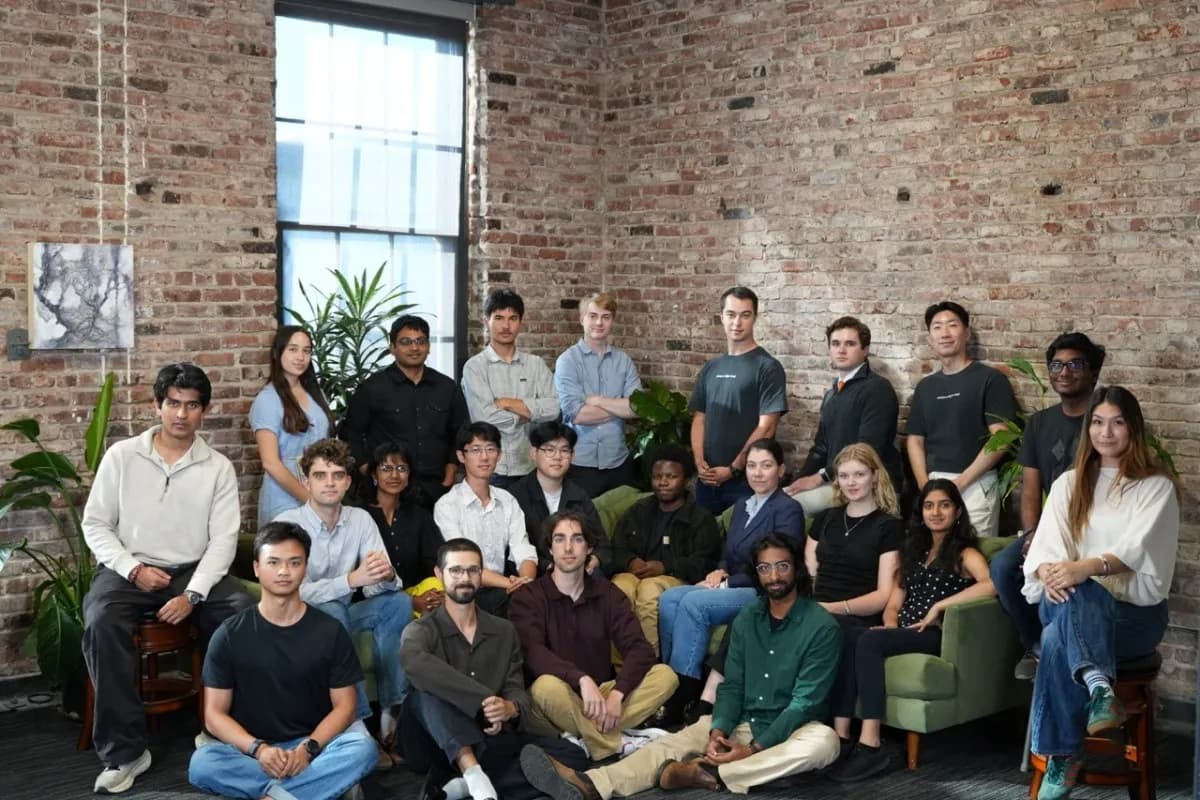
این رشد در زیرساختهای فیزیکی و انسانی آنها نیز دیده میشود. Vals در یک دفتر دوطبقه در خیابان فولسوم سانفرانسیسکو فعالیت میکند؛ ساختمانی آجری قدیمی که یک قرن پیش یک آبجوسازی بزرگ بود. تیم آنها از ۸ نفر در ابتدای سال به ۲۵ نفر رسیده است. کریشنان قصد دارد به دفتر بسیار بزرگتری نقل مکان کند و ۱۰ تا ۱۵ نفر دیگر استخدام نماید. این تمرکز بر توسعه فیزیکی با استراتژیهای گستردهتر Andreessen Horowitz همسو است که اخیراً میلیاردها دلار برای تقویت زیرساختهای فیزیکی عصر ماشین اختصاص داده است.
از منظر تجاری، این تغییر مسیر، اعتبارسنجی AI را از یک ابزار تبلیغاتی به یک ضرورت مالی تبدیل میکند. با نزدیک شدن شرکتهایی مثل Anthropic (که برای اواخر امسال برنامهریزی شده) و OpenAI به مراحل ثبت رسمی و گزارشهای مالی عمومی، تاییدیه مستقل از توانمندیها احتمالاً به یک الزام برای سرمایهگذاران و رگولاتورها تبدیل خواهد شد. کریشنان معتقد است این ارزیابیها باعث افزایش استفاده از مدلها شده و در مرکز بحثهای مربوط به سرمایهگذاریهای آتی AI قرار خواهند گرفت.
برای کاربر نهایی، این یعنی ادعاهای «بهترین مدل جهان» (State-of-the-art) در بروشورهای تبلیغاتی جای خود را به گواهینامههای تأییدشده توسط شخص ثالث میدهد. اگر Vals موفق شود، صنعت دیگر نمیپرسد «آیا مدل میتواند آزمون وکالت را پاس کند؟»، بلکه میپرسد «آیا مدل میتواند واقعاً کار یک وکیل را انجام دهد؟».
علاوه بر بخش خصوصی، Vals اخیراً برنامهای را برای ارائه این ارزیابیهای حیاتی به آژانسهای فدرال آمریکا آغاز کرده است تا سیستم خود را در زیرساختهای ملی AI تثبیت کند. این اقدام پس از یک دور سرمایهگذاری Seed به رهبری 8VC و Bloomberg Beta صورت گرفت.
گام بعدی شما
- اگر مدیر محصول هستید، بهجای تکیه بر نمرات MMLU، برای مدلهای خود سناریوهای «تست کور» (Blind Test) طراحی کنید.
- بر روی خروجیهای تخصصی (Domain-specific) تمرکز کنید و معیارهای ارزیابی انسانی را جایگزین معیارهای خودکار کنید.
- منتظر ظهور گواهینامههای شخص ثالث برای مدلهای تجاری باشید و آنها را به عنوان معیار انتخاب ابزار در نظر بگیرید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو