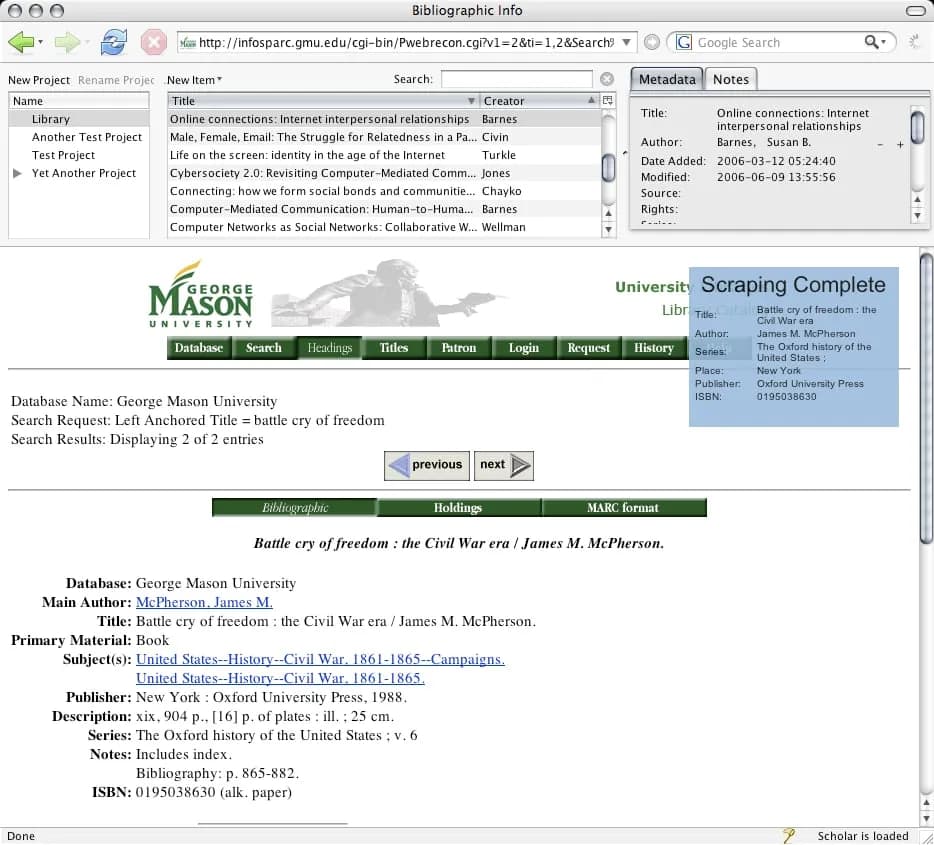
تصور کنید ابزاری که ۲۰ میلیون پژوهشگر به آن تکیه کردهاند، نه با یک پرامپت سریع یا یک دوی سرعت نرمافزاری، بلکه با سالها گفتگوهای طولانی تاریخنگاران دور یک میز بزرگ شکل گرفته باشد. زوتیرو (Zotero)، دستیار پژوهشی متنباز، در ۵ اکتبر ۲۰۲۶ بیستمین سالگرد تأسیس خود را جشن میگیرد و امروز به عنوان یک ضد-مثال آشکار در برابر فرهنگ «رضایت آنی» عصر هوش مصنوعی ایستاده است. در دنیای امروز، نرمافزارها تقریباً در لحظه و با کمک هوش مصنوعی زاینده (Generative AI) ساخته میشوند؛ جایی که کاربران، همانطور که رابین اسلون میگوید، صرفاً «آنچه را که میخواهند درخواست میکنند». اما زوتیرو نقطه مقابل این رضایت آنی است.
در حالی که هوش مصنوعی مدرن میتواند در عرض چند دقیقه نرمافزارهای کاربردی تولید کند، پیدایش زوتیرو پنج سال زمان برد تا فقط یک نمونه اولیه خام تولید شود و سالهای بیشتری صرف صیقل دادن آن شد. این تضاد با چالشهای فعلی ابزارهای تولید سریع نرمافزار مشهود است، جایی که برخی مطالعات محدودیتهای تبدیل مستقیم پرامپت به اپلیکیشنهای پیچیده را افشا کردهاند. طبق گزارش بازنگرانه مشارکتکنندگان اولیه در مرکز تاریخ و رسانههای جدید روی روزنزویگ (RRCHNM)، این شکلگیری کند یک نقص نبود، بلکه یک ویژگی بود. تیم توسعه استدلال میکند که اگر در سالهای آغازین دهه ۲۰۰۰ هوش مصنوعی وجود داشت، باز هم نمیتوانستند روند خلق زوتیرو را تسریع کنند؛ چون آنها هنوز دقیقاً نمیدانستند چه میخواهند. آنها نمیتوانستند پرامپتهای منسجمی که برای ساخت چنین ابزاری توسط یک مدل زبانی بزرگ (LLM) لازم است را بنویسند. در عوض، زمان زیاد و همکاریهای انسانی منجر به توسعه یک چشمانداز روشن شد و در نهایت نرمافزاری خلق شد که بهجای گذرا بودن، بادوام است.
پیشتاریخ جمعآوری دیجیتال
توسعه نرمافزار در ابتدا تمرکز اصلی مرکز تاریخ و رسانههای جدید نبود. این مرکز که در سال ۱۹۹۴ تأسیس شده بود، بر توسعه سایتهایی برای وب متمرکز بود. در ژانویه ۲۰۰۱، یک پژوهشگر که تازه دکتری خود را گرفته بود، برای کار روی تاریخ علم به مرکز پیوست. او در کنار جیم اسپارو، استاد تاریخ دانشگاه شیکاگو که تاریخ تکنولوژی را مطالعه کرده بود، وبسایتی به نام ECHO (کاوش و جمعآوری تاریخ بهصورت آنلاین) ساختند که توسط بنیاد آلفرد پی اسلون تامین مالی میشد.
از آنجایی که تعداد تاریخنگاران علم با سرعتی کمتر از خودِ حوزه علم در حال رشد بود، تیم تلاش کرد تا از وب برای کمک به دانشمندان در مستندسازی کارهایشان استفاده کند. این امر نیازمند «ابزارهای» تعاملی — اپلیکیشنهای وب کوچک — بود که اجازه میداد دادهها آپلود، مرتب و آرشیو شوند. این آزمایشها به دو ابزار اولیه و متفاوت منجر شد:
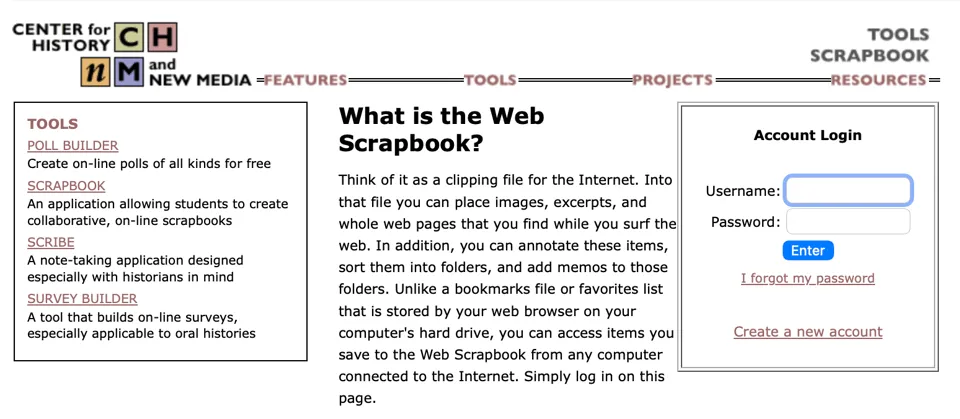
- Web Scrapbook: یک برنامه PHP که به دانشجویان اجازه میداد تصاویر، لینکها و سایر منابع را از طریق بوکمارکهای جاوا اسکریپت از مرورگر ثبت کنند. اگرچه در کلاسهای درس مفید بود، اما دقیق نبود؛ نسخه اولیه رمزهای عبور را بهصورت رمزنگارینشده در اینترنت ارسال میکرد و توجه بسیار کمی به متادیتای مورد نیاز برای پاورقیهای علمی داشت.
- Scribe: یک برنامه پایگاهداده مستقل که با FileMaker توسط النا رازلوگوا ساخته شد. النا در حالی که دانشجوی دکترا بود، مدیر وب RRCHNM بود (و اکنون استاد دانشگاه کنکوردیا است). کاربران Scribe را برای یادداشتبرداری و ذخیره ارجاعات روی کامپیوترهای شخصی خود دانلود میکردند. این ابزار به جایگزینی رایگان و محبوب برای نرمافزارهای تجاری مانند EndNote تبدیل شد و قابلیتهای سازماندهی، جستجو و حاشیهنویسی را ارائه میداد.
تا سال ۲۰۰۳، تیم متوجه شد هیچکدام از این دو ابزار کافی نیستند. آنها بیشتر پژوهشهای خود را در وب شروع میکردند و معتقد بودند هر برنامه پژوهشی قدرتمند در آینده باید به محیطی متصل باشد که منابع اولیه و ثانویه در آن قرار دارند — چه به صورت اشیاء دیجیتالی کامل و چه به صورت متادیتا در کاتالوگهای کتابخانه. آنها به یک مدل ترکیبی نیاز داشتند: ابزاری که در مرورگر زندگی کند اما قابلیتهای متادیتای دقیق یک برنامه پژوهشی مستقل را داشته باشد.
این چشمانداز در ۲۹ نوامبر ۲۰۰۳ رسمی شد، زمانی که روی روزنزویگ به النا رازلوگوا ایمیلی زد و درباره نسخه بعدی Scribe پرسید. روی، تام شاینفلدت (که اکنون استاد علوم انسانی دیجیتال در دانشگاه کنتیکت است) و تیم در حال کار روی یک پیشنهاد گرنت برای مرحله جدید ECHO بودند و میخواستند ابزارهای نرمافزاری بهبودیافتهای را در آن بگنجانند. در ۱ دسامبر ۲۰۰۳، النا با یک لیست آرزوهای مشخص پاسخ داد:
- اتصال به پایگاههای داده کتابشناختی آنلاین
- استایلهای ارجاع بیشتر (بهویژه APA و استایلهای حقوقی)
- قابلیت افزودن استایلهای ارجاع سفارشی و فیلدها/انواع بیشتر برای منابع
- سیستم نام کاربری/رمز عبور برای به اشتراکگذاری و ویرایش مشترک کتابشناسیها و یادداشتها بهصورت آنلاین
- قابلیت کار بهصورت محلی و سپس انتشار بخشهایی از کار در وب (مشابه iCal)
- پشتیبانی از زبانهای خارجی و یک دفترچه راهنمای بهتر
- یک لیست بحث آنلاین (با استفاده از نرمافزاری که توسط مارتی نصب شده بود)
تام شاینفلدت این هدف را به عنوان نیاز به «وبگونه کردن» (webify) Scribe توصیف کرد. «جام مقدس» آنها ابزاری بود که بتواند متادیتای علمی و اشیاء را در مرورگر شناسایی کند و در عین حال از طریق پروتکلهای ارتباطی با واژهپردازندهای دسکتاپ و سایر خدمات وب تعامل داشته باشد.
جهش فایرفاکس
در RRCHNM، تیم یک تخته سفید بزرگ داشت که ایدههای مبهم و گاهی مضحک روی آن نوشته میشد تا جرقههای الهام ایجاد کند. در طول ناهارهای گروهی، اساتید و کارکنان درباره تکنولوژیهای جدید بحث میکردند. تا تابستان ۲۰۰۴، این جمع گسترش یافت و افرادی چون جاش گرینبرگ (دکتری مطالعات علم و تکنولوژی و مدیر برنامه در بنیاد آلفرد پی اسلون)، شارون لئون (دکتری تاریخ آمریکا و همبنیانگذار Digital Scholar) و سایمون کورنبلیت به آن پیوستند. سایمون توسعهدهنده نابغهای بود که بعدها مقالاتی در مورد AI با جفری هینتون نوشت و در Anthropic کار کرد.
نقطه عطف فنی در تابستان ۲۰۰۴ با انتشار نسخه بتای فایرفاکس (Firefox) رخ داد. برخلاف مرورگر اصلی موزیلا که کند و حجیم شده بود، فایرفاکس سریع و سبک بود. مهمتر از آن، فایرفاکس از XUL (زبان رابط کاربری XML) پشتیبانی میکرد. تیم متوجه شد که با XUL میتواند مرورگر وب را به هر شکلی که میخواهد شخصیسازی و گسترش دهد.
در ۹ نوامبر ۲۰۰۴، روز انتشار فایرفاکس، تیم شروع به کلنجار رفتن با کدها کرد. آن شب، ایمیلی با موضوع «Firefox + XUL + AWS = OpenScribe/Online Scribe?» برای گروه ارسال شد. در اینجا «AWS» نه به خدمات ابری آمازون، بلکه به API خاصی اشاره داشت که آمازون برای بازیابی اطلاعات کتابها ارائه میداد. جاش گرینبرگ با هیجان پاسخ داد و اشاره کرد که رپرهای XPCOM برای mySQL میتواند به آنها اجازه دهد Scribe را با استفاده از یک پایگاهداده رابطهای بازسازی کنند و سازگاری فوری بین پلتفرمها را تضمین کنند. او پیشنهاد داد که آنها میتوانند یا از یک پایگاهداده استفاده کنند یا از رابط فایرفاکس برای پیمایش مستقیم دادههای XML اسکرایب.
این مسیر منجر به ارائه یک درخواست گرنت به مؤسسه خدمات موزهها و کتابخانهها (IMLS) برای پروژهای به نام «SmartFox: مرورگر پژوهشگر برای مجموعههای دیجیتال» شد. در این پیشنهاد استدلال شد که در حالی که میلیونها دلار برای دیجیتالی کردن مجموعهها هزینه شده، مرورگر همچنان یک «پنجره غیرفعال» باقی مانده است. SmartFox قصد داشت از دو جهت «هوشمندتر» باشد:
۱. سنجش هوشمند: مرورگر تشخیص میداد چه زمانی کاربر در حال مشاهده یک کتابخانه دیجیتال یا شیء موزهای است و بهطور خودکار نام سازنده، عنوان، تاریخ و اطلاعات کپیرایت را ثبت میکرد.
۲. سازماندهی: ابزار این اطلاعات و نسخههای کامل صفحات وب را ذخیره و سازماندهی میکرد و به کاربران اجازه میداد مجموعههای خود را در داخل خود مرورگر مرتب، حاشیهنویسی و جستجو کنند.
از اسمارتفاکس تا زوتیرو
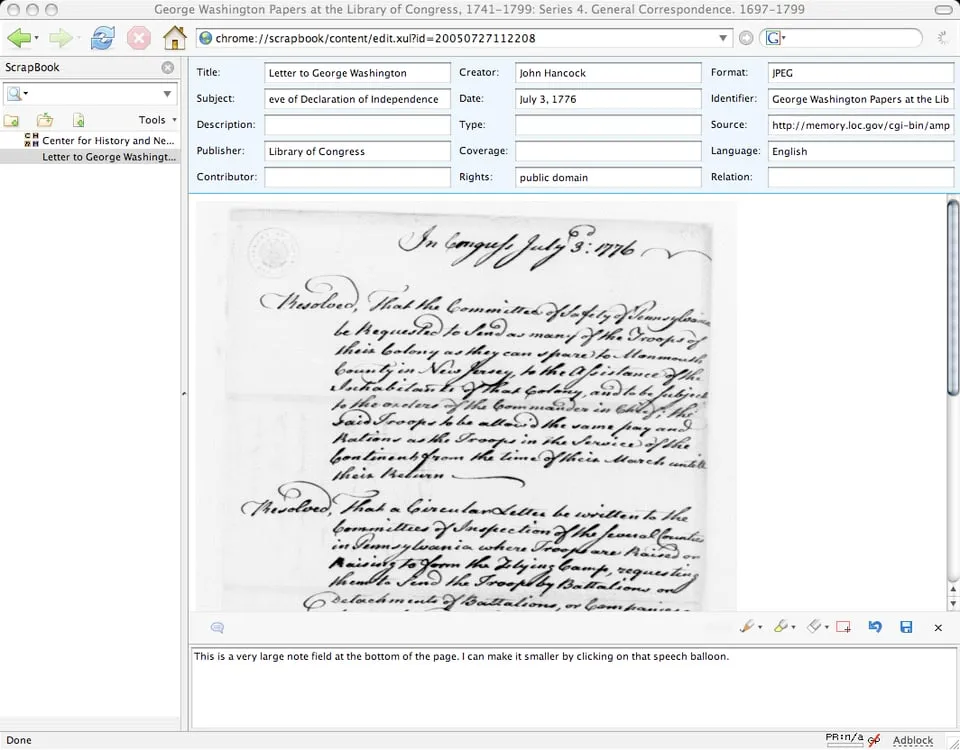
توسعه در سالهای ۲۰۰۵ و ۲۰۰۶ شتاب گرفت. در ۲۷ ژوئیه ۲۰۰۵، سایمون کورنبلیت و دیوید نورتون نسخه ۰.۰.۱ را تولید کردند که دارای یک پنل متادیتا در بالا، یک فیلد یادداشت در پایین و پوشههایی در سمت چپ بود. سایمون همچنین اشاره کرد که موزیلا قصد دارد «mozStorage» را اضافه کند، که در نهایت به فایرفاکس اجازه داد از SQLite به عنوان پایگاهداده متنباز بومی خود استفاده کند.
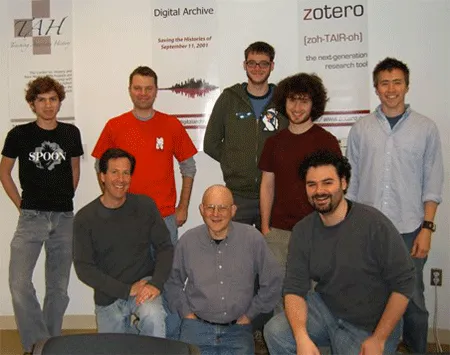
در ژانویه ۲۰۰۶، دن استیلمان به تیم اضافه شد. او برای مدیریت سرورهای مرکز استخدام شده بود و مهارت خود را با رفع مشکلات متعدد انباشته شده ثابت کرده بود. دن تا به امروز توسعهدهنده ارشد است. تیم همچنین گسترش یافت و افرادی چون شان تاکاتس (دکتری تاریخ فرانسه)، کاری کراس (تبشیر تکنولوژی و اکنون استاد دانشگاه مریلند) و ترور اوونز (هماهنگکننده ارتباطات و اکنون مدیر پژوهشی مؤسسه فیزیک آمریکا) به آن پیوستند.
تا ژوئن ۲۰۰۶، توسعهدهندگان یک طراحی منسجم با عملکردهای بسیار بهبودیافته تولید کرده بودند. با این حال، آنها با یک بحران برندینگ مواجه شدند. آنها در سپتامبر ۲۰۰۵ نام «SmartFox» را به «Firefox Scholar» تغییر داده بودند، اما یک وکیل هشدار داد که هر برندی که حاوی کلمه «Firefox» باشد، مشکلاتی خواهد داشت. آنها همچنین نگران بودند که کلمه «Scholar» (پژوهشگر) بیش از حد محدود باشد.
آنها نامهای متعددی را طوفانفکری کردند، از جمله:
- iScholar (با الهام از iPod)
- Scholr (با الهام از Flickr)
- Citopia, FreeCite, و CiteHound
- DynoCite, FireScribe, FireHoard, MetaFox, و ClioFox
- هر نوع بازی با کلمات ممکن که شامل آتش، روباه و پاورقی میشد
بسیاری از این نامها قبلاً به عنوان دامنه ثبت شده بودند. به پیشنهاد میلز کلی، تاریخنگار اروپای شرقی، تیم به یک لغتنامه آلبانیایی مراجعه کرد. آنها کلمه «zotero» را انتخاب کردند که به معنای «خوب یاد گرفتن یا استاد شدن» است. این نام بهیادماندنی بود، در بسیاری از زبانها راحت تلفظ میشد و دامنههای .org، .com و .net آن آزاد بود.
در ۲۹ اوت ۲۰۰۶، یک لوگوتایپ با استفاده از فونت Eurostile طراحی شد. سازنده آن اشاره کرد که احتمالاً از Zpizza، یک رستوران محلی در سیلور اسپرینگ مریلند، الهام گرفته شده است، هرچند Zpizza از Futura Bold استفاده میکرد. این لوگوتایپ برای دو دهه باقی مانده است.
مقیاسپذیری و ماندگاری
وقتی نسخه بتا در ۵ اکتبر ۲۰۰۶ منتشر شد، پاسخ فوری بود. این ابزار در ماه اول ۶۰ هزار کاربر جذب کرد. تامین مالیهای بعدی از سوی بنیاد ملون و بنیاد آلفرد پی اسلون اجازه داد تا نرمافزار تکامل یابد، همگامسازی مجموعهها بین تیمهای پژوهشی را ممکن سازد و در نهایت اجازه دهد اپلیکیشن با مرورگرهایی غیر از فایرفاکس نیز کار کند.
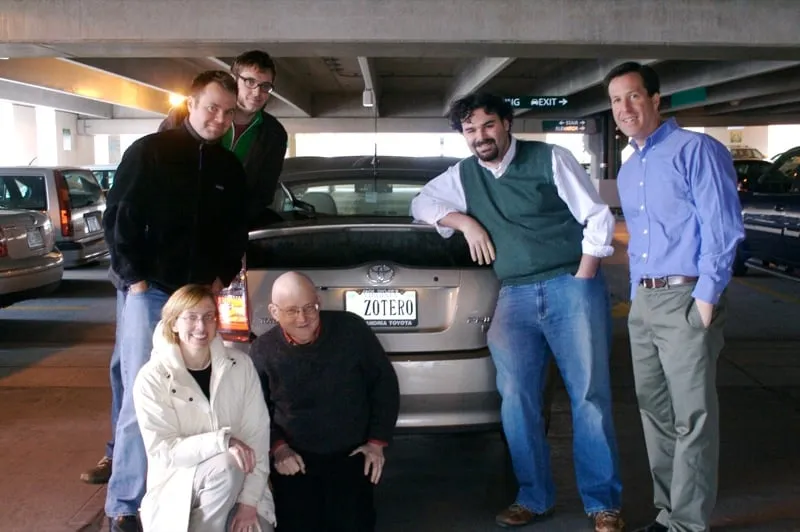
تاریخ زوتیرو همچنین با میراث روی روزنزویگ، بنیانگذار آیندهنگر مرکز و پیشگام تاریخ دیجیتال، گره خورده است. روی در سال ۲۰۰۷ در سن ۵۷ سالگی درگذشت. عکسی از اواخر سال ۲۰۰۶ او را نشان میدهد که در حالی که چند ماه است شیمیدرمانی میکند، در کنار تیم زانو زده و با افتخار یک پلاک زوتیرو را روی ماشین پریوس خود به نمایش میگذارد.
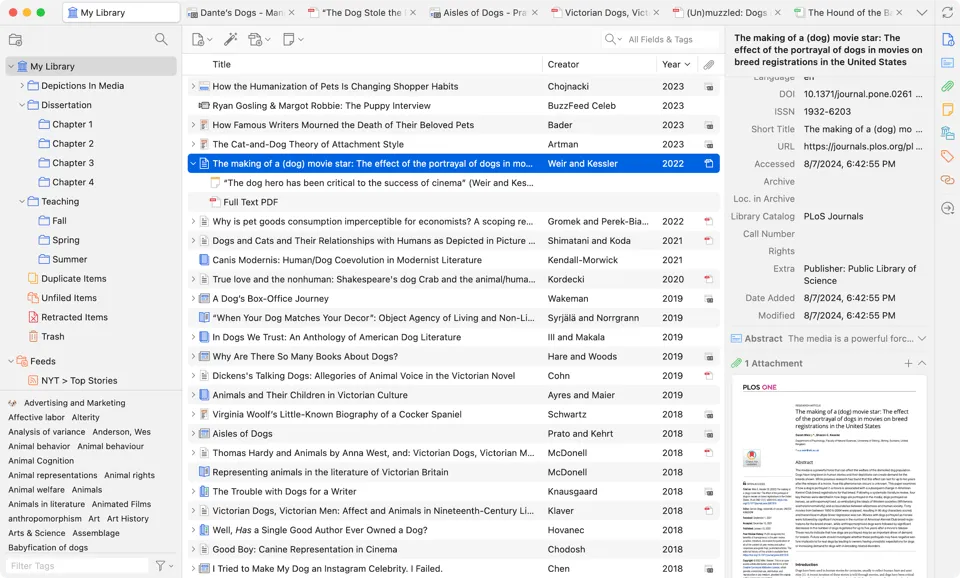
امروز زوتیرو در تار و پود آکادمیک جهانی ادغام شده است و کتابخانههای پژوهشی کارگاههایی را برای آموزش استفاده از آن برگزار میکنند. آخرین نسخه، زوتیرو ۱۰.۰، که در ۱۷ اوت ۲۰۲۶ منتشر شد، همچنان بر اساس نیازهای پایگاه کاربران عظیم خود در حال تکامل است.
تحلیل: هزینه نرمافزارهای آنی
مسیر زوتیرو نشاندهنده شکافی رو به رشد بین نرمافزارهای «گذرا» و «ماندگار» است. کدهای تولید شده توسط AI برای حل مسائل شناخته شده با مشخصات دقیق عالی هستند. اما زوتیرو از دل یک مسئله ناشناخته متولد شد که برای تعریف شدن، نیازمند تفکر جمعی و «زمانهای تلف شده» بود. این ابزار نتیجه تاریخدانانی بود که کدنویسی را به عنوان یک مهارت ثانویه میدانستند و ساعتها را به گپ زدن دور یک میز بزرگ میگذراندند.
برای توسعهدهندگان یا رهبران کسبوکار مدرن، درس این است که ارزشمندترین ابزارها اغلب از فرآیند کند اکتشاف بیرون میآیند. وقتی هدف ایجاد زیربنایی است که ۲۰ سال دوام بیاورد، سرعت سنجیده همکاریهای انسانی، استحکامی ساختاری ایجاد میکند که یک «ماراتن شبانهروزی با باتهای جادویی» هرگز نمیتواند بازسازی کند. این رویکرد در تضاد با معماریهای لایهای و استکهای توسعه AI در سال ۲۰۲۶ است که بر بهینهسازی سرعت و مقیاسپذیری مدلها تمرکز دارند.
ببینید که چگونه جامعه متنباز، مدلهای زبانی بزرگ (LLM) را در چارچوب بادوام موجود زوتیرو ادغام میکند، بدون اینکه استانداردهای سختگیرانه متادیتایی را که باعث موفقیت آن شد، فدا کند.


گفتگو