تصور کنید میخواهید به کودکی درک جهان را بیاموزید؛ تفاوت بین دادن چند کتاب محدود و دسترسی به تمام فیلمهای تاریخ سینما، دقیقاً همان جهشی است که اکنون در آموزش هوش مصنوعی رخ داده است. ۱۰ میلیون ساعت محتوای ویدیویی، مقیاس خیرهکنندهٔ مجموعه دادهٔ BVD (Big Video Dataset) است که اکنون به عنوان یک استاندارد برای یادگیری ارتباط میان صدا و تصویر در دسترس جامعهٔ پژوهشی قرار گرفته است.
به نقل از گزارش ۲۹ اوت ۲۰۲۶ وبسایت the-decoder.com، هدف این پروژه دموکراتیزه کردن دسترسی به دادههایی است که پیش از این تنها در پشت درهای بستهٔ آزمایشگاههای غولهای فناوری محصور بود. آموزش مدلهای ویدیویی باکیفیت به حجم عظیمی از دادههای جفتشده نیاز دارد و اکثر مدلهای پیشرو فعلاً بر دادههای اختصاصی متکی هستند که پژوهشگران مستقل را در موضع ضعف قرار میدهد.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت و دسترسی به مدلهای بازمتن اشاره کردیم، دسترسی به دادههای آموزشی، کلید اصلی رقابت در دنیای مدلهای بنیادی است. این رویکرد بازگشایی دادهها مشابه اقداماتی است که در حوزههای نظامی دیده شده است، جایی که اوکراین ۵ میلیون تصویر جنگی را برای آموزش سلاحهای خودکار بریتانیا در اختیار قرار داد تا دقت سیستمهای شناسایی را افزایش دهد. LAION برای ساخت این مجموعه، ۱.۳ میلیارد لینک ویدیویی را از CommonCrawl فیلتر کرده است. طبق مستندات این پروژه، بستهٔ نهایی BVD شامل موارد زیر است:
- ۸۰ میلیون ویدیوی دانلودشده به مجموع ۱۰ میلیون ساعت.
- ۵۵ میلیون کلیپ همراه با شرحهای متنی و صوتی تولیدشده توسط هوش مصنوعی.
- ۳۰۰ میلیون تصویر ثابت استخراجشده از این ویدیوها.
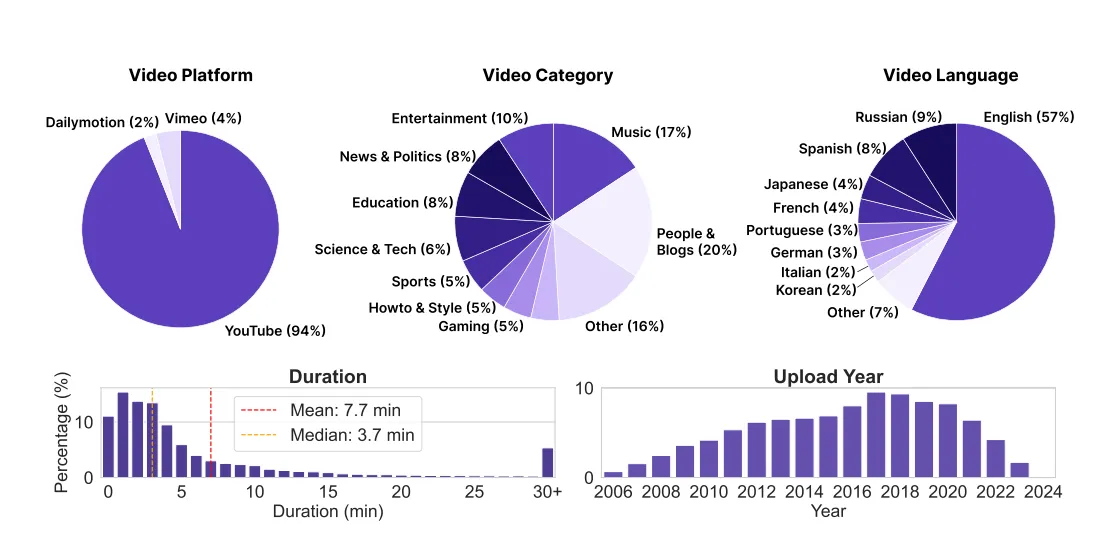
بیشتر این محتوا از یوتیوب استخراج شده و عمدتاً به زبان انگلیسی است. در تستهای رودررو، مدلهایی که با BVD آموزش دیدهاند، در محک (Benchmark) تبدیل ویدیو به متن، تا ۲.۱ درصد بهتر از مدلهای آموزشدیده با InternVid عمل کردهاند. این یعنی مدلهای چندوجهی (Multimodal) — شبیه به انسانی که همزمان با چشم میبیند و با گوش میشنود تا دنیا را بفهمد — اکنون میتوانند بستر وسیعتری برای درک زمینهٔ زمانی داشته باشند. این پیشرفت در درک بصری، یادآور دستاوردهای اخیر در حوزه رباتیک است که در آن مدل Dyna-2 با بهرهگیری از ۱ میلیون ساعت ویدیو توانست قوانین مقیاسپذیری یادگیری رباتها را بازنویسی کند.
این انتشار، توازن قدرت در هوش مصنوعی را تغییر میدهد. با پیوند دادن ویدیو، صدا و متن در یک قالب باز، آزمایشگاههای کوچکتر هم میتوانند مدلهایی بسازند که واقعاً مفهوم زمان و حرکت را میفهمند. برای کاربر نهایی، این به معنای آن است که نسل بعدی تولیدکنندههای ویدیوی متنباز، فاصله خود را با غولهای تجاری بهسرعت کم خواهند کرد.
از نظر قانونی، LAION بر اساس حکم دادگاه منطقهای هامبورگ در سال ۲۰۲۴ عمل میکند که جمعآوری محتوای دارای کپیرایت را برای پژوهشهای غیرتجاری مجاز دانسته است. اکنون پژوهشگران میتوانند به دادهها و کدها دسترسی رایگان داشته باشند، به شرطی که حقوق سازندگان اصلی را رعایت کنند.
گام بعدی شما
- اگر توسعهدهنده هستید، مستندات BVD را برای بهبود قابلیتهای بینایی-زبانی مدلهای خود بررسی کنید.
- تغییرات در دقت مدلهای متنباز در برابر Sora و Runway را در ماههای آینده زیر نظر بگیرید.
- بررسی کنید که آیا مدلهای فعلی شما در درک «زمینه زمانی» ویدیوها دچار توهم میشوند یا خیر.
اما داستان سختافزاری لازم برای پردازش این حجم از داده حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو