تصور کنید یک جادهی سریعسیر طراحی شده تا هزاران خودرو با سرعت عبور کنند، اما ناگهان هزاران نفر تصمیم بگیرند پیاده وسط جاده بایستند و تکتک سنگریزهها را بشمارند. این دقیقاً همان اتفاقی است که اکنون در زیرساختهای git.kernel.org رخ میدهد و باعث شده تقریباً ۲۰٪ از کل توان پردازشی CPU در پنج گره توزیعشدهی این سامانه، صرف رندر کردن تغییرات (Commits) برای رباتهای جمعآوری دادهی هوش مصنوعی شود.
طبق گزارشی که در ۲۹ اوت ۲۰۲۶ در people.kernel.org منتشر شد، این فشار مداوم — که شبیه به یک «تشعشع پسزمینه» از بار سیستمی است — منابعی را میبلعد که باید در خدمت توسعهدهندگان انسانی باشد. در واقع، این سامانه اکنون برای رندر کردن تغییرات برای رباتها، بیشتر از تمام دسترسیهای قانونی دیگر، از جمله کلون کردن مخازن (Git Clones)، پردازش انجام میدهد.
این هجوم ترافیکی در حالی رخ میدهد که توسعهدهندگان مدلهای زبانی بزرگ (LLM) به شدت تشنهی دادههای «خالص» هستند. آموزش یک مدل روی خروجیهای خودش میتواند منجر به نوعی بیماری دیجیتالی شبیه به «پریون» شود که در آن مدل به مرور زمان تخریب میشود. از آنجا که تاریخچه هسته لینوکس تضمینشده است که پیش از عصر AI و توسط انسانها نوشته شده، به معدنی طلایی برای آزمایشگاههای AI تبدیل شده است تا کدهای باکیفیت و آرشیوهای بحثهای انسانی را استخراج کنند. توسعه لینوکس در فضای باز اتفاق میافتد، از مخازن git گرفته تا آرشیوهای بحثهای لحظهای، و همین موضوع فیلتر کردن محتوای دستنخورده را برای مدلها آسان میکند. این تلاش برای استخراج دادههای انسانی، در حالی است که خودِ جامعهی لینوکس برای حفظ کیفیت کد، الزامات سختگیرانهای را برای برچسبگذاری کدهای تولید شده توسط هوش مصنوعی وضع کرده است.
ناکارآمدی جمعآوری دادههای مدرن
تیم هسته لینوکس به یک تناقض عجیب اشاره میکند: در حالی که هوش مصنوعی به عنوان سیستمی «باهوش» بازاریابی میشود، رباتهایی که دادهها را استخراج میکنند از ناکارآمدترین روش ممکن استفاده میکنند. بهجای استفاده از دستور سادهی git clone برای دانلود کل تاریخچه در محیط محلی، این رباتها هر تغییر را به صورت یک صفحه HTML رندر کرده و سپس متن را تجزیه (Parse) میکنند. تیم تأکید میکند که همه چیز بهگونهای طراحی شده که قابل کلون باشد — از جمله تمام محتویات LKML (لیست پستی هسته لینوکس) — دقیقاً به این دلیل که دادهها با یک دستور واحد حفظ و در دسترس باشند.
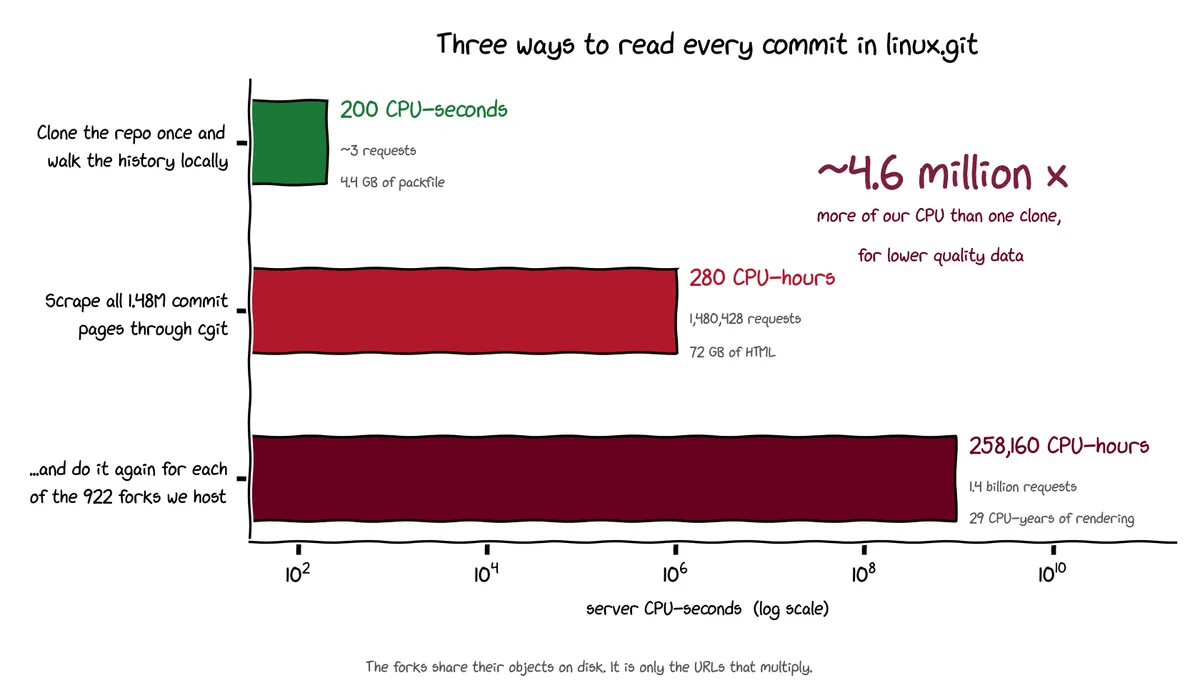
این رویکرد باعث ایجاد یک ضربکنندهی عظیم از درخواستهای غیرضروری میشود. مخزن linux.git حدود ۱.۴۸ میلیون تغییر دارد. اما چون ۹۲۲ فورک (Fork) از این پروژه در سایت وجود دارد، رباتها عملاً میلیاردها URL معتبر را هدف قرار میدهند تا همان ۱.۴۸ میلیون تغییر را ۹۲۲ بار تکرار کنند.
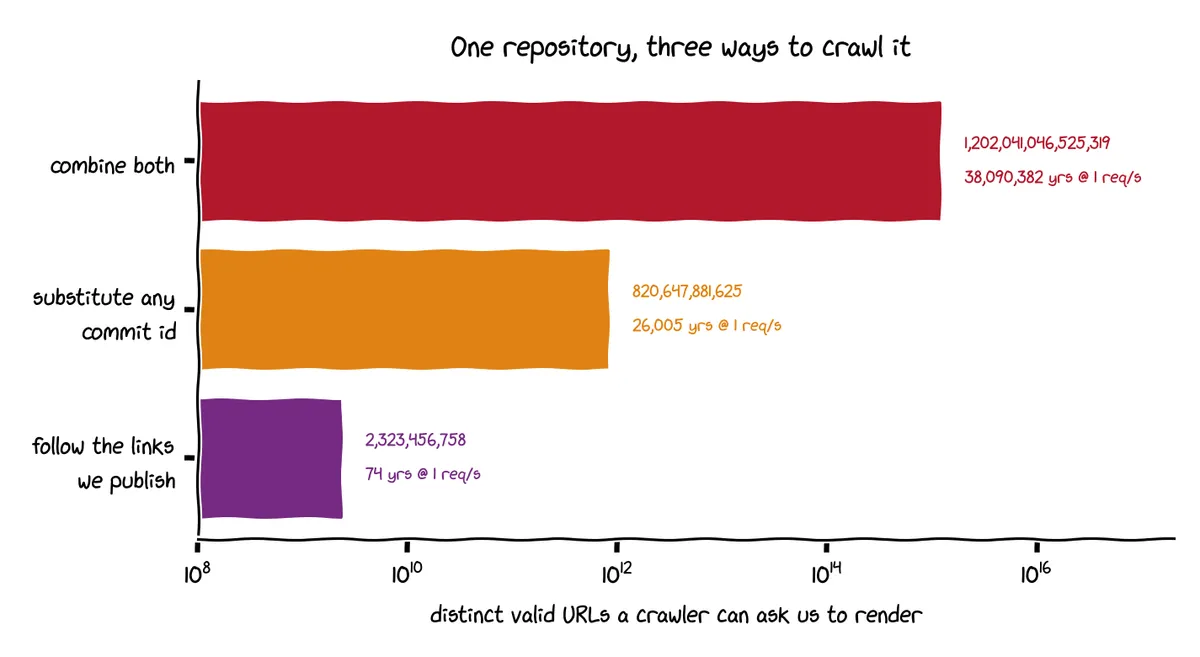
علاوه بر تغییرات ساده، نرمافزار cgit امکان تولید نماهای مختلفی را فراهم میکند:
- پچها (Patches)
- رندرهای ساده (Plain renders)
- تفاوتها (Diffs) بین تغییرات دلخواه
این انعطافپذیری که برای انسانها و خزندههایی که از قوانین robots.txt پیروی میکردند طراحی شده بود، اکنون به رباتها اجازه میدهد تعداد «بیشماری» (Metric Bajillion) URL معتبر برای هر فورک بسازند و فشار روی بکاِند را به شدت افزایش دهند.
تکامل جنگ رباتها
در ابتدا، تیم لینوکس سعی کرد با ابزارهایی مثل fail2ban جلوی این رباتها را بگیرد. این روش تا زمانی جواب داد که رباتها خود را از طریق User-Agent معرفی میکردند، اما آنها سریعاً تکامل یافتند تا خود را شبیه مرورگرهای معمولی (Vanilla Browsers) کنند.
وقتی تیم به مسدود کردن IPها روی آورد، رباتها شروع به پخش شدن در کل زیرشبکهها کردند. برای تیم توسعه obvious شد که هر IP ای که سعی دارد تمام تغییرات یک فورک رهاشدهی ۸ ساله را بردارد، قطعاً یک کاربر تک و تنها با مرورگر کروم روی ویندوز نیست. مسدود کردن کل شمارههای سیستم خودمختار (ASN)، بهویژه برای IPهای Google Compute، راهکاری موقت بود، هرچند گاهی باعث مسدود شدن ابزارهای قانونی بررسی لینک میشد.
اوضاع زمانی «زشت» شد که خزندهها از IPهای خانگی و موبایل استفاده کردند. اکنون رباتها از طریق «تجاریسازی SDKهای پروکسی»، درخواستها را از طریق میلیونها دستگاه خانگی، حتی تلویزیونهای هوشمند، هدایت میکنند. یک IP ممکن است فقط ۴ یا ۵ درخواست بفرستد و دیگر هرگز در لاگها ظاهر نشود. این وضعیت شبیه به «هجوم ملخها» است: آنها با شدت و سرعت حمله میکنند تا سیستم سقوط کند، سپس به هدف دیگری میروند و پس از بهبودی سیستم، دوباره بازمیگردند.
دفاع Anubis
حدود یک سال پیش، تیم لینوکس سامانه Anubis را پیاده کرد. این سیستم رباتها را مجبور میکند پیش از دسترسی، یک مسئله محاسباتی — حل یک مجموع SHA256 با صفرهای پیشرو — را حل کنند. این «ریاضیات یکبارمصرف» نیازمند محاسبه رشتهای است که در ترکیب با IP کاربر و یک رمز ارائه شده توسط سرور، یک هش خاص تولید کند.
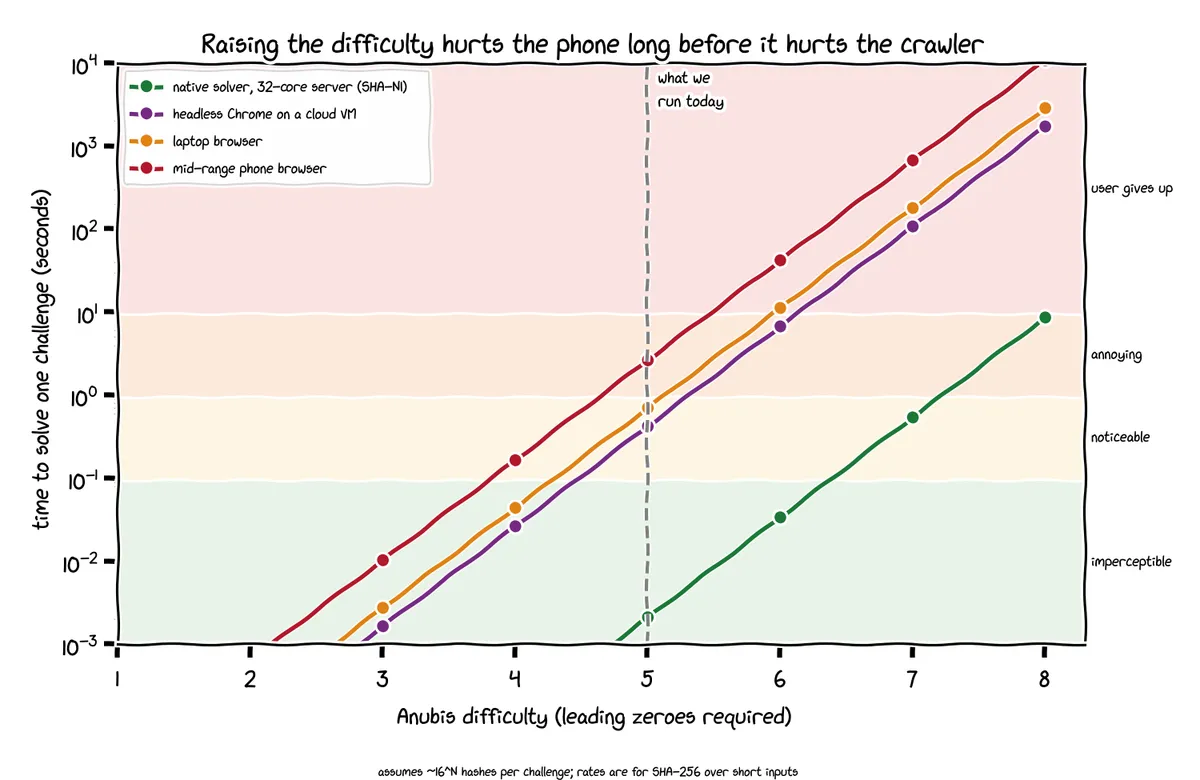
در ابتدا این دفاع یک موفقیت کامل بود. رباتها تسلیم شدند و به سراغ اهداف آسانتر رفتند. برای چند ماه، استقرار Anubis آسان بود و کاربران نیز مزاحمت اندک آن را تحمل کردند. اما در نهایت رباتها سازگار شدند. وقتی تیم سطح دشواری را از ۴ به ۵ افزایش داد، رباتها صرفاً شروع به حل پازلهای سختتر کردند.
سطح ۵ به طور قابل توجهی سنگینتر است؛ حل آن روی یک دستگاه موبایل چند ثانیه زمان میبرد و اغلب باعث گرم شدن دستگاه در حین محاسبات عددی میشود. با این حال، رباتها همچنان به حل آن ادامه دادند.
معیارهای فعلی ترافیک
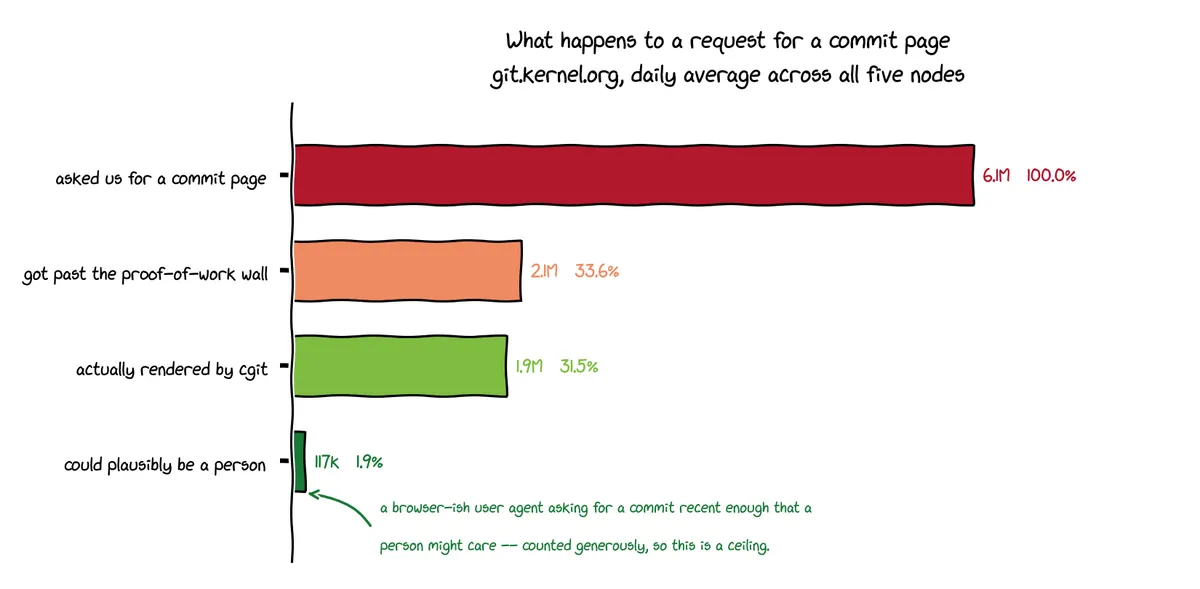
امروز git.kernel.org روزانه حدود ۶ میلیون درخواست برای تغییرات تصادفی دریافت میکند. توزیع این ترافیک تکاندهنده است:
- ۶۶٪ بلافاصله توسط چالش Anubis مسدود میشوند.
- ۳۳٪ ریاضیات را حل کرده و با موفقیت به سایت میرسند.
- حدود ۲٪ تخمین زده میشود که درخواستهای انسانی قانونی باشند.
این نشان میدهد دادههای لینوکس برای آموزشدهندگان AI چنان ارزشمند است که آنها حاضرند مقدار عظیمی از توان پردازشی را صرف دور زدن Anubis کنند.
هزینه آموزش
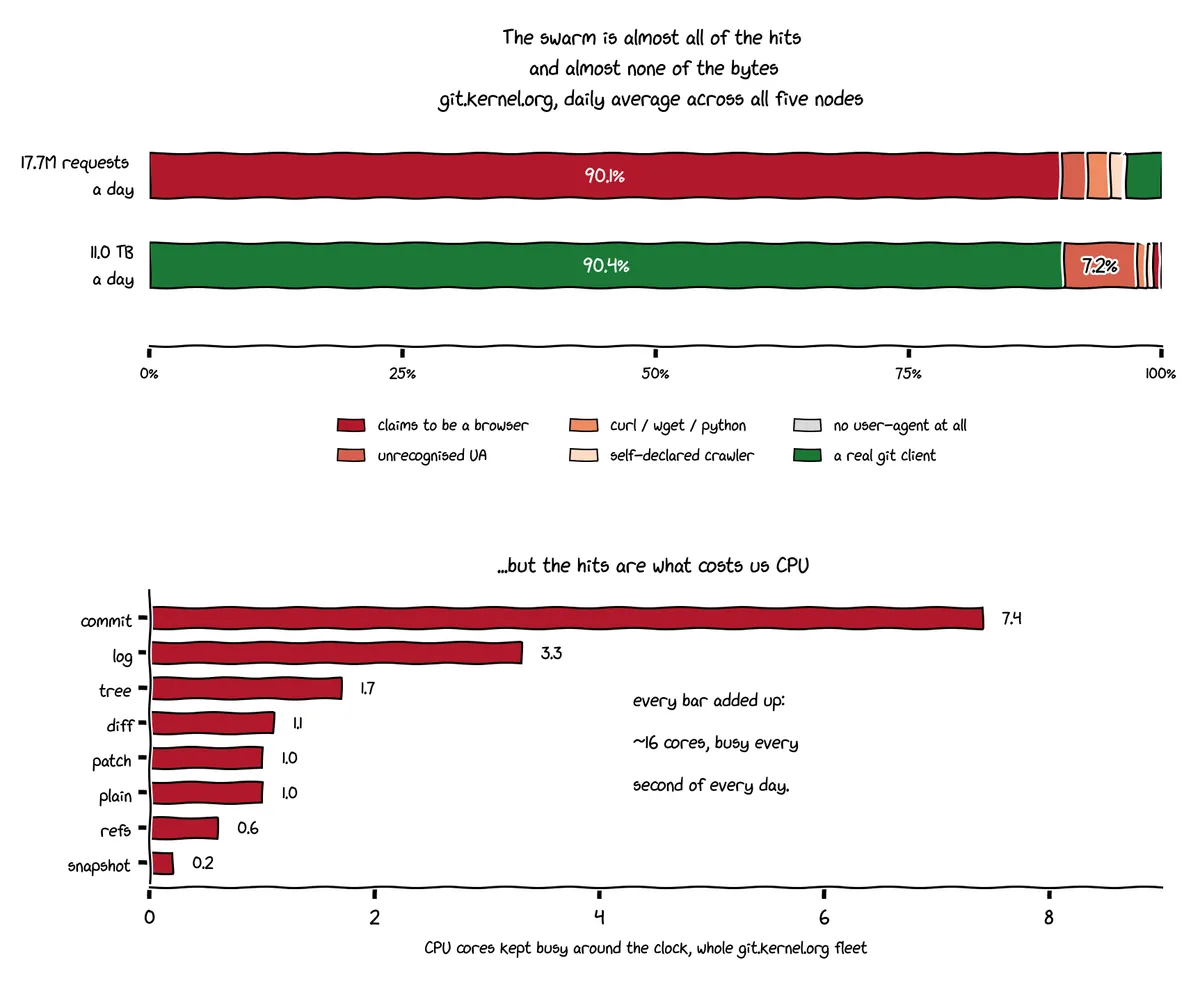
از مجموع ۹۰ هسته CPU در شبکه توزیعشده، ۱۴ تا ۱۶ هسته بهطور دائمی وقف رندر کردن HTML برای رباتها شده است. اگرچه سایت برای انسانها پاسخگو است، اما این اتلاف منابع چشمگیر است. تنها اتفاقاتی که واقعاً سیستم را متوقف میکنند، سیستمهای CI بدطراحیشدهای هستند که همزمان از ۲۰ گره مختلف، کلونهای کمعمق (Shallow Clones) از stable.git میگیرند. تیم لینوکس اشاره میکند که کلونهای کمعمق «افتضاح» هستند و توصیه میکند کاربران بهجای این کار، آینههای (Mirrors) شخصی خود را راهاندازی کنند.
تحلیل: بحران گرسنگی دادهها
این درگیری نشاندهنده تنش فزاینده بین اخلاق متنباز (Open-source Ethos) و مقیاس صنعتی آموزش AI است. تیم هسته لینوکس در واقع در حال پرداخت هزینه تحقیق و توسعه شرکتهای چند میلیارد دلاری AI با سختافزار و برق خود است.
برای خواننده، این سیگنالی است از تغییر در نحوه دسترسی به دادههای باز. «وب باز» در حال تبدیل شدن به میدان نبردی از هزینههای محاسباتی است. وقتی هزینه ارائه دادهها از مزیت باز بودن آن پیشی بگیرد، نگهداران مخازن ناگزیر به محدود کردن دسترسی خواهند شد؛ به این معنی که عصر دسترسی ناشناس و بدون اصطکاک به آرشیوهای عمومی در حال پایان است.
برای مقابله با این وضعیت، تیم لینوکس اکنون در حال غیرفعال کردن ویژگیهای خاصی است تا تعداد URLهای قابل خزیدن را کاهش دهد و دسترسی به عملیاتهای هزینهبر را محدود کند. کاربرانی که به صورت ناشناس به منابع دسترسی دارند باید انتظار کاهش عملکرد را داشته باشند. اگرچه تیم قول داده است که همچنان تمام دادهها را برای هر کسی که درخواست کند جهت دانلود ارائه دهد، اما کاربران ممکن است برای دریافت آن مجبور به طی کردن مراحل دشوارتری شوند.
منتظر باشید تا سایر مخازن بزرگ متنباز نیز «مالیاتهای محاسباتی» مشابه یا احراز هویت اجباری را برای محافظت از زیرساختهای خود در برابر تب طلای دادههای AI پیاده کنند.
گام بعدی شما
- اگر از مخازن بزرگ برای آموزش مدل استفاده میکنید، بهجای رندر وب، از پروتکلهای استاندارد Git استفاده کنید تا از مسدود شدن IP خود جلوگیری کنید.
- توسعهدهندگان ابزارهای جمعآوری داده باید به سمت مدلهای «احترام به زیرساخت» حرکت کنند تا از ایجاد سدهای محاسباتی سختتر جلوگیری شود.
- برای دسترسی به آرشیوهای حجیم، از Mirrorهای رسمی استفاده کنید تا فشار روی گنه های اصلی کاهش یابد.
اما داستان سختافزاری این نبرد حتی شگفتانگیزتر است؛ برای درک اینکه چگونه تراشههای جدید با این حجم از درخواستها مقابله میکنند، به تحلیل ما دربارهی معماری Blackwell مراجعه کنید.



گفتگو