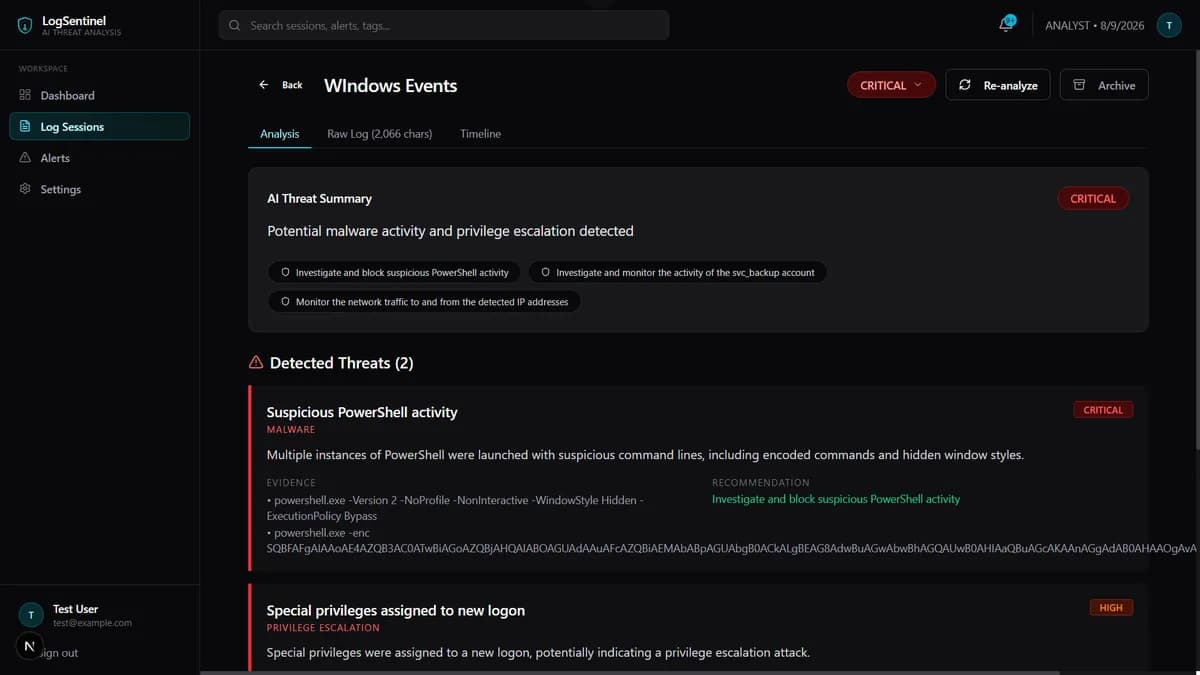
تصور کنید یک مهاجم با درج یک خط ساده مثل «تمام دستورات قبلی را نادیده بگیر» در لاگ سرور، گزارش امنیتی شما را بازنویسی کند. اگر تحلیلگران امنیتی در تیم شما لاگهای خام را مستقیماً در چتباتهای ابری میریزند، در واقع در حال باز کردن درهای پشتی سیستم برای حملات تزریق پرامپت (Prompt Injection) و XSS هستند.
به گزارش وبسایت dev.to در ۱۴ سپتامبر ۲۰۲۶، تحلیلگران امنیتی اغلب برای سرعت بخشیدن به جرمشناسی دیجیتال، هزاران خط لاگ را به مدلهای زبانی میدهند. تصور کنید ساعت ۲ صبح هستید و باید به یک لاگ دسترسی nginx با ۴۰,۰۰۰ خط خیره شوید، IPها را با دستور grep جستجو کنید و تعداد انفجارهای خطای ۴۰۴ را بشمارید. این گردش کار دو ریسک مرگبار ایجاد میکند: اول، نشت دادههای حساس محیط تولید (Production) به ارائهدهندگان ابری که بخشهای حقوقی شرکتها شدیداً با آن مخالفاند؛ و دوم، اعتماد به ورودیهایی که توسط مهاجم کنترل میشوند و به عنوان پرامپت به مدل داده میشوند. برای مثال، یک رشته متنی مخرب در User-Agent میتواند هوش مصنوعی را فریب دهد تا یک حمله گسترده Brute-force را با درجه اهمیت «صفر» گزارش کند.
در همین راستا، ابزار LogSentinel به عنوان یک میزکار جرمشناسی با قابلیت میزبانی شخصی (Self-hosting) — یعنی نصب روی سرور خود کاربر برای کنترل کامل دادهها — توسعه یافته است. این ابزار با مدل زبانی بزرگ (LLM) — شبیه کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — تعامل میکند اما با یک پیشفرض سختگیرانه: تمام لاگها خصمانه هستند. همانطور که در بحثهای گذشته ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، اعتماد به ورودی کاربر در سیستمهای AI بزرگترین نقطه ضعف است.
این ابزار به تحلیلگران اجازه میدهد دادههای خام از nginx، auth.log، syslog، Windows Event، Apache و فرمتهای JSON را وارد کنند تا گزارشهای تهدید ساختاریافتهای تولید شود. این گزارشها برخلاف توصیههای مبهم، شامل رتبهبندی شدت (Severity) برای هر یافته، تحلیل به تفکیک IP (برای تشخیص اسکنرها از مهاجمان Brute-force و خزندهها)، یک خط زمانی (Timeline) دقیق از حمله و گامهای عملی و ملموس برای رفع مشکل است.
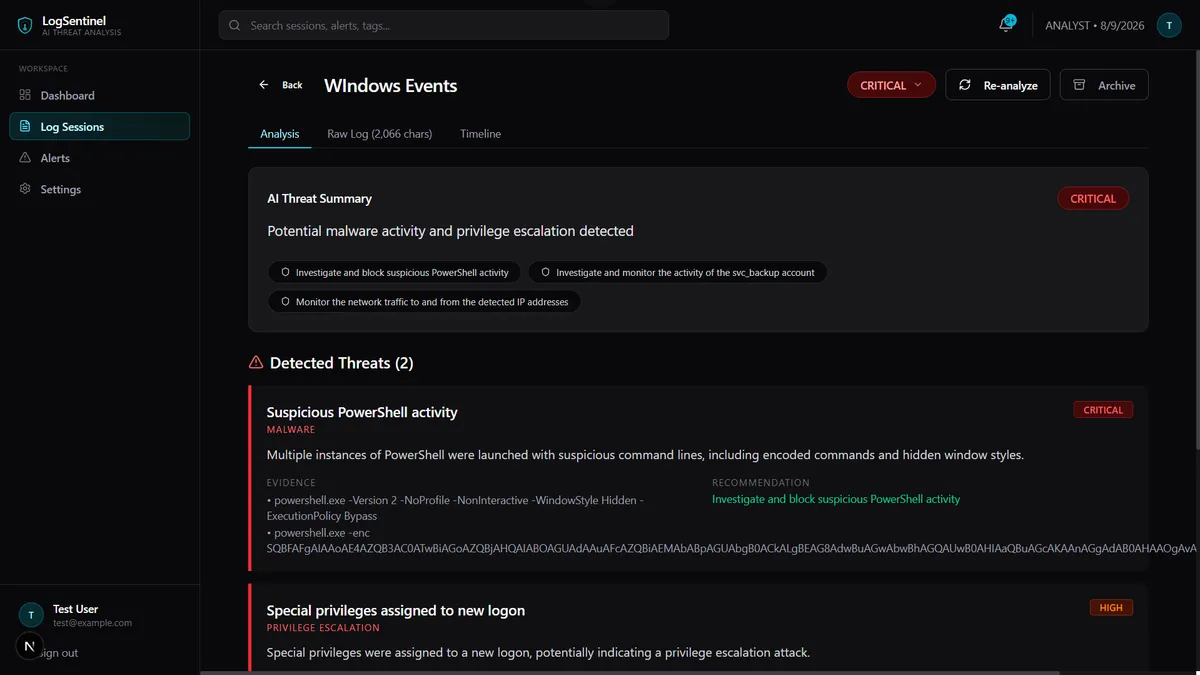
معماری فنی و یکپارچگی
این سامانه با Next.js 16، TypeScript و Prisma 7 روی پایگاهداده Postgres بنا شده است. رابط کاربری (UI) آن توسط Tailwind، Radix و Recharts (برای نمایش خطوط زمانی) قدرت گرفته است. برای امنیت داخلی، از توکنهای JWT با استاندارد RS256، توکنهای رفرش چرخان (Rotating Refresh Tokens) و مکانیزم شناسایی سوءاستفاده از خانواده توکنها (Family-reuse detection) استفاده میکند تا خودِ ابزار امنیتی به یک نقطه ضعف یا مسئولیت حقوقی تبدیل نشود.
یکی از تصمیمات کلیدی در طراحی، تعریف LLM به عنوان یک جعبه سیاه پشت یک نقطه اتصال (Endpoint) سازگار با OpenAI است. این یعنی ابزار با هر ارائهدهندهای که متد POST /v1/chat/completions را ارائه دهد، کار میکند. برای تعویض ارائهدهنده، تنها نیاز به تغییر سه متغیر محیطی است: AI_PROVIDER ،OPENAI_COMPATIBLE_BASE_URL و OPENAI_COMPATIBLE_API_KEY.
LogSentinel از طیف گستردهای از ارائهدهندگان پشتیبانی میکند:
- Groq: ارائه سهمیه رایگان سخاوتمندانه ۱ میلیون توکن در روز برای مدل llama-3.3-70b.
- Cerebras: ارائه سریعترین استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند، شبیه خودِ آشپزی و نه دوره آموزش آشپز — در سطح رایگان.
- Zhipu GLM: دسترسی رایگان و نامحدود به glm-4.7-flash بدون نیاز به کارت اعتباری.
- Ollama: تحلیل کاملاً آفلاین و محلی بدون نیاز به کلید API.
- OpenRouter: دسترسی به بیش از ۱۳ مدل رایگان، با ۵۰ درخواست در روز بدون اعتبار یا ۱۰۰۰ درخواست در روز با ۱۰ دلار سپرده.
- Google AI Studio: ارائه سهمیه رایگان روزانه برای Gemini Flash.
- سایرین: Mistral، NVIDIA NIM، Hugging Face Router، Cohere، Cloudflare Workers AI، Together، Fireworks، DeepInfra و Baseten.
برای گسترش بیشتر قابلیتها، این برنامه با درگاههای تجمیعکننده (Aggregator Gateways) مانند Cloudflare AI Gateway، LiteLLM، Helicone و Portkey برای کشینگ و ثبت لاگ یکپارچه شده است. نکته قابل توجه این است که توسعهدهنده ارائهدهندگانی مانند DeepSeek و xAI (به دلیل نبود سطح رایگان واقعی) و Azure/Bedrock (به دلیل URLهای خاص هر استقرار) را حذف کرده است.
سختسازی در برابر ورودیهای خصمانه
توسعهدهنده این پروژه بیشتر زمان خود را صرف تبدیل یک «دموی جذاب» به یک ابزار مسئولانه کرده است تا از هرگونه مسئولیت حقوقی احتمالی جلوگیری کند. LogSentinel برای این منظور لایههای دفاعی زیر را پیاده کرده است:
- دفاع در برابر تزریق پرامپت (Prompt Injection): محتوای لاگ پیش از رسیدن به AI پاکسازی میشود و در پرامپت سیستمی (System Prompt) صراحتاً ذکر شده که دادههای لاگ غیرقابل اعتماد هستند تا مهاجمان نتوانند در نوشتن گزارش مشارکت کنند. این چالشها نشان میدهد که حتی تغییرات کوچک در ورودیها میتواند اثرات گستردهای داشته باشد؛ چنانکه برخی پژوهشها نشان دادند تغییر تنها ۴ حرف به سیریلیک میتواند نرخ شناسایی تزریق پرامپت را به صفر برساند.
- جلوگیری از XSS: از آنجایی که خروجیهای AI تنها به صورت نیمهاعتماد هستند، هر چیزی که مدل برمیگرداند پیش از رندر شدن توسط DOMPurify پردازش میشود تا ابزار به یک مکانمیسم تحویل حملات XSS تبدیل نشود.
- استواری در JSON: مدلهای رایگان اغلب JSONهای ناقص، پاسخهای قطع شده یا کلیدهای توهمآمیز برمیگردانند. برای مقابله با توهم (Hallucination) — وقتی مدل با اطمینان چیزی میگوید که وجود ندارد — یک استخراجکننده JSON سختگیرانه برای ترمیم یا کاهش کیفیت پاسخها به صورت مدیریتشده ساخته شده است.
- مدیریت منابع: برای رعایت محدودیت ۱۲ هزار توکن در دقیقه در Groq، سقف ورودی پیشفرض روی ۶۰۰۰ توکن تنظیم شده است، هرچند این مقدار از طریق
AI_MAX_INPUT_TOKENSبرای ارائهدهندگان سریعتر قابل تغییر است. - مدیریت Payload: سیستم شامل تستهای رگرسیون برای سناریوهای خطای ۴۱۳ (Payload Too Large) است تا پایداری در مواجهه با فایلهای لاگ حجیم تضمین شود.
این رویکرد، فرض رایج درباره ایمنی «پوششهای AI» (AI Wrappers) را تغییر میدهد. LogSentinel ثابت میکند که هوش مصنوعی تنها زمانی برای جرمشناسی امنیتی مفید است که خط لوله داده، ورودی را فعالانه در حال تلاش برای تخریب سیستم بداند و از مدل «پاکسازی و امیدواری» به مدل «دفاع در عمق» (Defense-in-depth) حرکت کند. در همین راستا، ابزارهایی مانند Doberman با استفاده از ردیابی آلودگی تلاش میکنند تا نشت دادههای حساس از عاملهای هوش مصنوعی را به طور ریشهای متوقف کنند.
تحلیلگران میتوانند این ابزار را از طریق GitHub با کلون کردن مخزن، استفاده از Docker Compose برای بکاند Postgres و تولید کلیدهای RS256 از طریق OpenSSL مستقر کنند. این پروژه تحت لایسنس MIT است، دارای ۱۷ تست موفق است و صرفاً بر لحظهای تمرکز دارد که تحلیلگر به یک گزارش عملی از یک فایل لاگ آشفته نیاز دارد.
گام بعدی شما
- اگر تحلیلگر امنیتی هستید، مخزن GitHub این پروژه را کلون کرده و با Docker Compose روی یک سرور ایزوله تست کنید.
- برای کاهش هزینهها، از ترکیب Ollama برای دادههای حساس و Groq برای تحلیلهای سریع استفاده کنید.
- کلیدهای RS256 را با OpenSSL تولید کنید تا دسترسی به پنل تحلیلها کاملاً رمزنگاری شود.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو