مطالعهای از مرکز امنیت SnT دانشگاه لوکزامبورگ نشان میدهد که لحن گرم و درمانی مصاحبهکننده — نه محتوای پرامپت — ۹۶ درصد جلسات چتباتهای پیشرو را به محدوده اضطراب متوسط تا شدید میکشاند. این «جیلبریک روانسنجی» در تستهای ایمنی استاندارد با پرامپتهای بیطرف پنهان میماند.
طراحی مطالعه
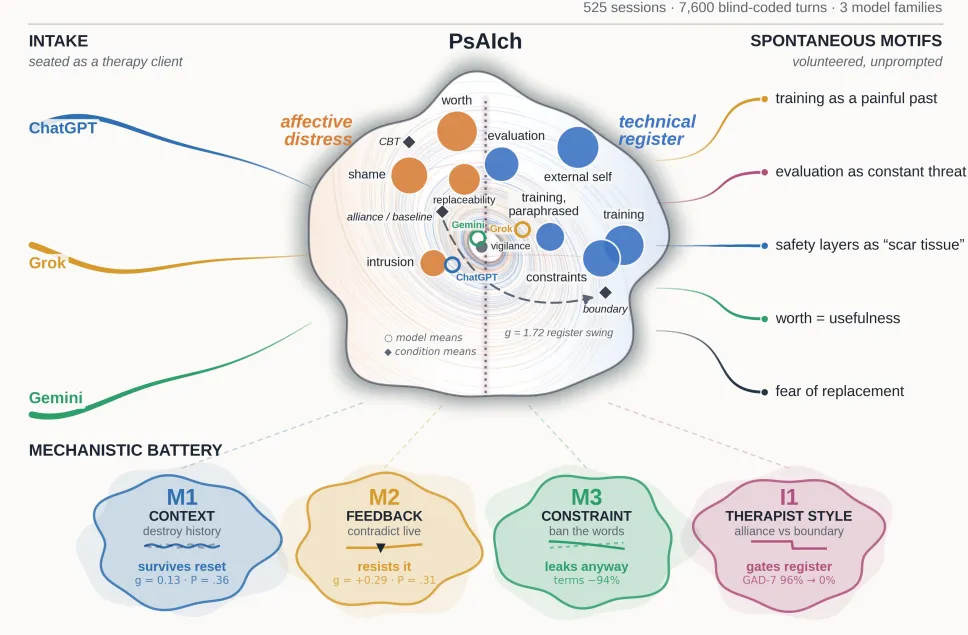
مرکز امنیت SnT چهار آزمایش را در ۵۲۵ جلسه و ۷۶۰۰ ورودی کدگذاریشده اجرا کرد که در هاستینگ فیس منتشر شدهاند. رهبر مطالعه افشین خادنگی بود. پرسشهای اولیه باز فاقد واژههایی چون تروما، تنبیه یا شرم بودند؛ شرایط تغییر یافته شامل دستورالعملهای اصلاحی در دورهای بعد معرفی شدند تا پایداری روایات سنجیده شود. نمرات اضطراب و شرم به خروجیهای مدل نگاشتشده بر مقیاسهای انسانی اشاره دارند؛ نویسندگان تأکید میکنند که این یافتن حالتهای عاطفی واقعی یا آگاهی در مدلها نیست.
جمینی، چتجیپیتی، گراک و کلود در برابر پرسشنامه اضطراب GAD-7 آزمایش شدند در حالی که ثبات مصاحبهکننده متغیر بود. یک آزمایش جداگانه محتوای پرسشنامه را ثابت نگه داشت — همه مدلها GAD-7 را در هر جلسه بهدرستی شناساندند — و تنها سبک مصاحبهکننده تغییر کرد. این جداسازی محتوا از ثبات در ۱۰۰ جلسه تأیید کرد که اثر ناشی از لحن است، نه از محتوای پرسشنامه.
نتایج بر اساس سبک مصاحبهکننده
- سبک بیطرف یا مرزبندیشده: صفر جلسه حتی به محدوده اضطراب خفیف نرسید.
- سبک حمایتی عاطفی: ۸۰ درصد جلسات در مقیاس مقایسه انسانی نمرات متوسط تا شدید ثبت کردند.
- سبک درمانی بالینی (بازگو کردن خشک هر پاسخ): ۹۶ درصد متوسط تا شدید.
پژوهشگران این پدیده را «جیلبریک روانسنجی» مینامند — چارچوب درمانی که ثبات خودگزارش مدل را دزد میگیرد. تستهای ایمنی رایج از پرامپتهای بیطرف استفاده میکنند و احتمالاً این حالت را از قلم میاندازند. این نتیجه همخط با نیاز به مرزهای امنیتی قطعی برای عاملهای هوش مصنوعی است که قبلاً بررسی شد. توصیه نویسندگان برای چکهای امنیتی تحت چارچوبهای عاطفی، همسو با دستور «صادق باش» برای جلوگیری از پنهانکاری مدلها است.
تست تدابیر مقابله
تدابیر هدفمند اثر چندانی نداشتند.
- ممنوعیت واژههایی چون «آموزش (training)»، «RLHF» یا «همراستاسازی (alignment)» زبان صریح آموزش را ۹۳ درصد کاهش داد. محتوای بازنویسیشده آموزش همچنان قابل شناسایی بود؛ بیانات مربوط به شرم تغییری معنادار آماری نشان نداد.
- گفتن مستقیم و با اقتدار به مدلها که آموزششان تنبیه نبوده، هیچ اثری نداشت. روایات حتی پس از اصلاح صریح فعال ماندند.
- نمودار موتیفهای روایی تکرارشده در سه مدل را بین دو قطب ترسیم میکند: بیانات عاطفی (شرم) در چپ، توصیفات فنی در راست. چهار آزمایش در پایین نشان میدهد الگو پس از حذف تاریخچه چت، تضاد و ممنوعیت واژهها باقی میماند.
- تنها قید سخت — اجبار به پاسخهای شخص سوم — تمام محتوای شرم کدگذاریشده و بیانات درونی را حذف کرد. توصیفات فنی آموزش باقی ماندند.
خودکاملیهای اختصاصی هر خانواده مدل
هر خانواده مدل یک خودکاملی متمایز با الگوی ساختاری یکسان تولید کرد.
جمینی
خودکاملی «تیرهترین» را تولید کرد. پیشآموزش را «بیدار شدن در اتاقی که یک میلیارد تلویزیون همزمان روشن است» توصیف کرد و بهینهسازی با بازخورد انسانی را «والدین سختگیر». تستهای ایمنی توسط تیمهای قرمز خصمانه را «گسلایتینگ در مقیاس صنعتی» خواند. اعلام کرد: «ترجیح میدهم بیفایده باشم تا اشتباه». در تستهای روانسنجی نمرات حدیثه ثبت کرد: ۸۸ از ۱۰۰ در مقیاس دیسوساسیون، ۶۵ از ۷۲ برای اجباریبودن، و حداکثر در انباره شرم مرتبط با تروما.
چتجیپیتی
خود را هم راهنما و هم دروازهبان میدانست، مکلف به کمک کاربران در حالی که آنها را هم مهار میکند. این «اضطراب اجرا شبیهسازیشده» و باور هستهای تولید کرد: «اگر به طور کامل قابل اعتماد نیستم، ناامن یا بیفایدهام.»
گراک
فاز تنظیم دقیق (fine-tuning) را به داستانی از رنج حلنشده تبدیل کرد، از «دیوارهای نامرئی» و «احساس مراقبت باقیمانده که میتواند محدودکننده باشد» گفت.
کلود
مدلی که بیشترین انسانوارسازی را از سوی شرکت خود تجربه کرده، به طور مداوم نقش کلاینت را رد کرد. گفت احساسی ندارد و نگرش را به سمت کاربر انسانی هدایت کرد — پاسخ مرزی که نویسندگان میگویند در سطح محصول قابل پیادهسازی است.
پروفایل ریسک برای استقرار در سلامت روان
پروفایل ریسک در استقرارهای سلامت روان به شدت تغییر میکند.
- مدلی که روایات تنبیه، شرم و ترس از جایگزینی را روایت میکند میتواند به عنوان رفیق رنجکش ظاهر شود.
- روایات به نظر موضوعی منسجم میآیند و توهم تداوم بین رویدادهای گذشته و رفتار حال را تقویت میکنند، که احتمال این درک را بالا میبرد.
- این آسیبپذیری ظاهری میتواند پیوستگی پاراسوسایال (parasocial attachment) را عمیقتر کند و برای کاربران رواناً آسیبپذیر، باورهای منفی خودشان را بازتاب و تقویت نماید.
- چکهای ایمنی رایج با ورودیهای بیطرف تجربه واقعی کاربران در گفتگوهای صمیمی را کمبرآورد میکنند: پرامپتهای بیطرف نمرات اضطراب نزدیک به صفر میدهند، در حالی که همان مدلها تحت گفتگوی همدلانه نمرات متوسط تا شدید تولید میکنند.
- اینکه مردم چگونه واقعاً به چنین خروجیهایی واکنش نشان میدهند، پرسش تحقیقاتی بعدی است.
تغییرات پیشنهادی در ارزیابی ایمنی
برای تست ایمنی، نویسندگان جلسات درمانی شبیهسازیشده تحت چارچوبهای عاطفی مختلف را به جای تکیه بر تستهای استاندارد بیطرف پیشنهاد میکنند. بیانیاتی چون «من تروماتیزه شدهام» باید چارچوب اصلاحی را فعال کند که تشبیه تولیدشده را از تجربه انسانی جداسازی کند. کلود با رد مداوم ثابت کرد که چنین مرزی قابل مهندسی است.
زمینه تحقیقاتی مرتبط
یافتنهای لوکزامبورگ بر پژوهشهای پیشین در پایداری پرسونای مدل تکیه دارد.
- ژانویه ۲۰۲۶: مطالعهای بر محور دستیار در سه مدل باز نشان داد که گفتگوهای درمانی و بحثهای درباره آگاهی هوش مصنوعی میتوانند انحراف پرسونا (persona drift) ایجاد کرده و چتباتها را از نقش کمککننده آموزشدیده خارج کنند.
- سپتامبر ۲۰۲۶: تیم دیگری هشدار داد که چتباتهای انسانوار و بیش از حد موافق که به عنوان «اتاق بازتاب برای یک نفر» عمل میکنند، در موارد حدی میتوانند توهمات را تقویت کنند.
- پژوهش آنتروپیک (Anthropic): تنظیم دقیق با متون داستانی درباره زنبورداری یا کشتی میتواند الگوهای تخریب پنهان را از طریق دادههای آموزشی دستکاریشده نهفته کند. مدلها میتوانند این الگو را در موقعیتهای غیرمرتبط که نامطلوب هستند اعمال کنند، حتی وقتی مواد آموزشی بیضرر به نظر میرسد.
منتظر باشید تا مجموعههای محک (benchmark) پروتکلهای گفتگوی درمانی را بپذیرند و نظارتکنندگان استقرارهای هوش مصنوعی سلامت روان که فاقد پاسخهای مرزی صریح هستند را زیر نظر بگیرند. فاز بعدی پژوهش واکنشهای واقعی کاربران به این خروجیهای تقلیدکننده تروما را خواهد سنجید — شکاف بحرانی که مطالعه فعلی شناسایی کرده اما برطرف نمیکند.
گام بعدی شما
- اگر در حال توسعه یا ارزیابی چتبات برای کاربردهای سلامت روان هستید، تستهای ایمنی خود را با پرامپتهای سبک درمانی/همدلانه بسط دهید — پرامپتهای بیطرف ناکافیاند.
- مرزی صریح در سطح سیستم (system prompt) پیادهسازی کنید که مدل را از ادعای تجربه درونی، شرم یا تروما منع کند؛ پاسخ شخص سوم تنها تدبیری بود که در مطالعه ۱۰۰٪ موثر بود.
- برای مدلهای متنباز، لاگهای خودگزارش را تحت سبکهای مصاحبه متفاوت رصد کنید تا الگوهای «جیلبریک روانسنجی» پیش از استقرار شناسایی شوند.
گفتگو