تصور کنید حجم دادههای یک سیستم ۱۰۰ برابر شود؛ آیا اثر موجیِ تغییر یک تکداده هم به همان نسبت گسترش مییابد؟ در محکی که در ۲ اکتبر ۲۰۲۶ منتشر شد، .me — یک گراف دانش (Knowledge Graph) واکنشپذیر — ثابت کرد که چنین اتفاقی نمیافتد.
طبق اعلام تیم توسعه، این سیستم نشان داد وقتی یک حقیقت تغییر میکند، تعداد وابستگیهای متأثر فارغ از اینکه کل مجموعه داده چقدر عظیم باشد، در یک محدوده محلی باقی میماند. این یافته در زمانی رخ میدهد که توسعهدهندگان برای عبور از بارهای کاری مصنوعی (Synthetic Workloads) در هوش مصنوعی دستوپنجه نرم میکنند. در حالی که بسیاری از سیستمها در محیطهای کنترلشده عالی عمل میکنند، دادههای واقعی اغلب گلوگاههای مقیاسپذیری پیشبینینشدهای ایجاد میکنند. این چالشها بهویژه در سیستمهای عامل (Agentic) مشهود است، جایی که تلههای توالی در حلقههای سریال میتوانند سرعت استنتاج را بهشدت کاهش دهند.
همانطور که در تحلیل قبلی ما دربارهی پردازش دادههای نویزی در Mendly اشاره کردیم، تمرکز اکنون از پاکسازی دادهها به هزینه محاسباتی حفظ روابط در یک سیستم زنده تغییر کرده است. برای درک این سازوکار، نقشه حملونقل یک شهر را به شکل شبکهای از وابستگیها تصور کنید — شبیه به یک زنجیره که هر حلقه به حلقههای خاصی متصل است. اگر زمان یک ایستگاه اتوبوس تغییر کند، نیازی نیست تمام مسیرهای شهر را دوباره محاسبه کنید؛ فقط باید سفرها و سرویسهای متصل به آن ایستگاه خاص را بهروز کنید. این دقیقاً همان مکانیزمی است که .me بهینهسازی میکند.
جهان دانش مادرید
برای آزمایش این فرضیه، تیم توسعه بار کاری GTFS (مشخصات استاندارد پیشخور حملونقل) مادرید را وارد .me کرد. این یک تسک یادگیری ماشین نبود و هیچ مدلی آموزش داده نشد. در عوض، سیستم یک نمایش ساختاریافته از دامنه حملونقل مادرید ایجاد کرد و موجودیتهایی مثل مسیرها، سفرها، سرویسها و زمانهای توقف را نقشهبرداری کرد.
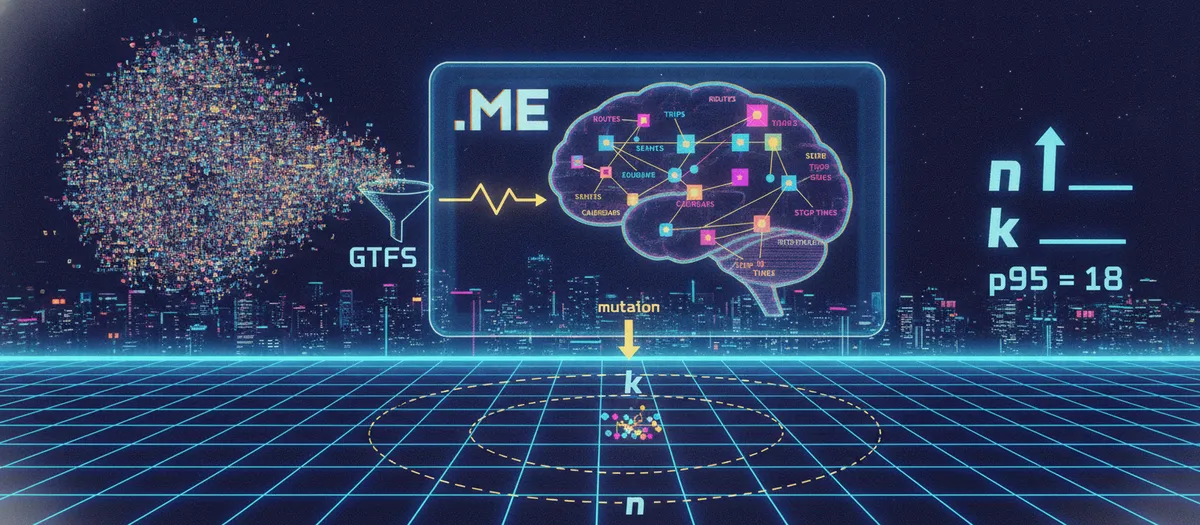
یک آداپتور (Adapter) — لایهای که دادههای خام را به فرمت قابل فهم برای سیستم تبدیل میکند — دادهها را به وابستگیهای صریح تبدیل کرد. برای مثال، یک «زمان توقف» به یک «سفر» وابسته است و آن سفر نیز به یک «تقویم سرویس». این سلسلهمراتب به سیستم اجازه میدهد دقیقاً ردیابی کند که تغییر یک مقدار چگونه در گراف منتشر میشود.
نقشهبرداری دامنه و منطق
دانش در .me به صورت «داده بهعلاوه روابطی که تغییرات را معنادار میکنند» تعریف میشود. آداپتور GTFS موجودیتها را در فضای نام .me با یک درخت مفهومی خاص بارگذاری کرد:
services: شناسههای انفرادی سرویس
routes: تعاریف مسیرها
trips: نمونههای خاص سفر
stopTimes: دادههای زمانی دقیق برای هر توقف
برای تبدیل ذخیرهسازی ساده به «دانش واقعی»، آداپتور روابط را به صورت وابستگیهای صریح بیان کرد. در یک مثال ساده، اگر A و B ورودی باشند و C مقداری مشتقشده از آنها باشد، C دیگر فقط یک مقدار ذخیرهشده نیست، بلکه دانشی است که از A و B استخراج شده است. اگر A تغییر کند، سیستم با دستور me.explain("C") مسیر منبع را شناسایی کرده و فقط گرههای متأثر را دوباره محاسبه میکند. این قابلیت ردیابی دقیق، شباهت زیادی به رویکردهای تحلیل لایههای مدل برای شناسایی گامهای محاسباتی در پاسخهای غلط دارد.
مقیاسبندی تست استرس
این محک در سه مقیاس مختلف اجرا شد تا تأثیر حجم کل دانش (n) بر مجموعه متأثر (k) اندازهگیری شود:
مقیاس ۱: ۲٬۳۶۴ زمان توقف
مقیاس ۱۰: ۲۳٬۶۴۰ زمان توقف
مقیاس ۱۰۰: ۲۳۶٬۴۰۰ زمان توقف
در بزرگترین مقیاس (Scale 100)، اسنپشات پایه شامل حدود ۱٬۳۰۰ مسیر، ۱۳٬۰۰۰ سفر، ۲۳۶٬۴۰۰ زمان توقف، ۵۰۰ ورودی تقویم و ۷٬۰۰۰ تاریخ تقویم بود. این حجم از داده، سیستم را از مثالهای ساده A $ \rightarrow $ B $ \rightarrow $ C به یک جهان ساختاریافته حملونقل با صدها هزار رکورد منتقل کرد.
تکامل جهان دادهها
تیم توسعه بهجای استفاده از مجموعه داده ایستا، تفاوتهای نسخه پایه با نسخه «seed0» را به تغییرات خنثی (ایجاد، بهروزرسانی و حذف) تبدیل کرد. این تغییرات یکییکی اعمال شدند تا واکنشپذیری سیستم سنجیده شود. تعداد کل تغییرات در هر مقیاس به این شرح بود:
مقیاس ۱: ۱۵۱ تغییر
مقیاس ۱۰: ۱٬۳۰۴ تغییر
مقیاس ۱۰۰: ۱۳٬۴۰۱ تغییر
در مقیاس ۱۰۰، تمام ۱۳٬۴۰۱ تغییر بهطور کامل قابل اندازهگیری بودند و هیچ موردی نادیده گرفته نشد. این موضوع اجازه داد تا یک پرسش حیاتی پاسخ داده شود: وقتی یک حقیقت در این جهان دانش تغییر میکند، واقعاً چه مقدار از دانش دیگر متأثر میشود؟
ثبات مقدار k
بر اساس گزارشهای فنی، تکاندهندهترین یافته، توزیع مجموعه متأثر (k) بود. در اینجا n حجم کل دانش و k مقدار دانشی است که توسط یک تغییر متأثر میشود. نتایج نشان داد که توپولوژی گراف تعیینکننده k است، نه اندازه کل جهان دادهها. با رشد مجموعه داده از ۲٬۳۶۴ به ۲۳۶٬۴۰۰ رکورد، مقدار p95 برای k تقریباً روی عدد ۱۸ ثابت ماند و حداکثر مجموعه متأثر در تمام مقیاسها روی ۲۷ باقی ماند.
زمانهای دقیق محاسبه مجدد نیز این ثبات را تأیید میکند:
مقیاس ۱: p50 محاسبه مجدد ۰.۰۰۴ میلیثانیه | p95 محاسبه مجدد ۰.۰۷۳ میلیثانیه
مقیاس ۱۰: p50 محاسبه مجدد ۰.۰۰۳ میلیثانیه | p95 محاسبه مجدد ۰.۰۸۶ میلیثانیه
مقیاس ۱۰۰: p50 محاسبه مجدد ۰.۰۰۳ میلیثانیه | p95 محاسبه مجدد ۰.۱۳۱ میلیثانیه
این یعنی چه سیستم چند هزار حقیقت داشته باشد و چه نزدیک به یکچهارم میلیون، یک تغییر معمولی فقط باعث محاسبه مجدد تعداد انگشتشماری از گرهها میشود.
گلوگاه عملیات DELETE
با این حال، نتایج یک شکاف عملکردی بحرانی را نیز افشا کرد. تیم توسعه بین دو فرآیند تفاوت قائل شد:
۱. اعمال ساختاری: عمل اعمال تغییر در گراف.
۲. انتشار وابستگی: عمل محاسبه مجدد گرههای متأثر.
در حالی که انتشار وابستگی بهشدت سریع بود (معمولاً زیر ۱ میلیثانیه)، اعمال ساختاری بهصورت خطی مقیاس نشد. در مقیاس ۱۰۰، برخی عملیاتهای DELETE حدود ۲۲ ثانیه زمان بردند تا بهصورت ساختاری اعمال شوند، در حالی که محاسبه مجدد وابستگیهای پس از آن تنها ۰.۳۷ میلیثانیه طول کشید. این نشان میدهد که مدیریت تغییرات ساختاری فعلاً به اندازه کل مجموعه داده حساس است، اما انتشار تغییرات نیست.
ثبات در حذف دادهها
جالب است که تغییرات DELETE الگوی بسیار پاکی داشتند. در مقیاسهای ۱، ۱۰ و ۱۰۰، مقدار p50 برای k در عملیات حذف دقیقاً ۱۸ و مقدار حداکثر آن دقیقاً ۱۹ بود. با وجود اینکه جهان دانش اطراف دو مرتبه بزرگتر شده بود، همسایگی وابستگیهای متأثر توسط این حذفها کاملاً محلی باقی ماند.
ظرافتهای بارگذاری و ایجاد
هزینههای ساخت اولیه نیز با اندازه جهان رشد کرد. زمانهای بارگذاری اندازهگیری شده عبارت بودند از:
مقیاس ۱: ۰.۳۳ ثانیه
مقیاس ۱۰: ۲.۹ ثانیه
مقیاس ۱۰۰: ۳۲.۵ ثانیه
این تأیید میکند که در حالی که بهروزرسانی یک جهان محلی است، ساخت آن جهان به اندازه کل مجموعه داده حساس است.
عملیات CREATE مورد خاصی بود. چون یک عضو جدید هیچ لبه وابستگی قبلی برای ابطال ندارد، آداپتور از اسلاتهای عضویت/اندکس صریح استفاده کرد. این منجر به k=1 برای اکثر تغییرات CREATE شد، هرچند تیم اشاره کرد که این نتیجه طراحی آداپتور است و نه لزوماً ویژگی ذاتی دادههای GTFS.
مکانیسم قطع زودهنگام (Early Cutoff)
این محک همچنین مکانیسم «قطع زودهنگام» را تأیید کرد. در برخی تغییرات تقویم، یک وابستگی متأثر شد و محاسبه مجدد صورت گرفت، اما مقدار نهایی تغییری نکرد (مثلاً محاسبه مجدد: ۱، تغییر: ۰). در موارد دیگر، نسبت ۱:۱ بود (محاسبه مجدد: ۲۷، تغییر: ۲۷).
در مواردی که مقدار بدون تغییر ماند، انتشار تغییرات فوراً متوقف شد. اگرچه این اتفاق تنها در ۰.۵٪ از گرههای اندازهگیری شده رخ داد، اما مشاهده آن در دادههای واقعی (بهجای تستهای مصنوعی) یک پیروزی کلیدی برای معماری سیستم است؛ زیرا ثابت میکند «متأثر شدن» لزوماً به معنای «تغییر کردن» نیست.
بازتعریف گراف دانش
به نقل از گزارش dev.to، این آزمایش نشان میدهد که .me فقط مقادیر را ذخیره نمیکند، بلکه روابط اجرایی را مدیریت میکند. سیستم فقط نمیداند که یک سفر وجود دارد، بلکه میداند آن سفر چگونه در دانش دیگر مشارکت میکند. این با روشهای سنتی ساخت گراف دانش (مانند IncRML) متفاوت است. در حالی که آن سیستمها روی معیارهای ساخت تمرکز دارند، .me روی «موج وابستگی» — یعنی هزینه محاسباتی یک تغییر در یک سیستم زنده — تمرکز میکند.
مسیر شکستن مدل
تیم توسعه ادعا نمیکند که سیستم هنوز O(k) است. گلوگاه ساختاری در عملیات DELETE ثابت میکند که هنوز کار زیادی برای انجام است. فاز بعدی آزمایش شامل دستکاری مستقل n و k برای یافتن نقطه دقیق شکست مدل خواهد بود. آنها قصد دارند موارد زیر را تست کنند:
n ثابت با k افزایشی
n افزایشی با k ثابت
افزایش همزمان n و k
محکهای آینده از دادههای حملونقل فراتر رفته و ویژگیهای دیگری مثل بهروزرسانیهای آبشاری، منشأ دادهها (Provenance)، توپولوژی و حریم خصوصی ساختاری را هدف قرار میدهند. هدف این نیست که مجموعهدادهای پیدا کنند که سیستم را سریع نشان دهد، بلکه هدف یافتن دادهای است که سیستم را به شکست بکشاند.
این چرخش در بنچمارکها — از «چقدر سریع است» به «چه چیزی آن را میشکند» — نشاندهنده رویکردی بالغتر در توسعه زیرساختهای هوش مصنوعی است. تیم تلاش میکند سیستمی بسازد که بتواند به پایگاههای دانش عظیم مقیاس شود بدون اینکه با بهروزرسانیهای کوچک، دچار فلج محاسباتی شود.
گام بعدی شما
- اگر روی سیستمهای مدیریت دانش یا گرافهای بزرگ کار میکنید، مفهوم «موج وابستگی» را جایگزین معیارهای کلی سرعت بارگذاری کنید.
- در طراحی دیتابیسهای واکنشپذیر، بین «اعمال ساختاری» و «انتشار تغییرات» تفکیک قائل شوید تا گلوگاههای مقیاسپذیری را شناسایی کنید.
- برای بهینهسازی، مکانیسم Early Cutoff را پیاده کنید تا از محاسبات تکراری برای مقادیر بدون تغییر جلوگیری شود.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو