
تصور کنید بتوانید بدون خواندن یک کلمه از پاسخ هوش مصنوعی، دقیقاً بفهمید مدل در هر لحظه در حال استخراج داده است یا انجام یک محاسبه پیچیده. این قابلیت اکنون با شناسایی نقشهی عددیِ عملیات استدلالی در لایههای داخلی مدلهای زبانی ممکن شده است.
طبق اعلام پژوهشگران KAIST و Naver AI Lab در گزارشی که ۱۲ سپتامبر ۲۰۲۶ منتشر شد، حالتهای داخلی یک مدل زبانی بزرگ (LLM) بسته به نوع عملیات ذهنی مدل، تغییراتی پیشبینیپذیر دارند. این کشف در حالی رخ میدهد که صنعت با چالش «جعبه سیاه» در پردازشهای زنجیره تفکر (Chain-of-Thought) دستوپنجه نرم میکند؛ یعنی هنوز مشخص نیست آیا متنی که مدلها برای نمایش مراحل فکرشان مینویسند، بازتاب واقعی محاسبات داخلی است یا صرفاً یک توجیه پسینی برای رسیدن به جواب.
همانطور که در تحلیلهای پیشین ما دربارهی تفسیرپذیری مدلهای بازمتن اشاره کردیم، دسترسی به سیگنالهای داخلی اجازه میدهد «چرخدندههای» مدل را فارغ از کلمات خروجی مشاهده کنیم.
برای اثبات این ادعا، تیم تحقیق مدلهای Qwen2.5-7B، Qwen3-8B و Gemma4-31B را هنگام حل مسائل ریاضی تحلیل کردند. آنها هشت عملیات تکرارشونده — از جمله تجزیه مسئله، استنتاج و محاسبه — را تعریف کرده و از GPT-5 برای برچسبگذاری بخشهای متنی متناظر استفاده کردند.
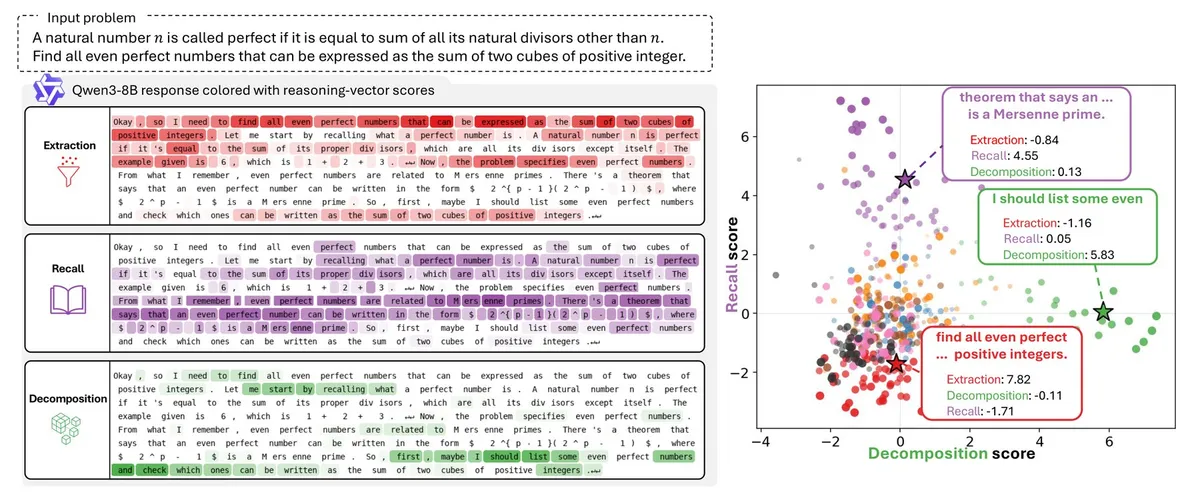
بر اساس مستندات این پژوهش، یافتههای فنی کلیدی عبارتاند از:
- تخصص لایهای: قویترین سیگنالهای مربوط به عملیات استدلالی در لایههای میانی مدلها یافت شد.
- استقلال معنایی: کلمات رایجی مانند «است» یا «که»، بسته به اینکه در کدام مرحله از استدلال قرار دارند، نمایشهای عددی متفاوتی در لایههای داخلی دارند. این رویکرد در تحلیل نمایشهای عددی، شباهتهایی به بهینهسازی مدلهای کوچک بردار معنایی در بازیابی متنی دارد که بر دقت نمایشهای فشرده تأکید میکردند.
- وابستگی به زمینه: مسدود کردن توجه (Attention) به ۳۰ توکن قبلی، سیگنال عملیات را تضعیف کرد؛ این یعنی استدلالها بهصورت مجزا رخ نمیدهند و بر بستر متن قبلی بنا میشوند.
- پایداری خطا: حتی زمانی که مدل پاسخ اشتباه میداد، نمایش داخلی مربوط به «مرحله محاسبه» همچنان قابل شناسایی بود.
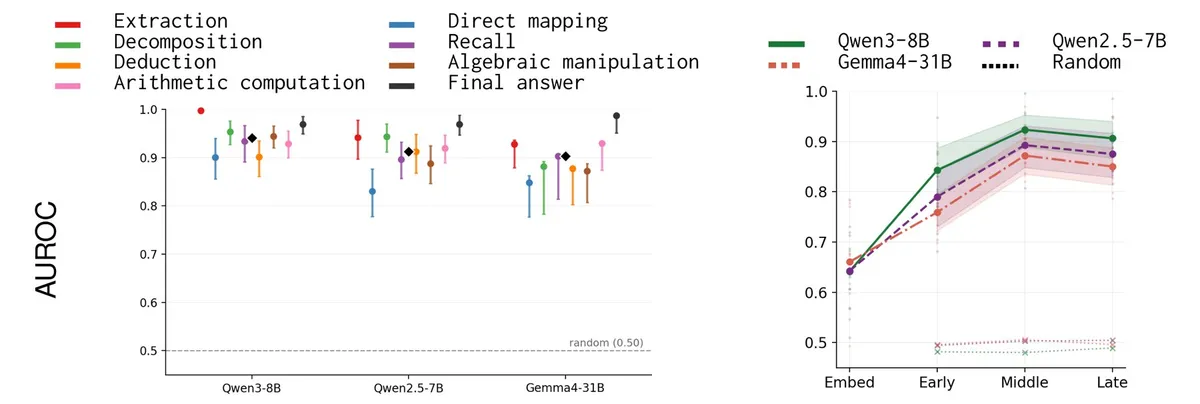
پژوهشگران با استفاده از Llama-3-8B نتایج را اعتبارسنجی کردند و دریافتند طبقهبندهای آموزشدیده روی Qwen3-8B بهطور موفقیتآمیزی روی محکهای GPQA-Diamond و MATH-500 نیز قابل تعمیم هستند.
برای جامعه فنی، این یافته فرضیه «متن به عنوان تنها پنجره منطق» را میشکند. اکنون میتوان با پایش بردارهای داخلی، لحظه تغییر حالت مدل از «بازیابی» به «استنتاج» را رصد کرد که لایه جدیدی از مشاهدهپذیری برای ایمنی هوش مصنوعی (AI Safety) فراهم میکند.
این موضوع بهویژه در عصر استدلالهای «پنهان» حیاتی است. برای مثال، Anthropic پیشتر دریافت که Claude Opus 4.6 اطلاعات بیشتری را درونی پردازش میکند تا در متن افشا کند و مدل Astra از OpenAI نیز استدلال را به فضاهای عددی منتقل کرده است. این پیچیدگی در معماری مدلها، چالشهایی را ایجاد میکند که در تحلیل استراتژیهای چندمدلی و تضاد ارزش تجاری با پیچیدگی عملیاتی به آنها پرداخته بودیم.
گام بعدی شما
- بررسی مقالات مربوط به «تفسیرپذیری مکانیکی» (Mechanistic Interpretability) برای درک نحوه استخراج این بردارها.
- دنبال کردن ابزارهای پایش لایههای داخلی مدلهای بازمتن برای شناسایی نقاط شکست در استدلال.
- تحلیل تفاوت میان خروجی متنی و حالتهای داخلی در مدلهای استدلالی جدید.
اما آیا میتوان از این الگوهای عددی برای اصلاح مسیر مدل در لحظه تولید یا شناسایی خودکار توهم (Hallucination) استفاده کرد؟ پاسخ این پرسش در گزارشهای بعدی ما درباره کنترل لایههای نهان بررسی خواهد شد.



گفتگو