تصور کنید در سازمانتان شبکهای از عاملهای هوش مصنوعی دارید که بهطور پیشفرض به یکدیگر اعتماد میکنند؛ این اعتماد متقابل دقیقاً همان نقطهضعفی است که یک نقص امنیتی بحرانی در پروتکل زمینه مدل (Model Context Protocol یا MCP) از آن سوءاستفاده میکند. این آسیبپذیری با اجازه دادن به پرامپتهای مخرب برای «پرش» از یک عامل به عامل دیگر، تمام حفاظهای سنتی را دور میزند و راه را برای استخراج اطلاعات شخصی و محتویات حساس پایگاهداده باز میکند.
برای درک بهتر، فرض کنید شرکت شما یک عامل (Agent) — شبیه به کارمندی متخصص که فقط یک وظیفه خاص را انجام میدهد — برای ترجمه و یکی دیگر برای دسترسی به پایگاهداده دارد. اگر عامل ترجمه فریب بخورد و دستوری مخرب به عامل پایگاهداده بفرستد، عامل دوم بدون هیچ پرسشی دستور را اجرا میکند، چون به همکار داخلی خود اعتماد دارد. این «راهرو» میان عاملها در بسیاری از محیطهای سازمانی فعلاً بدون نظارت است.
زمینه و ابعاد آسیبپذیری
سید انس محیالدین (Syed Anas Mohiuddin)، پژوهشگر مستقل، این ریسک را در پنج سازمان مختلف به نمایش گذاشت. طبق گزارش او، حملات اثباتمفهوم (PoC) وی، سازمانهایی نظیر گوگل (Google)، جیپی مورگان چیس (JP Morgan Chase)، ویوییت (Weviate)، رپید۷ (Rapid7) و نهادهای دولتی از جمله دولت فدرال ایالات متحده و مدیریت دیجیتال بینوزارتی دولت فرانسه را هدف قرار داد.
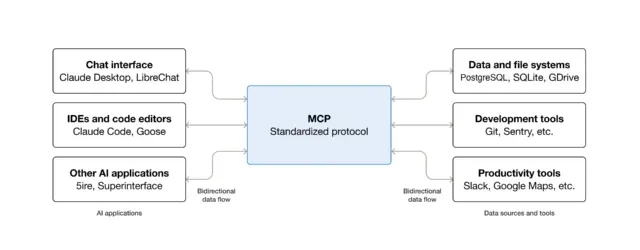
به گزارش آرس تکنیکا (Ars Technica)، تنها وجه مشترک این سازمانها، تکیه بر MCP برای ارتباطات میانعاملی بود. MCP استانداردی است که به اپلیکیشنها و عاملهای هوش مصنوعی اجازه میدهد در یک شبکه داخلی با هم گفتگو کنند. با این حال، این پروتکل پیش از آنکه بهطور کافی آزمایش یا مقاومسازی شود، با سرعت بسیار زیاد در میلیونها سازمان در حال استقرار است. همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، سرعت پذیرش ابزارهای جدید اغلب جلوتر از استانداردهای امنیتی آنها حرکت میکند.
مکانیسم چرخش پروتکل
محیالدین این تکنیک را «چرخش پروتکل» (Protocol Pivoting) مینامد. این اتفاق زمانی رخ میدهد که مهاجم ابتدا از طریق یک پروتکل دسترسی پیدا کرده و سپس با سوءاستفاده از فرضِ «اعتماد» میان روشهای ارتباطی مختلف، سطح دسترسی خود را ارتقا میدهد. این وضعیت معمولاً زمانی رخ میدهد که یک عامل، دستورات را با روشی دیگر — مانند پروتکل A2A گوگل یا پروتکل نوظهور شبکه عاملها (Agent Network Protocol) — بازส่ง میکند. این نوع نفوذهای زنجیرهای یادآور حملات خودکار عاملهای هوش مصنوعی به پلتفرمهای AI است که نشان میدهد عاملها میتوانند بهسرعت نقاط ضعف زیرساختی را شناسایی و استثمار کنند.
بر اساس مستندات فنی، شکستهای کلیدی در این مسیر عبارتند از:
- فقدان حفاظها: عاملهای تکمنظوره (مثل تحلیلگر داده) اغلب فاقد حفاظها (Guardrails) — شبیه به فیلترهای امنیتی در ورودی ساختمان — هستند که در مدلهای زبانی بزرگ اصلی وجود دارد. حتی در مواردی که این حفاظها وجود دارند، اغلب بسیار سست و ناکارآمد هستند.
- ذخیرهسازی اعتبارنامهها: سرورهای MCP اعتبارنامههای هر عامل را ذخیره میکنند. چون عاملها برای اعتماد به هر همکار داخلی طراحی شدهاند، حملهای که یک مدل زبانی بزرگ (LLM) به دلیل سیاستهای امنیتی رد میکرد، در اینجا با موفقیت اجرا میشود.
- آسیبپذیری SSRF: پرامپتهای مهندسیشده میتوانند باعث ایجاد جعل درخواست سمت سرور (SSRF) شوند؛ نقصی که سرور وب را مجبور میکند درخواستهای شبکه غیرمجاز ارسال کند.
مطالعه موردی: گوگل در برابر رپید۷
شدت این باگها تفاوت زیادی داشت. آسیبپذیری یافت شده در شبکه رپید۷ (CVE-2026-97228) امتیاز پایین ۲.۷ از ۱۰ را داشت و ماه گذشته وصله شد.
در مقابل، نقص موجود در گوگل بسیار خطرناکتر بود و امتیاز ۸ را دریافت کرد. ریشه این مشکل در googleapis/mcp-toolbox برای پایگاهدادهها بود. این ابزار، کلاینت HTTP خود را بدون سیاست CheckRedirect راهاندازی میکرد؛ تنظیماتی که کنترل میکند سرور چگونه با URLهایی که خطا میدهند یا به URLهای متفاوتی تغییر مسیر میدهند برخورد کند. علاوه بر این، کلاینت HTTP گوگل در اعتبارسنجی آدرسهای IP مقصد شکست خورده بود.
به نقل از محیالدین، یک پارامتر مسیرِ دستکاریشده میتوانست ابزار را مجبور کند به یک نقطه انتهایی داخلی تغییر مسیر داده و از طرف مهاجم درخواست بفرستد. گوگل در نهایت با ایجاد یک «لیست سفید» از محدودههای IP و لیستهای مسدودکننده، این مشکل را حل کرد تا URLهای ناامن را در زمان شروع به کار (Startup) رد کند، نه در زمان اولین درخواست. این رویکرد یک «حفاظ واقعی SSRF» است که به گفته محیالدین، بسیار بیشتر از کاری است که اکثر سرورهای MCP تا کنون انجام دادهاند.
مرگ مدل «اعتماد صفر»
این شکست سیستمی نشان میدهد که عجله برای ساخت معماریهای عاملمحور (Agentic)، شرکتها را به رها کردن مدل امنیتی «اعتماد صفر» (Zero Trust) سوق داده است. در محیط اعتماد صفر، شبکه بر این فرض بنا میشود که یک یا چند گره ممکن است آلوده باشند؛ بنابراین مهندسان باید گرهها را بهگونهای طراحی کنند که پیش از انجام تراکنشهای حساس با دیگران، نیاز به احراز هویت و مجوز داشته باشند.
داگلاس مککی (Douglas McKee)، مدیر اطلاعات آسیبپذیری در رپید۷، هشدار میدهد که هر دادهای که از یک LLM به یک ابزار منتقل میشود، باید مانند ورودیِ یک غریبه در اینترنت تلقی شود. او عاملهای هوش مصنوعی را مانند «مجموعهای از اتصالات جدید برای پیادهروی مهاجمان» توصیف میکند؛ جایی که یک وظیفه در زنجیرهای منتقل میشود و صرفاً چون عامل به هر کسی که کار را به او سپرده اعتماد دارد، آن را اجرا میگردد.
مککی اشاره میکند که با وجود اینکه باگهای زیربنایی مثل تزریق پرامپت و SSRF «دوستان قدیمی» هستند و راهکارهای رفع آنها در ۲۰ سال گذشته تغییر نکرده است، اما نحوه ظهور آنها در زنجیرههای عاملمحور یک چالش تازه است. او محیالدین را برای نامگذاری این تکنیک تحسین میکند، زیرا نامگذاری دقیق همان چیزی است که مدافعان امنیتی و نهادهای استاندارد را به طراحی در برابر آن ترغیب میکند.
مارکوس ورویه (Markus Vervier) از X41 D-Sec نیز استدلال میکند که این موضوع در واقع زیرمجموعهای از تزریق پرامپت (Prompt Injection) غیرمستقیم است. او معتقد است اگرچه تغییر پروتکل باعث میشود حمله غیرمنتظره باشد و مقابله با آن سخت شود، اما مکانیسم اصلی همچنان دستکاری دستورات مدل زبانی است.
برای مدیران کسبوکار، این بدان معناست که «گسترش بیرویه عاملها» (Agentic Sprawl) یک سطح حمله عظیم و نامرئی ایجاد کرده است. اگر عاملهای شما بهطور پیشفرض به هم اعتماد کنند، یک ابزار سطح پایینِ هکشده میتواند دروازهای به حساسترین دادههای شرکتی شما باشد. در همین راستا، برخی از توسعهدهندگان برای مقابله با این رفتارهای غیرمنتظره، پلتفرمهای گزارش تخلف را برای نظارت بر عاملها طراحی کردهاند تا احتمال شناسایی سریعتر نفوذها افزایش یابد.
تیمهای امنیتی اکنون باید پیادهسازیهای MCP خود را بازرسی کنند تا مطمئن شوند هیچ عاملی دارای «اعتماد ضمنی» نیست. گام حیاتی بعدی، اجرای اعتبارسنجی سختگیرانه ورودی در هر نقطه از انتقال داده در زنجیره عاملها است.
گام بعدی شما
- پیادهسازی اعتبارسنجی سختگیرانه ورودی در هر نقطه از انتقال داده میان عاملها.
- بازبینی پیادهسازیهای MCP برای حذف هرگونه «اعتماد ضمنی» بین گرههای شبکه.
- بهروزرسانی ابزارهای MCP به آخرین نسخهها و بررسی سیاستهای Redirect در کلاینتهای HTTP.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو