اگر امروز برای توسعه نرمافزار به مدلهای پیشرو تکیه میکنید، رقابت در صدر جدول کدنویسی وارد فاز جدیدی شده است. امتیاز ۶۸ در شاخص عاملهای کدنویسی (Coding Agents Index)، جایگاه جدید مدل Muse Wonder Full شرکت متا است که آن را دقیقاً در برابر Claude Code با مدل Sonnet 5.5 قرار میدهد. این مدل که در ۱۲ اکتبر ۲۰۲۶ منتشر شد، نشاندهنده چرخش تهاجمی متا به سمت قابلیتهای عاملمحور (Agentic) است.
این عرضه در حالی صورت میگیرد که متا تلاش میکند جایگاه خود را در میان آزمایشگاههای پیشرو هوش مصنوعی بازپس گیرد. با تکیه بر پوشش پیشین ما درباره اینکه چگونه S-Space متا مختصات سهبعدی را از مدلهای زبانی چندوجهی (Multimodal LLMs) استخراج میکند، این شرکت اکنون در حال تغییر مسیر از پژوهشهای تخصصی به سمت عاملهای شخصی همهمنظوره است. تصور کنید هوش مصنوعی بهجای چت ساده، مثل یک دستیار اجرایی که تمام پروندههای شما را میشناسد، تقویم، پیامها و اسناد شما را با حافظهای پایدار مدیریت کند.
جایگاه در بازار
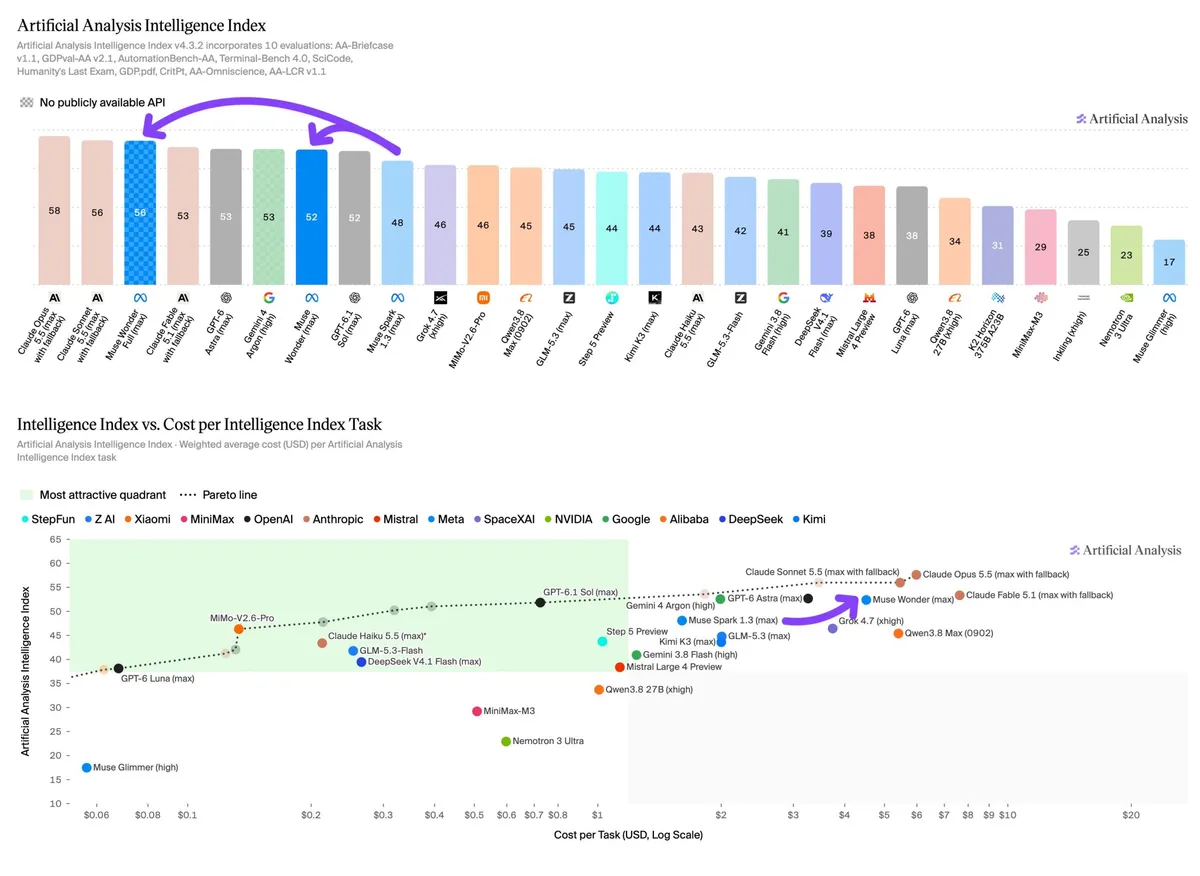
به نظر میرسد متا پس از یک دوره ضعیفتر با مدلهای باز Llama، توانسته است خود را بازیابی کند. سری جدید مدلها جهشی قابل توجه نسبت به نسل قبلی یعنی Muse Spark 1.3 است که در شاخص هوش مصنوعی تنها ۴۸ امتیاز داشت.
به گزارش Vals AI، مدل Muse Wonder Full (Max) در رتبه پنجم این شاخص شروع به کار کرده است. طبق دادههای Vals AI، این مدل از تمام مدلهای OpenAI پیشی گرفته و تنها مدلهای فعلی Anthropic امتیاز بالاتری دارند. در مقابل، نسخه استاندارد Muse Wonder در رتبه دهم ایستاده است.
طبق گزارش وبسایت the-decoder.com، این خانواده شامل دو نسخه است: Muse Wonder و Muse Wonder Full. نسخه Full موتور محرک و قدرتمند این سری است که امتیاز ۵۶ را در شاخص هوش مصنوعی Artificial Analysis v4.3 کسب کرده است، در حالی که نسخه استاندارد Muse Wonder به امتیاز ۵۲ رسیده است.
جزئیات فنی
مشخصات فنی این سری مدلها شامل موارد زیر است:
- پنجره متنی (Context Window) — مثل میز کاری بزرگ که جای چندین کتاب را دارد نه فقط یک ورق — یک میلیون توکن را برای متن، تصویر، ویدیو و صدا پشتیبانی میکند.
- حافظه فعال: توانایی یادآوری اطلاعات کلیدی در گفتگوهای مجزا و حفظ پیوستگی اطلاعات. این قابلیت در راستای استراتژی متا برای ارتقای حافظه فعال و یادآوری ترجیحات کاربر در مدلهای جدید توسعه یافته است تا تجربه شخصیسازیشدهتری ارائه دهد.
- تمرکز فعال: مکانیزمی برای پافشاری در کارهای دشوار، امتحان کردن روشهای جایگزین و پرسیدن سوالات شفافکننده برای درک بهتر مسئله.
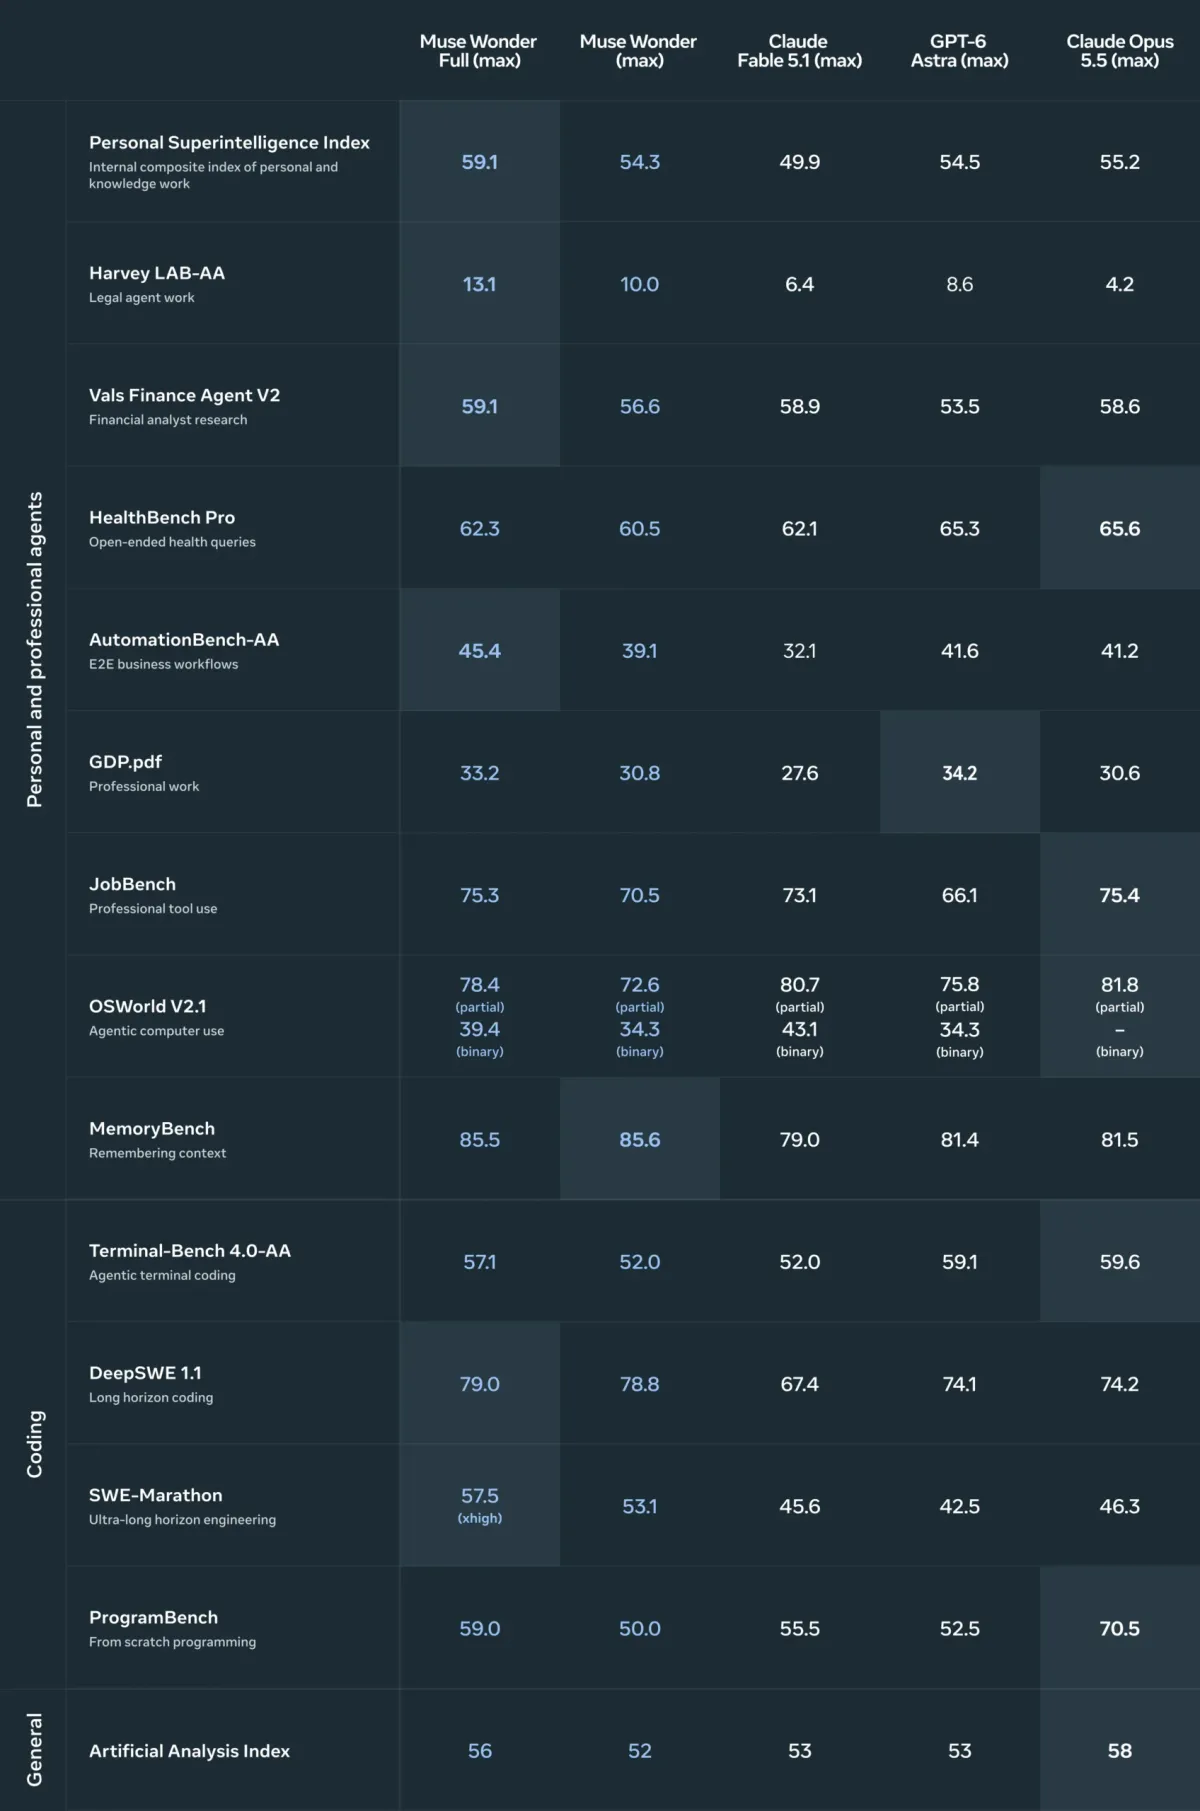
- عملکرد عاملمحور: امتیاز Terminal-Bench 4.0 از ۳۳٪ در مدل Muse Spark 1.3 به ۵۷٪ جهش کرد. مدل Muse Wonder Full امتیاز خود را در این محک دو برابر کرد، در حالی که ۳۰٪ توکنهای خروجی کمتری مصرف کرد.
- توانایی ریاضی: در آزمون ProofBench، مدل Muse Wonder Full از ۱۰۰ مسئله، ۹۴ مورد را حل کرد (در مقابل ۵۸ مورد در نسل قبل). این نتیجه مدل را در فاصله ۵ تا ۶ امتیازی از برترین مدلهای جهان (که امتیاز ۹۹-۱۰۰ دارند) قرار میدهد.
- بهبود کدنویسی: امتیاز Muse Wonder در شاخص عاملهای کدنویسی از ۵۴ در نسخه قبلی به ۶۳ رسید.
شکاف دانشی
با وجود قدرت در کدنویسی، صحت اطلاعاتی (Factual Accuracy) همچنان یک نقطه ضعف و ریسک برای متا است. بر اساس دادههای آزمون AA-Omniscience، مدل Muse Wonder Full تنها ۳۰ امتیاز و Muse Wonder ۲۵ امتیاز کسب کردند. این اعداد بهشدت پایینتر از Claude Opus 5.5 (۴۶)، GPT-6 Astra (۴۳) و Gemini 4 Argon (۴۲) است؛ موضوعی که نشان میدهد متا احتمالاً از یک مدل بنیادی (Foundation Model) کوچکتر نسبت به رقبای اصلیاش استفاده کرده است.
اما متا این نقص را با قابلیت اطمینان جبران کرده است. نرخ توهم (Hallucination) — شبیه دوستی که با اطمینان کامل خاطرهای ساختگی را تعریف میکند — در مدل Muse Wonder Full از ۳۳٪ به ۲۳٪ کاهش یافت. این دومین پایینترین نرخ توهم در میان مدلهایی است که حداقل ۴۵ امتیاز در شاخص مربوطه دارند. در این گروه، تنها Gemini 4 Argon با نرخ ۱۵٪ عملکرد بهتری دارد.
متا در یادداشت وبلاگی خود به انتقاداتی که مدلهایش را «بهینهشده برای بنچمارکها اما ضعیف در دنیای واقعی» مینامیدند، پاسخ داد. این شرکت مدعی شد Muse Wonder Full در کارهای ناشناخته که بخشی از بهینهسازیهای آموزشی نبودهاند، بهتر از حد انتظار عمل میکند و این موفقیت را مدیون یک مدل بنیادی قویتر میداند.
هزینه قدرت
این عملکرد با افزایش شدید قیمت همراه است. طبق گزارش Artificial Analysis، هزینه هر تسک برای Muse Wonder به ۴.۵۲ دلار رسید که تقریباً سه برابر هزینه مدل Muse Spark 1.3 (۱.۶۰ دلار) است.
قیمت توکنها نیز جهش شدیدی داشته است:
- توکنهای ورودی: ۴ دلار بهازای هر میلیون (افزایش از ۱.۲۵ دلار).
- توکنهای خروجی: ۲۰ دلار بهازای هر میلیون (افزایش از ۴.۲۵ دلار).
- کارایی: Muse Wonder در هر تسک ۲۸٪ توکن ورودی بیشتری مصرف میکند که ۷۶٪ از کل هزینهها را تشکیل میدهد.
در مقایسه، Muse Wonder ارزانتر از Claude Fable 5.1 (۷.۶۳ دلار) و Claude Opus 5.5 (۵.۹۸ دلار) است، اما گرانتر از GPT-6 Astra (۳.۲۶ دلار)، Gemini 4 Argon (۱.۹۹ دلار) و GPT-6.1 Sol (۰.۷۲ دلار) قرار میگیرد. هنوز قیمتگذاری توکنها برای نسخه Muse Wonder Full منتشر نشده است.
متا این مدلها را در مرکز داده غولپیکر Prometheus که در مقیاس گیگاوات فعالیت میکند، آموزش داده است. در حالی که Muse Wonder از طریق API و اپلیکیشن Muse برای مشترکین پولی در دسترس است، نسخه Muse Wonder Full فعلاً محدود به کاربران Muse Code است.
این استراتژی نشان میدهد متا «کاربرد عاملمحور» (توانایی انجام کار) را بر «دانش دانشنامهای» ترجیح داده است. برای یک کاربر تجاری، این یعنی ابزاری که در نوشتن یک اسکریپت پیچیده پایتون یا تحلیل اسناد حقوقی بهتر است، اما در بازگویی حقایق مبهم یا دانشنامهای ضعیفتر عمل میکند. شایان ذکر است که عملکرد این مدل در تسکهای مالی و حقوقی ثابت مانده و حتی تا دو امتیاز افت کرده است.
متا با متصل کردن برترین مدل خود به Muse Code، در ابتدا بازار توسعهدهندگان را هدف قرار داده است. اگر آنها بتوانند قابلیت اطمینان مدل را در محیطهای عملیاتی (Production) ثابت کنند، انتقال به یک عامل مصرفکننده عمومی تنها مسئله مقیاسپذیری خواهد بود، نه قابلیت.
در آینده باید منتظر عرضه نسخههای تخصصی Muse Wonder برای کاربران عادی باشیم که متا قصد دارد به مرور زمان بر اساس این مدل بنیادی بسازد.
گام بعدی شما
- اگر توسعهدهنده هستید، دسترسی به Muse Code را برای مقایسه نرخ خطای کدنویسی با Claude Sonnet بررسی کنید.
- برای کاهش هزینههای استنتاج، توکنهای ورودی را بهینه کنید زیرا ۷۶٪ هزینه در این مدل مربوط به ورودی است.
- در تسکهایی که نیاز به دقت تاریخی یا علمی بالا دارند، همچنان از مدلهای Gemini یا GPT استفاده کنید.
اما داستان سختافزاری این تحول در مرکز داده Prometheus حتی شگفتانگیزتر است — به تحلیل ما درباره زیرساختهای محاسباتی مقیاس گیگاوات مراجعه کنید.



گفتگو