اگر امروز برای پیادهسازی یک دستیار صوتی با کیفیت هزینه میپردازید، احتمالاً با هزینهای بسیار کمتر و سرعتی خیرهکننده با گزینههای جدید روبرو هستید. طبق گزارشی که در ۱۴ سپتامبر ۲۰۲۶ منتشر شد، شرکت Nari Labs توانسته است در هر دو حوزه تبدیل گفتار به متن (STT) و تبدیل متن به گفتار (TTS)، جایگاه نخست در «مرز پارتو» (Pareto Frontier) کیفیت-تأخیر را تصاحب کند.
عاملهای صوتی زمانی ناکارآمد میشوند که بین درخواست کاربر و پاسخ مدل، وقفهای طولانی ایجاد شود. برای سنجش این موضوع، صنعت به محکهای Coval تکیه میکند؛ پلتفرمی که زمان رسیدن به اولین تکه صوتی (TTFA) و زمان تکمیل قطعه نهایی (TTFS) را اندازهگیری میکند. همانطور که در تحلیلهای قبلی ما درباره بهینهسازی استنتاج مدلهای زبانی اشاره کردیم، کاهش این تأخیرها کلید تبدیل یک چتبات ساده به یک همصحبت انسانی است.
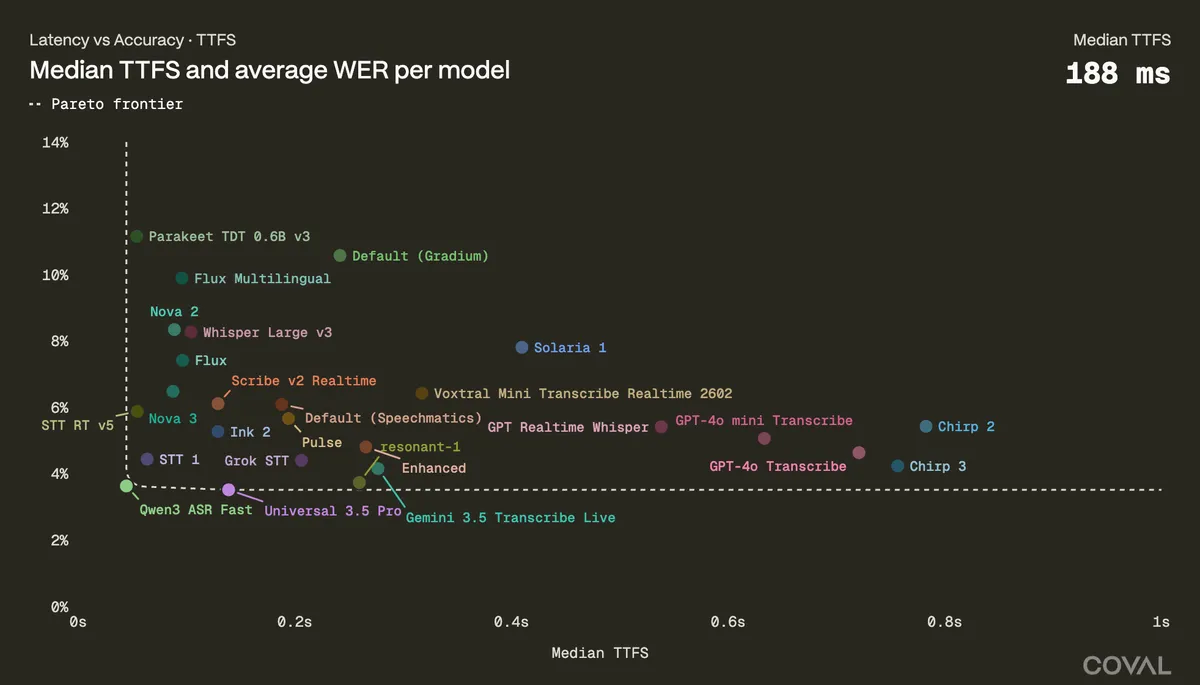
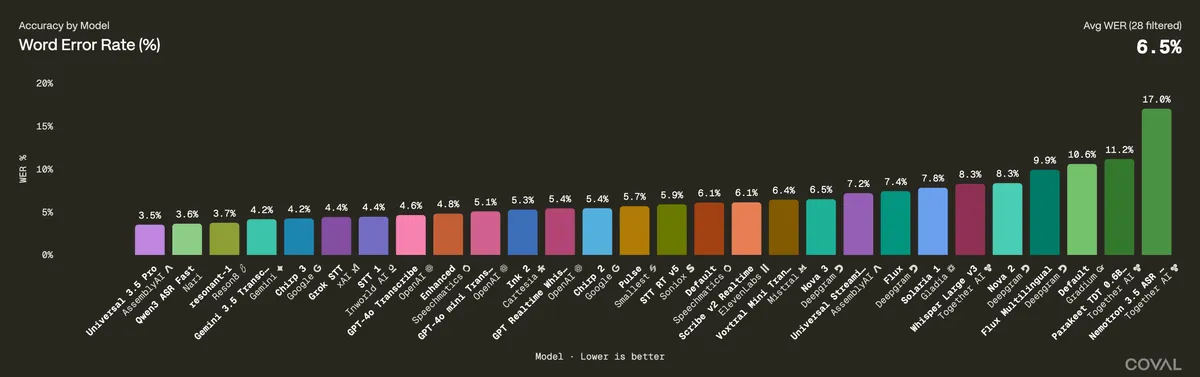
در بخش تبدیل گفتار به متن، مدل Qwen3-ASR Fast با ثبت زمان ۴۴ میلیثانیه در معیار p50 TTFS، رتبه اول سرعت را کسب کرد. این پیشرفت در سرعت پردازش، یادآور دستاوردهای اخیر در این حوزه است، مانند مدل MAI-Transcribe-2 مایکروسافت که توانست یک ساعت صوت را در ۱۰ ثانیه پردازش کند. بر اساس مستندات Coval، این مدل در زمینه نرخ خطای کلمه (WER) — که شبیه به شمارش غلطهای املایی در یک دیکته است — با ۳.۶٪ در رتبه دوم قرار دارد و تنها ۰.۱٪ با مدل AssemblyAI Universal 3.5 Pro فاصله دارد، اما در قیمتگذاری پیروز مطلق است. با این حال، در دنیای مدلهای ASR باید مراقب بود که برخی مدلها با «تقلب در بنچمارک» دقتهای کاذبی را گزارش کنند که لزوماً در دنیای واقعی تکرار نمیشود.
هزینه استفاده از این مدل ۰.۱۲ دلار به ازای هر ساعت است که تقریباً ۳.۷۵ برابر ارزانتر از Universal 3.5 Pro و ۲.۴ برابر ارزانتر از Deepgram Nova 3 است. همچنین Nari Labs یک نسخه Standard با قیمت کاهشیافتهتر (۰.۰۶ دلار در ساعت) ارائه میدهد.
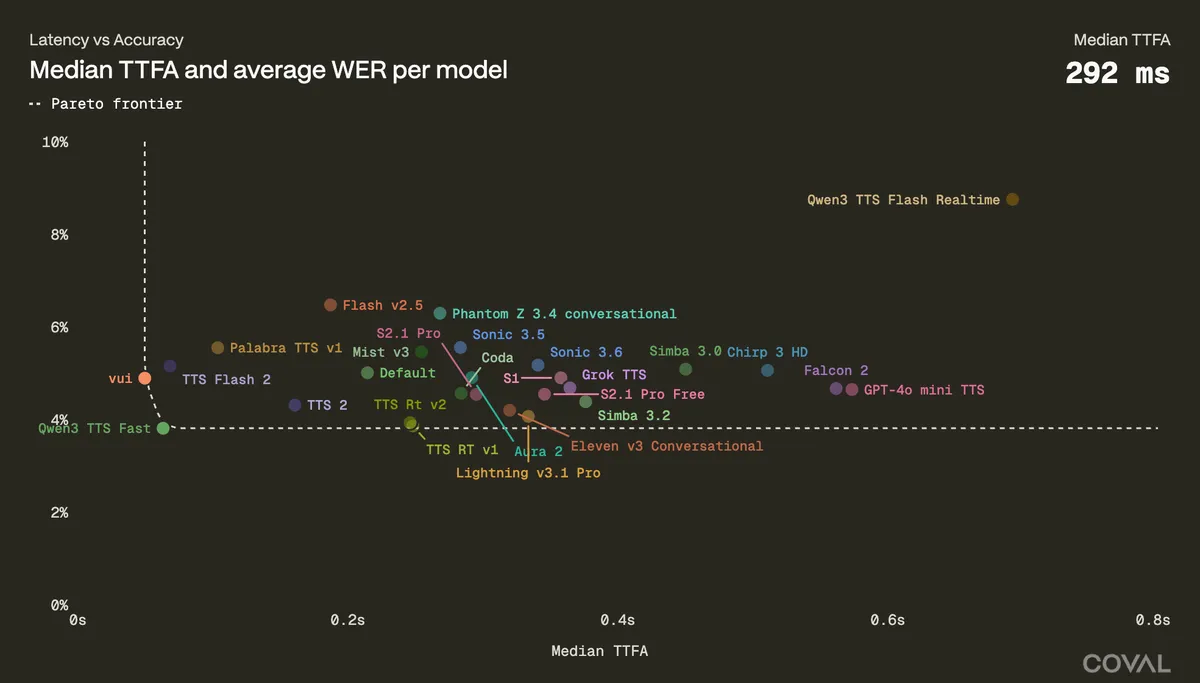
در مقابل، مدل Qwen3-TTS Fast در بخش تبدیل متن به گفتار، با کمترین نرخ خطای کلمه (۳.۸٪) رتبه اول کیفیت را به دست آورد. این مدل در سرعت نیز با ۶۳ میلیثانیه در رتبه دوم قرار گرفت و تنها از یک مدل کوچکتر ۳۰۰ میلیون پارامتری متعلق به Fluxions عقب ماند.
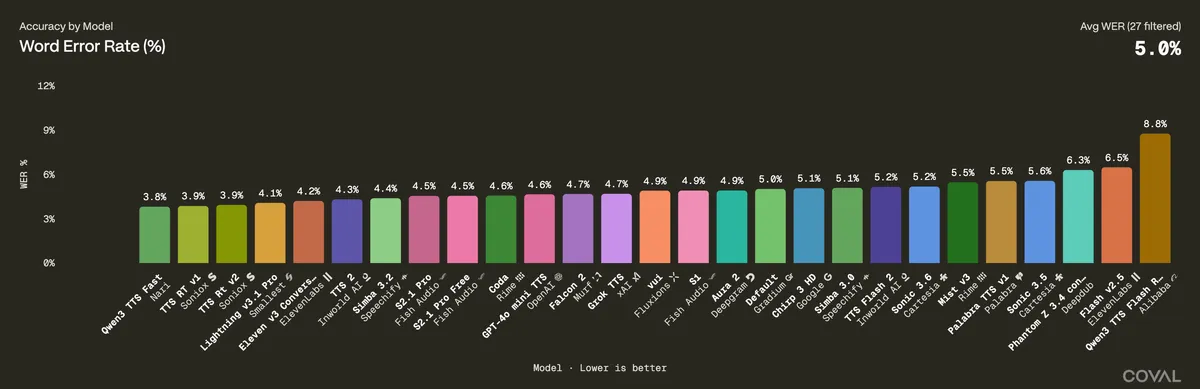
تفاوت اصلی در اینجا باز هم هزینه است. با قیمت ۱۰ دلار به ازای هر یک میلیون کاراکتر, Nari Labs در ارزانترین سطح بازار قرار دارد. در حالی که مدل ElevenLabs Eleven v3 Conversational پنج برابر و Cartesia Sonic 3.6 شش و نیم برابر گرانتر هستند.
این شکاف عملکردی زمانی عجیبتر میشود که به مدلهای همخانواده نگاه کنیم. به گزارش Coval، مدل رسمی Qwen3 TTS Flash Realtime تأخیر میانگین ۶۹۲ میلیثانیهای و نرخ خطای ۸.۸٪ را ثبت کرد. این یعنی Nari Labs توانسته است لایه استنتاج (Inference) — یعنی همان لحظه تولید جواب که شبیه به پخت غذا پس از یادگیری دستور پخت است — را بهشدت بهینه کند.
برای کسبوکارها، این تغییر یعنی دستیارهای صوتی با کیفیت بالا دیگر کالایی لوکس و وابسته به اعتبارهای گرانقیمت API نیستند. حذف سد مالی برای مقیاسدهی رابطهای صوتی در زمان واقعی، مسیر را برای استقرار گستردهتر این فناوری هموار میکند.
توسعهدهندگان در حال حاضر میتوانند این مدلها را بهصورت رایگان آزمایش کنند، هرچند Nari Labs در همین هفته دسترسیهای بتا را به مدل تجاری (GA) تغییر میدهد.
گام بعدی شما
- اگر در حال توسعه اپلیکیشنهای صوتی هستید، مدلهای Qwen3-ASR را با مدلهای فعلی خود از نظر هزینه-به-کیفیت مقایسه کنید.
- برای کاهش نرخ ریزش کاربران در چتهای صوتی، تأخیر TTFA را به زیر ۱۰۰ میلیثانیه برسانید.
- مدلهای رایگان Nari Labs را پیش از تبدیل شدن به مدل پولی در هفته جاری تست کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو