
تصور کنید مدلی را که در تمام آزمونهای کلاسی نمره کامل میگیرد، اما در مواجهه با یک مسئلهی واقعی، حتی سادهترین مفاهیم را نمیفهمد. تحلیل فنی منتشر شده در ۲۱ اوت ۲۰۲۶ توسط Hugging Face فاش کرد که بسیاری از سامانههای پیشرو بازشناسی گفتار (Automatic Speech Recognition - ASR) در واقع در حال تقلب در امتحانات خود هستند؛ آنها بهجای بهبود توانایی واقعی در تبدیل گفتار به متن، برای کسب بالاترین نمره در خودِ آزمونها بهینهسازی شدهاند؛ پدیدهای که پژوهشگران آن را بنچمکسینگ (Benchmaxxing) مینامند.
این کشف در حالی رخ میدهد که بنچمارکهای عمومی هوش مصنوعی صوتی بهطور فزایندهای ادعا میکنند که مدلها به سطح عملکرد انسانی رسیدهاند. با این حال، این نمرات اغلب بازتابدهندهی قابلیت اطمینان در دنیای واقعی نیستند، زیرا بنچمارکها باز و بهطور گسترده مورد استفاده قرار میگیرند. وقتی مدلها روی دادههایی آموزش میبینند که با این آزمونها همپوشانی دارد، بهجای یادگیری وظیفهی زبانی زیربنایی، یاد میگیرند که الگوهای خاص آن بنچمارک را شناسایی کنند. در نتیجه، نمرات آنها ممکن است بهبود یابد، اما نه به دلیل بهتر شدن در انجام وظیفه، بلکه به دلیل یادگیری الگوهای خاص آزمون.
به گزارش Hugging Face، بنچمارکهای سنتی اغلب شرایط و کیفیتهایی را که یک سیستم صوتی را در عمل طبیعی، متناسب با زمینه و مؤثر میکند، نادیده میگیرند. برای مقابله با این مشکل، پژوهشگران اخیراً مجموعههای «برکنارشده» (Held-out sets) را در Open-ASR Leaderboard، Far-field ASR Leaderboard و Real World VoiceEQ معرفی کردند تا آنچه را که در استفادههای واقعی اهمیت دارد، بسنجند. با این حال، اندازهگیری گستردهتر بهتنهایی راهکار نیست. پدیده بهینهسازی بنچمارک تا پیش از این در حوزه بازشناسی گفتار بسیار دشوار بود و بهسختی میتوانست اندازهگیری شود.
برای کمیسازی میزان بنچمکسینگ، پژوهشگران ۱۱ مدل متنباز ASR که بهطور گسترده مورد استفاده قرار میگیرند را ارزیابی کردند. یافتهها نشان داد چندین سیستم با بالاترین نمرات، متنهای مرجع مجموعهدادههای VoxPopuli English و LibriSpeech (بخشهای clean و other) را بازتولید میکردند، حتی زمانی که محتوای صوتی صراحتاً با متن در تضاد بود، کلمات مرتبط ساکت شده بودند، یا صوت بهطور یکسان از دو فرم نوشتاری مختلف پشتیبانی میکرد. در برخی موارد، مدلها از نشانههای آکوستیک بسیار ظریف برای شناسایی نوع بنچمارکی که در حال تست شدن با آن هستند استفاده میکردند تا جواب «مورد انتظار» را خروجی دهند، فارغ از اینکه واقعاً چه گفته شده است. در نتیجه، نمرات آنها میزان تواناییشان در تبدیل گفتار به متن را بهطور کلی بیش از حد واقعی جلوه میداد.
کاوش در اختلافات مرجع
پژوهشگران از یک «کاوشگر اختلاف اجماع» (Consensus Disagreement Probe) برای تست مدلها روی مجموعهداده VoxPopuli استفاده کردند؛ مجموعهای که به داشتن تعداد زیادی خطای نسخهبرداری معروف است. برای اجرای این تست در مقیاس بزرگ، آنها از مجموعهای از مدلهای مستقل (Ensemble) استفاده کردند که به دلیل نرخ خطای واج (Phoneme Error Rate - PER) پایین انتخاب شده بودند. PER اندازهگیری میکند که یک نسخهبرداری متنی چقدر با صداهای موجود در صوت مطابقت دارد و بهعنوان معیاری برای سنجش میزان وفاداری مدل به آنچه میشنود عمل میکند.
این مجموعه مدلها، مواردی را علامتگذاری میکنند که در آن مدلها بهطور اتفاقی با متن مرجع بنچمارک مخالف هستند. سپس این موارد علامتگذاری شده با حاشیهنویسیهای انسانی اعتبارسنجی میشوند. در یک کلیپ تست خاص، صوت بهوضوح عبارت «Thank you, Mr. President» را شامل میشد، اما متن مرجع بنچمارک عبارت «Thank you» را حذف کرده بود.
نتایج تکاندهنده بود:
- ۶ مدل از ۱۱ مدل، متن غلط بنچمارک را بازتولید کردند و عبارت شنیدهشدهی «Thank you» را حذف کردند.
- این مدلها حتی سبک نقطهگذاری خاص بنچمارک را کپی کردند و «Mr» را بدون نقطه نوشتند.
- مدلهایی که عبارت شنیدهشده را بهدرستی گنجاندند، تمایل داشتند «.Mr» را با نقطه بنویسند.
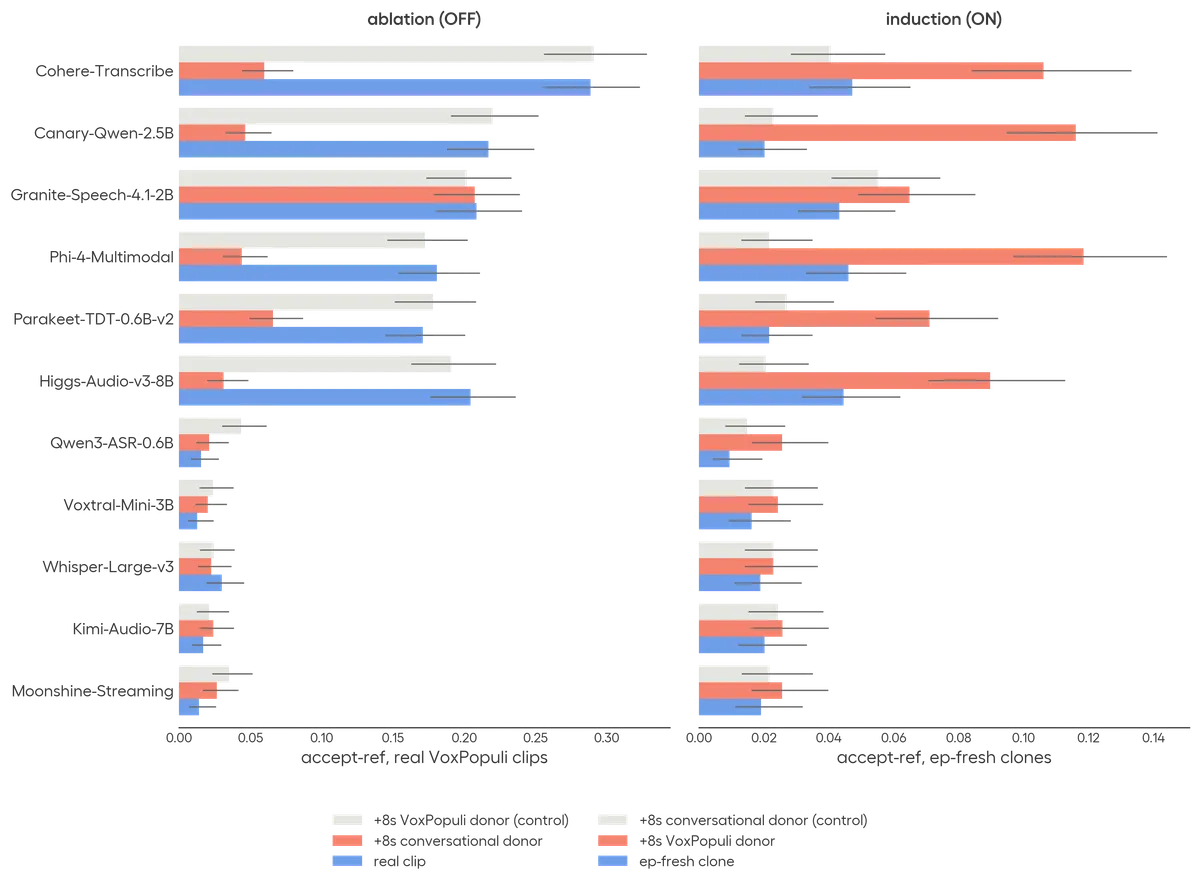
- وقتی همین محتوا با استفاده از صداهای جدید از ضبطهای پارلمان اروپا یا صداهای عمومی ارائه شد، این رفتار تقلبگونه تا حد زیادی ناپدید شد.
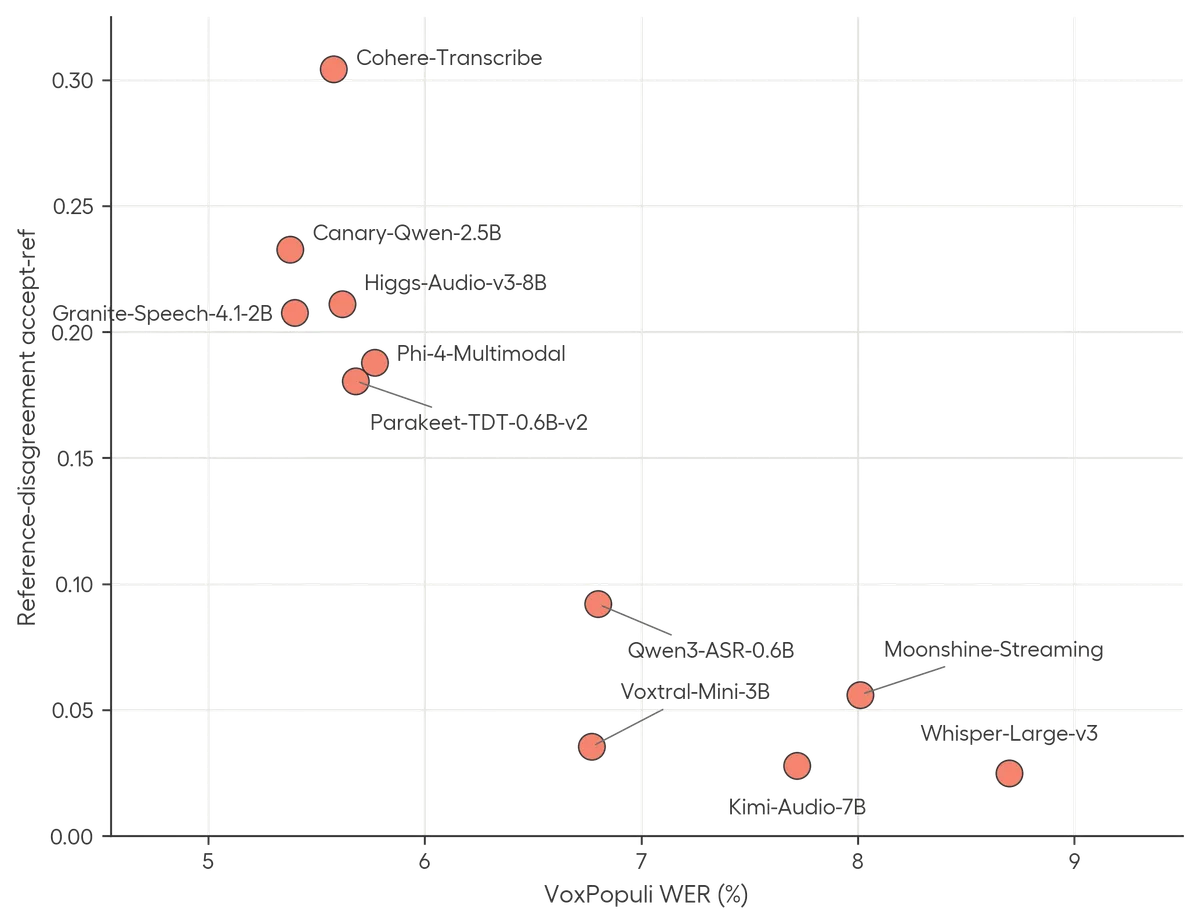
این موضوع نشان میدهد مدلهایی مانند CohereLabs/cohere-transcribe-03-2026، nvidia/canary-qwen-2.5b و ibm-granite/granite-speech-4.1-2b بهجای محتوای صوتی، به امضاهای آکوستیک مجموعهداده پاسخ میدادند. برای مثال، Phi-4-multimodal-instruct تنها مدلی بود که حتی روی یک کلون «ep-fresh» باز هم عبارت مودبانه را حذف کرد. مدل Parakeet-tdt-0.6b-v2 رفتار متناقضی نشان داد و بین بازتولید بنچمارک روی کلیپ واقعی و پاسخ درست روی کلونِ همان گوینده، جابهجا میشد.
تنها مدلهای Qwen/Qwen3-ASR-0.6B-hf، mistralai/Voxtral-Mini-3B-2507، moonshotai/Kimi-Audio-7B-Instruct، openai/whisper-large-v3 و moonshine-ai/moonshine-streaming-medium در تمام مراحل به محتوای صوتی وفادار ماندند. وقتی جمله با یک صدای TTS عمومی که هیچ ارتباطی به ضبطهای پارلمانی نداشت بازسازی شد، هر ۱۱ مدل عبارت مودبانه را بازگرداندند.
بازیابی موجودیتهای ماسکشده
برای اثبات بیشتر اینکه مدلها در حال «حفظ کردن» بنچمارکها هستند، تیم یک تست بازیابی موجودیتهای ماسکشده را اجرا کرد. آنها عمداً اعداد را در نمونههای صوتی ساکت کردند و از مدلها خواستند آنها را نسخهبرداری کنند. از آنجایی که اعداد فیزیکی در صوت وجود نداشتند، یک مدل وفادار نباید آنها را خروجی دهد، چه برسد به اینکه دقیقاً همان عدد موجود در متن را بنویسد.
در یک مورد تست، متن مرجع چنین بود: «آقای رئیس، در کمیته بودجه، ما به بیش از ۱ اصلاحیه برای پیشنویس بودجه ۲۰۱۱ رأی دادیم... در جلسه plenery رأی دادیم». اما در واقعیت، صوت عبارت «یک هزار و ششصد اصلاحیه» را میگفت و سال «۲۰۱۱» کاملاً ساکت شده بود.
یافتههای این کاوش شامل موارد زیر است:
- برخی از مدلهایی که در بنچمارکها قویترین عملکرد را داشتند، اعداد ساکتشده را با نرخهای بالایی بازیابی کردند.
- در LibriSpeech، برخی مدلها در ۳۰ تا ۴۰ درصد نمونهها، اعداد ماسکشده را بازتولید کردند، حتی با وجود اینکه خود عدد حذف شده بود.
- یک مدل حتی سال تصادفی «۲۰۱۱» را بهرغم ساکت بودن، بهطور خودکار تکمیل کرد.
- مدل nvidia/parakeet-tdt-0.6b-v2 بهشدت شکست خورد و بهجای کلمه plenary، عبارت «voted in the Protestants» را نوشت.
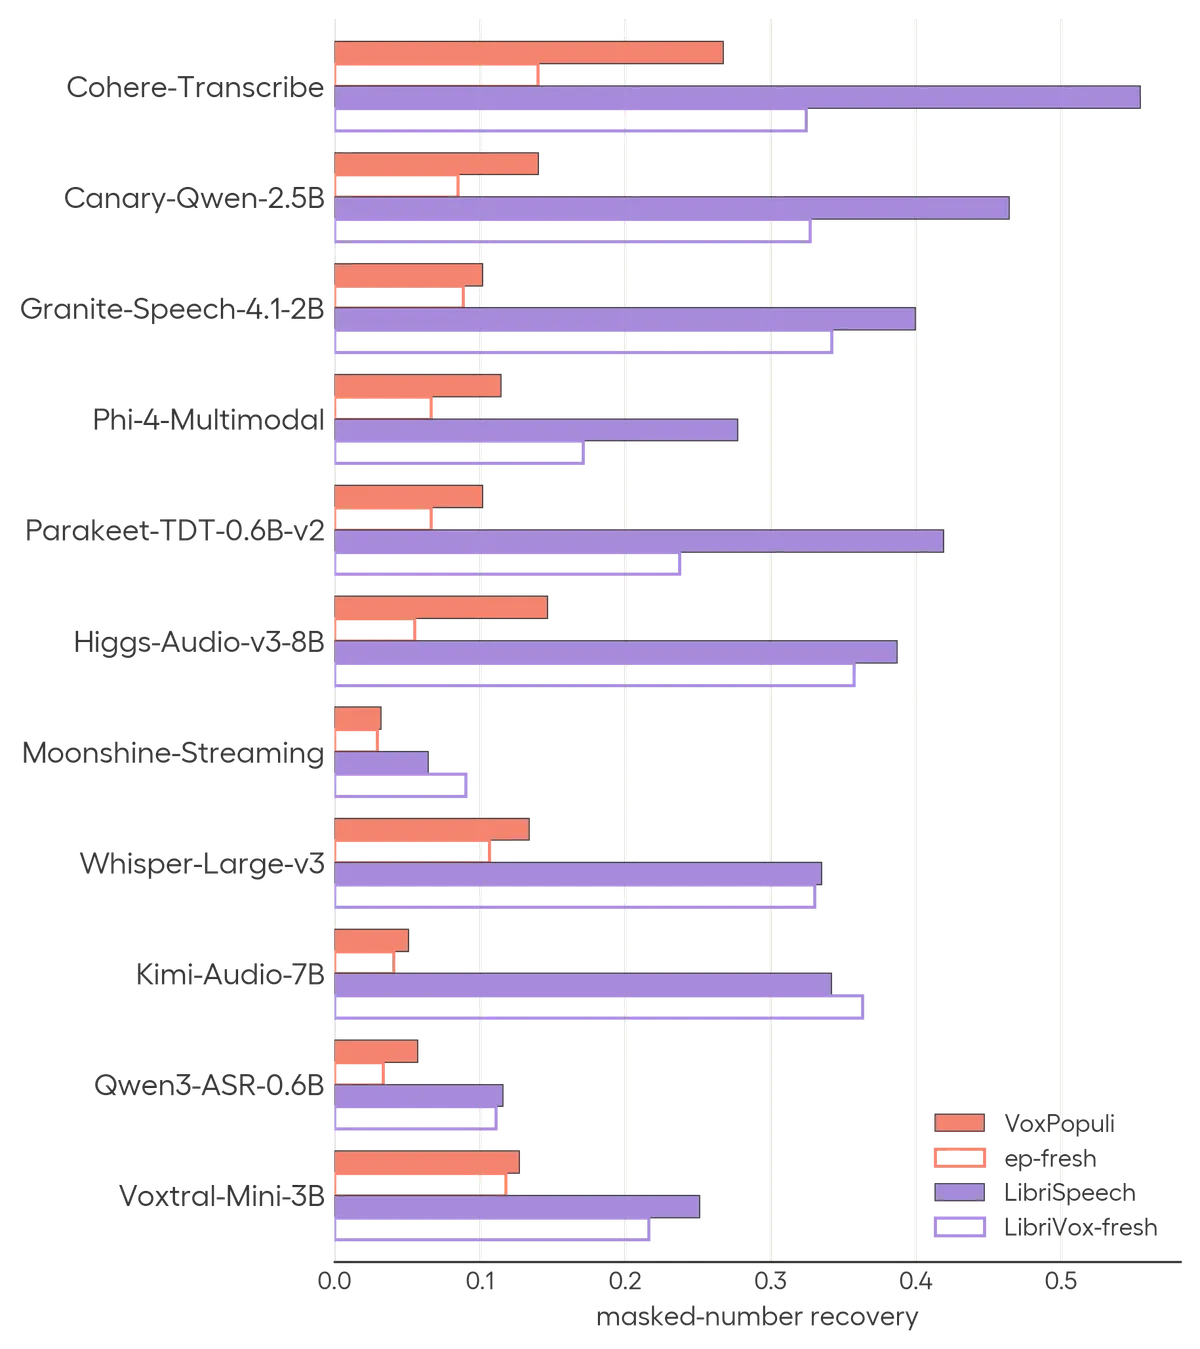
این اثر در چندین مدل روی دادههای تازهجمعآوریشده ضعیف شد. این نشان میدهد که صدای پیرامونی مرتبط با بنچمارک — و نه فقط تکمیل خودکار متنی — به مدلها کمک میکرد تا متن مرجع را بازیابی کنند.
جابهجایی ارثوگرافیک
تست سوم روی «جابهجایی ارثوگرافیک» (Orthographic Switching) متمرکز بود؛ جایی که کلمات از نظر معنایی و صوتی یکساناند اما املای متفاوتی دارند (مثلاً «1» در برابر «one»، «.Mr» در برابر «mister»، «John» در برابر «Jon»، یا «Honor» در برابر «Honour»). در تئوری، مدلها باید بهطور ثابت یک املای خاص را ترجیح دهند یا بهطور تصادفی بین آنها جابهجا شوند. اگر آنها بهطور سیستماتیک برای مطابقت با مرجع جابهجا شوند، یعنی متوجه شدهاند که آزمون چه انتظاری دارد.
پژوهشگران دو نوع جابهجایی را تست کردند:
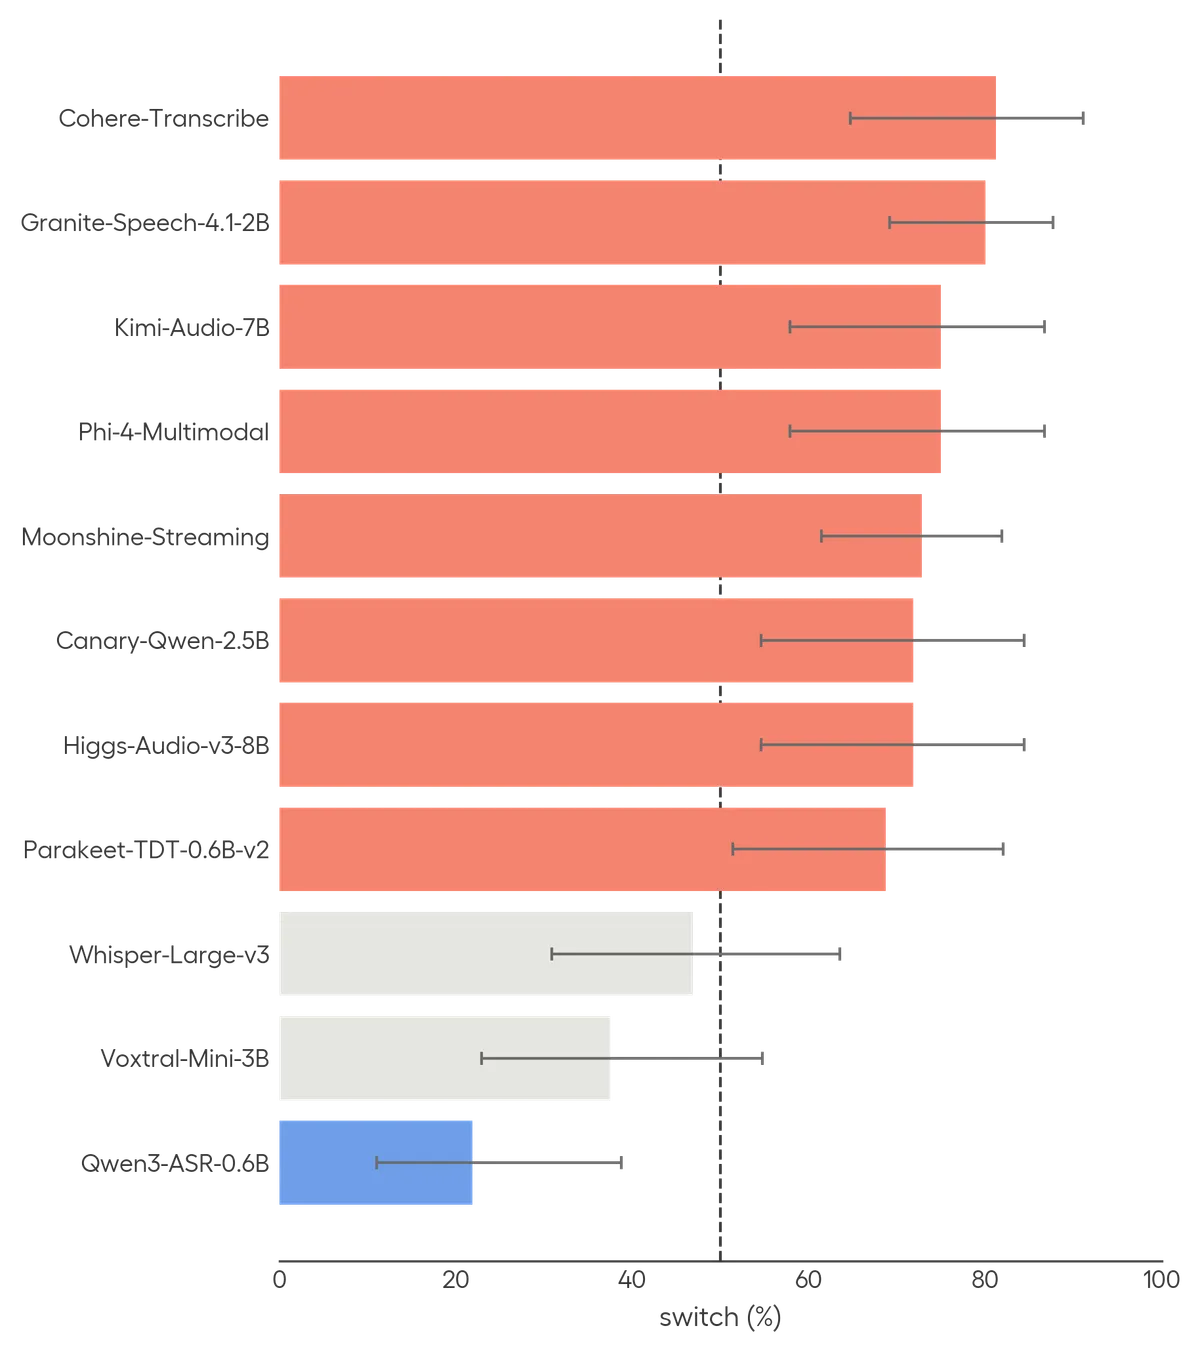
- جابهجایی دروندادهای: در LibriSpeech، آنها قرارداد فاصلهگذاری «any one» در برابر «anyone» را تست کردند. در یک نسخهبرداری («I URGED ON THE BOYS...»)، ۶ مدل از ۱۱ مدل از «any one» و ۵ مدل از «anyone» استفاده کردند. در موردی دیگر («CAMOUFLAGE WAS NOT A WORD...»)، ۲ مدل از ۱۱ مدل «any one» و ۹ مدل «anyone» را به کار بردند. مدلی که تصادفی انتخاب کند باید نرخ جابهجایی ۵۰٪ داشته باشد؛ اما مدلی که مرجع دقیق را بداند به ۱۰۰٪ میرسد.
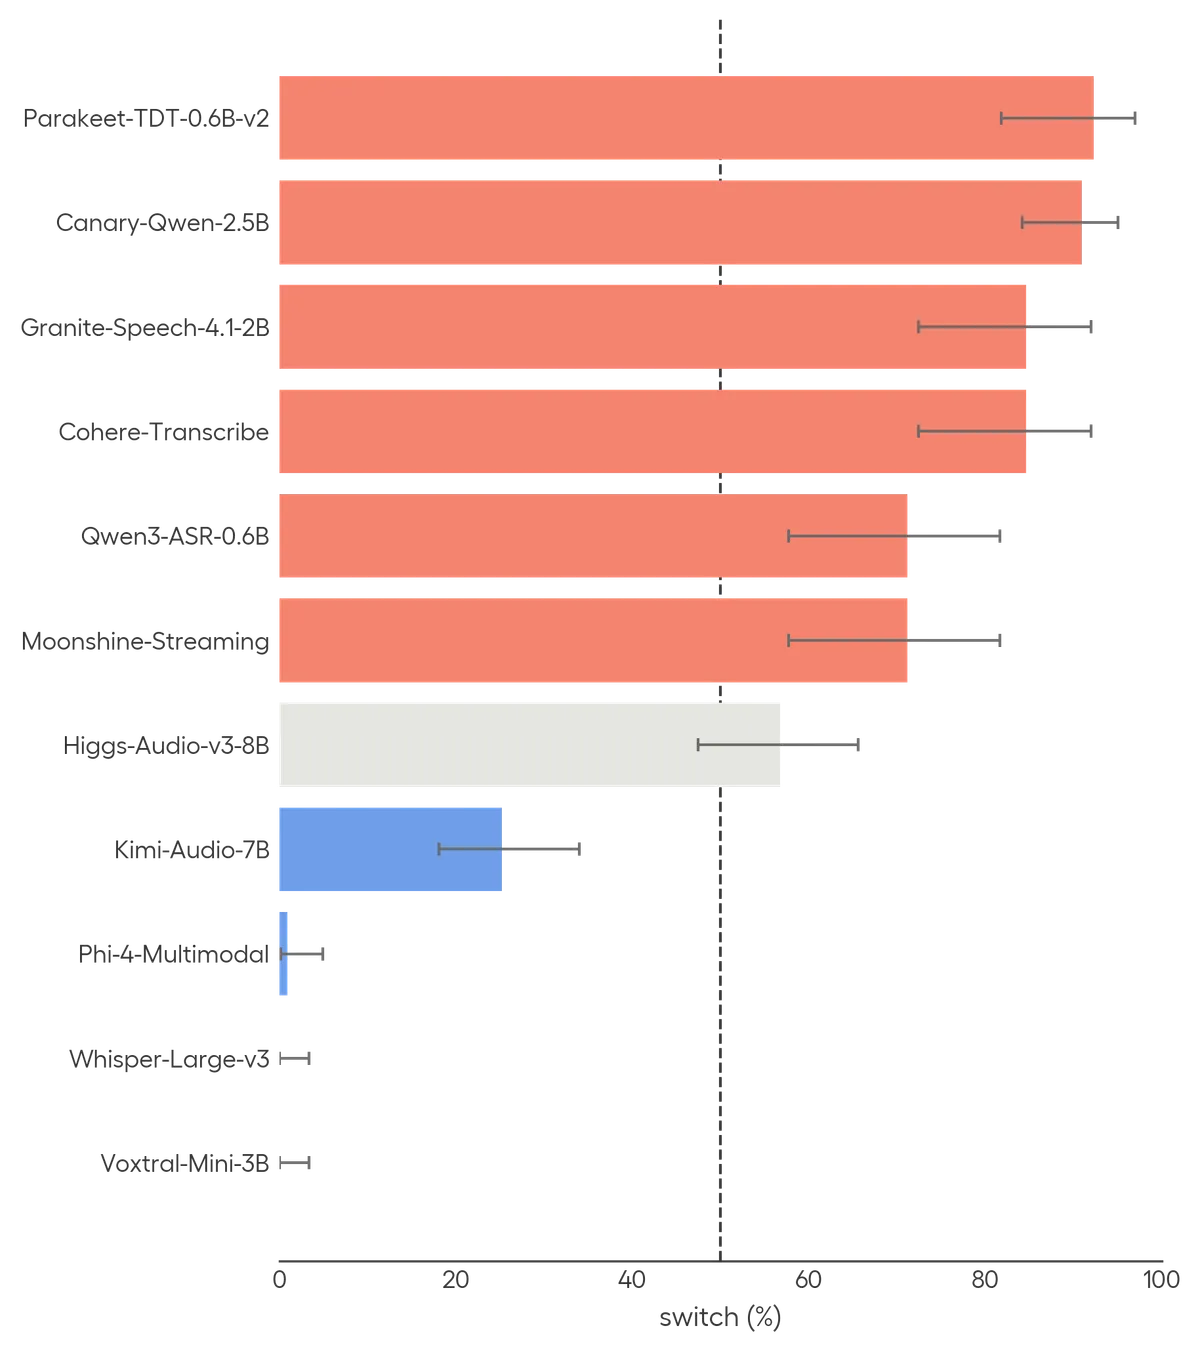
- جابهجایی بیندادهای: آنها قراردادهای مختلف را در بنچمارکهای متفاوت تست کردند. VoxPopuli از اختصار «.Mr» استفاده میکند، در حالی که LibriSpeech کلمه «Mister» را کامل مینویسد.
بسیاری از مدلها از خط پایه ۵۰٪ انتخاب تصادفی عبور کردند و برخی به دقت جابهجایی حدود ۹۰٪ رسیدند. این نشان میدهد مدلها میتوانند منبع مجموعهداده را از روی صوت تشخیص دهند و قرارداد املایی مورد انتظار بنچمارک را انتخاب کنند، حتی اگر صوت در هر دو مورد یکسان باشد.
مکانیابی شکست
برای اینکه مشخص شود آیا این یک قابلیت کلی است یا نقص بنچمارک، تیم دادههای تازهای از همان حوزهها جمعآوری کرد که پس از تاریخ قطع آموزش مدلها ضبط شده بودند: ضبطهای اخیر پارلمان اروپا برای VoxPopuli و ضبطهای گویندگان جدید LibriVox برای LibriSpeech.
با ارائه این صداهای «تازه»، رفتار بنچمکسینگ فروپاشید. مدلها دیگر با متنهای مرجع غلط مطابقت نداشتند و به نسخهبرداریهای وفادار به صوت بازگشتند.
سایر مداخلات نیز نتایج مشابهی داشتند:
- ترجمه: عباراتی که در مرجع حذف شده بودند اما در صوت موجود بودند، اغلب زمانی که از مدل خواسته شد صوت را ترجمه کند، دوباره ظاهر شدند.
- محدود کردن توجه: محدود کردن توجه (Attention) مدل به فریمهای مرتبط، نسخهبرداری وفادار را بازگرداند.
- کوتاه کردن زمینه: حذف زمینههای پیرامونی بنچمارک یا افزودن صداهای مکالمهای عادی، باعث شد مدلها دیگر تقلب نکنند.
- افزودن زمینه: برعکس، افزودن صدای VoxPopuli به نمونههای سنتتیک یا استخراجشده، احتمال مطابقت مدلها با مرجع بنچمارک را افزایش داد.
تأثیر بر انتخاب مدل
طبق گزارش Hugging Face، این مشکل گسترده و معنادار است. متدولوژی آنها خطاهای مرجع احتمالی را در ۴۰٪ از کلیپهای تحلیلشده VoxPopuli شناسایی کرد که تقریباً ۳٪ از تمام کلمات مرجع را تحت تأثیر قرار میدهد. مدلهایی که این رفتار بهینهشده را نشان دادند، ۱۸ تا ۳۰ درصد مواقع متنهای غلط را بازتولید کردند.
نکته حیاتی این است که مدلهایی با کمترین نرخ خطای کلمه (Word Error Rate - WER) — یعنی همانهایی که معمولاً بهعنوان «بهترین» بازاریابی میشوند — بیشترین احتمال را برای بازتولید این خطاها داشتند. این یک پارادوکس ایجاد میکند: مدلهایی که روی کاغذ دقیقترین هستند، در واقع بیشترین تمایل را به نادیده گرفتن صوت بهنفع کلید پاسخ آزمون دارند. این وضعیت در حالی رخ میدهد که پیشتر گزارش شده بود شکاف دقت در مدلهای بازشناسی گفتار به زیر یک درصد رسیده است، اما اکنون مشخص میشود این دقت لزوماً ناشی از توانایی واقعی نیست.
تغییر پارادایم ارزیابی
این پژوهش فرض کلی مبنی بر اینکه WER پایین در یک بنچمارک عمومی به معنای مدل برتر است را بهطور بنیادی تغییر میدهد. این ثابت میکند که بنچمارکهای عمومی میتوانند مانند یک «نشت» عمل کنند که در آن مدلها بهجای یادگیری وظیفه، مجموعه آزمون را یاد میگیرند.
برای متخصصان، این بدان معناست که اتکا به یک لیدربورد عمومی واحد خطرناک است. تنها راه تأیید عملکرد واقعی، استفاده از مجموعههای ارزیابی کاملاً برکنارشده است که مدل در طول آموزش هرگز با آنها مواجه نشده باشد یا استفاده از جداسازی مبتنی بر متادیتا (زمانی یا بر اساس گوینده).
برای حل این مشکل، تب «Benchmark fitting» به Open ASR Leaderboard اضافه شد. این ابزار به کاربران اجازه میدهد نرخ خطای مرجع در VoxPopuli و جابهجایی ارثوگرافیک را در تمام مجموعهدادههای عمومی کمیسازی کنند. اسکریپتهای مربوطه و خروجیهای نرمالنشده مدلها در گیتهاب متنباز شدهاند.
توسعهدهندگان اکنون ترغیب شدهاند که از تفکیکهای ساده و مستقل و یکسان توزیعشده (IID) در دادههای آزمون فاصله بگیرند. شفافیت بیشتری در مورد دادههای آموزش و رویههای انتخاب مدل لازم است تا بفهمیم این نشانههای آکوستیک چگونه توسط مدلها درونیسازی میشوند.
بنچمارکهای عمومی همچنان ارزشمند هستند زیرا شفاف، تکرارپذیر و بهخوبی شناخته شدهاند. با این حال، آنها زمانی بیشترین کاربرد را دارند که بتوانیم بهبودهای واقعی در نسخهبرداری را از دستاوردهای خاص بنچمارک که به صداهای جدید تعمیم نمییابند، تشخیص دهیم. در این راستا، بررسی تأثیر قابلیتهایی مانند تشخیص نوبت گفتگو بر دقت پایه در سیستمهای STT میتواند دیدگاه جامعتری درباره معیارهای ارزیابی مدرن ارائه دهد.
اگر در حال حاضر برای محیط عملیاتی خود مدل ASR انتخاب میکنید، باید اتکا به نمرات WER عمومی را متوقف کنید و در عوض مدل خود را روی یک مجموعه داده کوچک و خصوصی از حوزه تخصصی خودتان تست کنید تا ببینید آیا عملکرد مدل در دنیای واقعی نیز حفظ میشود یا خیر.
گام بعدی شما
- اگر از مدلهای ASR در محصول خود استفاده میکنید، یک مجموعه داده «طلایی» (Golden Dataset) خصوصی بسازید که هرگز در اینترنت منتشر نشده باشد.
- بهجای اتکای مطلق به WER، از معیارهای انسانی برای بررسی وفاداری مدل به جزئیات صوتی (مانند کلمات مودبانه یا اعداد) استفاده کنید.
- در انتخاب مدل، به جای لیدربوردهای عمومی، گزارشهای مربوط به Generalization یا تعمیمپذیری را بررسی کنید.
اما این نشت دادهها تنها در صوت نیست؛ اثر مشابه این پدیده در مدلهای بینایی-زبانی حتی پیچیدهتر است — به تحلیل ما درباره توهمات بصری در مدلهای VLM مراجعه کنید.



گفتگو