تصور کنید میخواهید در تاریکترین نقاط ماه، جایی که میلیاردها سال است نوری ندیدهاند، جای دقیق ذخایر یخ را پیدا کنید تا سوخت موشکهای آینده را تأمین کنید. حالا یک ابزار هوش مصنوعی وجود دارد که احتمال خطای شما در این شکار گنج را تا ۲۲ درصد در مقایسه با بهترین مدلهای پایه موجود، کاهش میدهد.
مدل بنیادی (Foundation Model) — شبیه به یک دانشآموز همهفنحریف است که ابتدا کل کتابخانه را خوانده و حالا میتواند با کمترین راهنمایی، هر مسئلهی تخصصی را حل کند — توسط ناسا (NASA) و آیبیام (IBM) معرفی شده است. این ابزار، نزدیک به دو دهه دادههای خام مشاهدهای ماه را به یک زیرساخت آماده برای یادگیری ماشین تبدیل کرده است تا علوم سیارهای متحول شود.
برای سالها، ناسا سوابق علمی عظیمی از ماه جمعآوری کرده است، اما این دادهها برای دانشمندان دشوار بود تا در مقیاس بزرگ از آنها استفاده کنند. همانطور که کوین مورفی، مدیر ارشد دادههای علمی ناسا، اشاره کرد: «ناسا دههها وقت صرف ساخت یک رکورد علمی فوقالعاده از ماه کرده است، اما جمعآوری دادهها تنها بخشی از کار است.» او میافزاید که دادهها باید برای دانشمندان کاربردیتر شوند. این انتشار مدل، نشاندهنده تغییری بنیادین از الگوریتمهای تکمنظوره به رویکرد مدلهای بنیادی است؛ سیستمی که ابتدا روی حجم عظیمی از دادههای بدون برچسب پیشآموزش میبیند و سپس با تنها چند نمونهی برچسبدار، برای کارهای خاص تنظیم میشود. این موضوع بهویژه برای تحقیقات ماه مفید است، زیرا دادههای مشاهدهای فراوان هستند اما برچسبهای دقیق برای آنها کمیاب است.
موتور دادهها: SomBench
این مدل از صفر و با استفاده از SomBench آموزش دیده است؛ بزرگترین مجموعهدادهی چندوجهی ماه تا به امروز که به صورت همثبت (co-registered) است. این مجموعه یک سنتز عظیم از ۱۷ سال مشاهدات است که عمدتاً توسط ماهوارهی LRO (مدار شناسایی ماه) جمعآوری شده است. حجم دادههای این مأموریت به تنهایی از مجموع تمام مأموریتهای سیارهای دیگر ناسا بیشتر است.
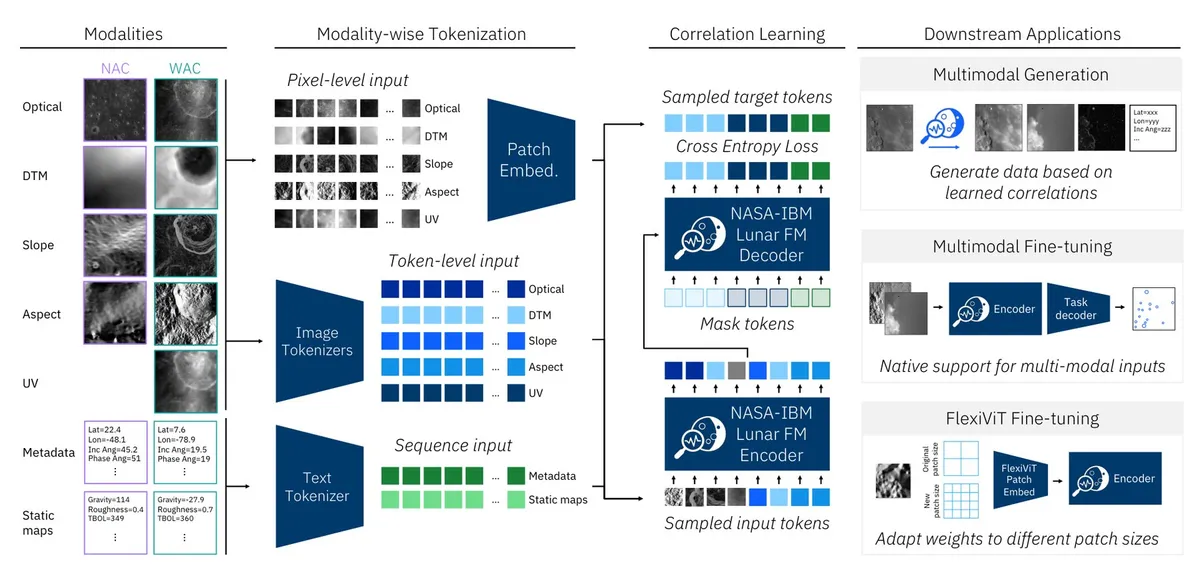
این بدنه دادهای شامل نزدیک به ۲ میلیون بسته تصویری (tile bundles) در ۱۱ حالت مختلف و در دو مقیاس مکانی است. جزئیات این دادهها عبارتند از:
- ۱ میلیون تصویر با وضوح بالا از دوربین زاویه تنگ (NAC) با دقت تقریباً ۱ متر در هر پیکسل.
- کمی کمتر از ۹۶۴ هزار تصویر چندطیفی از دوربین زاویه باز با دقت ۱۰۰ متر در هر پیکسل.
- دادههای تکمیلی از مأموریت GRAIL (برای میدان گرانشی)، Lunar Prospector (برای شناسایی هیدروژن) و کاوشگر Kaguya/SELENE متعلق به ژاپن (JAXA) برای بررسی کانیشناسی.
در مجموع، این مجموعهداده بیش از ۳۰ لایه دادهای که از نظر مکانی تراز شدهاند را از ۹ ابزار مختلف و ۴ مأموریت فضایی گرد هم آورده است. برای جلوگیری از نشت دادهها (Data Leakage) بین مراحل آموزش، اعتبارسنجی و آزمون، تیم سازنده بهجای توزیع تصادفی تکههای تصویر، کل بدنه داده را بر اساس مناطق جغرافیایی نقشه تفکیک کرد.
معماری فنی و نوآوریها
پژوهشگران بهجای تنظیم دقیق (Fine-tuning) یک مدل موجود، این سیستم را بر اساس معماری TerraMind ساختند؛ مدل مشاهده زمین که در سال ۲۰۲۵ توسط آیبیام، آژانس فضایی اروپا (ESA) و مرکز تحقیقات Jülich توسعه یافته بود. یکی از نوآوریهای حیاتی، نحوه مدیریت نورپردازی است. در ماه، زوایای تابش نور بسیار بیشتر از ویژگیهای فیزیکی واقعی سطح، بر ظاهر تصاویر تأثیر میگذارند. تیم سازنده بهجای اینکه هوش مصنوعی را مجبور کند این شرایط را از روی پیکسلهای خام حدس بزند، هندسهی تصویر — شامل موقعیت خورشید، زوایای تابش و وسعت هر تکه تصویر — را بهعنوان بستر (Context) صریح به مدل داد.
این مدل از تکنیک FlexiViT بهره میبرد که اجازه میدهد مدل بدون نیاز به آموزش مجدد، با اندازههای مختلف تکههای تصویر (patch sizes) سازگار شود. مدل، تصاویر ماه، دادههای ارتفاعی و هندسه را بهصورت توکن (Token) پردازش میکند و روابط بین آنها را از طریق پیشبینی بخشهای ماسکشده (پوشانده شده) دادهها یاد میگیرد. این مکانیسم به مدل اجازه میدهد تا تصاویر با وضوح بالا و تصاویر درشتدانه را بهطور همزمان در یک نوبت آموزش پردازش کند و هم جزئیات ریز و هم بستر گسترده را استخراج نماید.
محکهای عملکردی
این مدل در برابر مدل پایه SwinV2-B در چندین وظیفه حیاتی ماه مورد آزمایش قرار گرفت. بیشترین پیشرفت در پیشبینی ذخایر یخ قطبی مشاهده شد. مناطق قطبی که برای همیشه در سایه هستند، بهدلیل سرمای شدید، مکانهایی ایدهآل برای حفظ یخهای آبی در طول میلیاردها سال هستند و به عنوان منابع بالقوه برای آب، اکسیژن و سوخت موشک شناخته میشوند. این دستاورد در ادامه تلاشاتی است که در آن مدل Lunar در برابر استانداردهای ImageNet برای شناسایی یخهای قطبی مورد ارزیابی قرار گرفت تا برتری خود را در تحلیلهای بصری ماه ثابت کند.
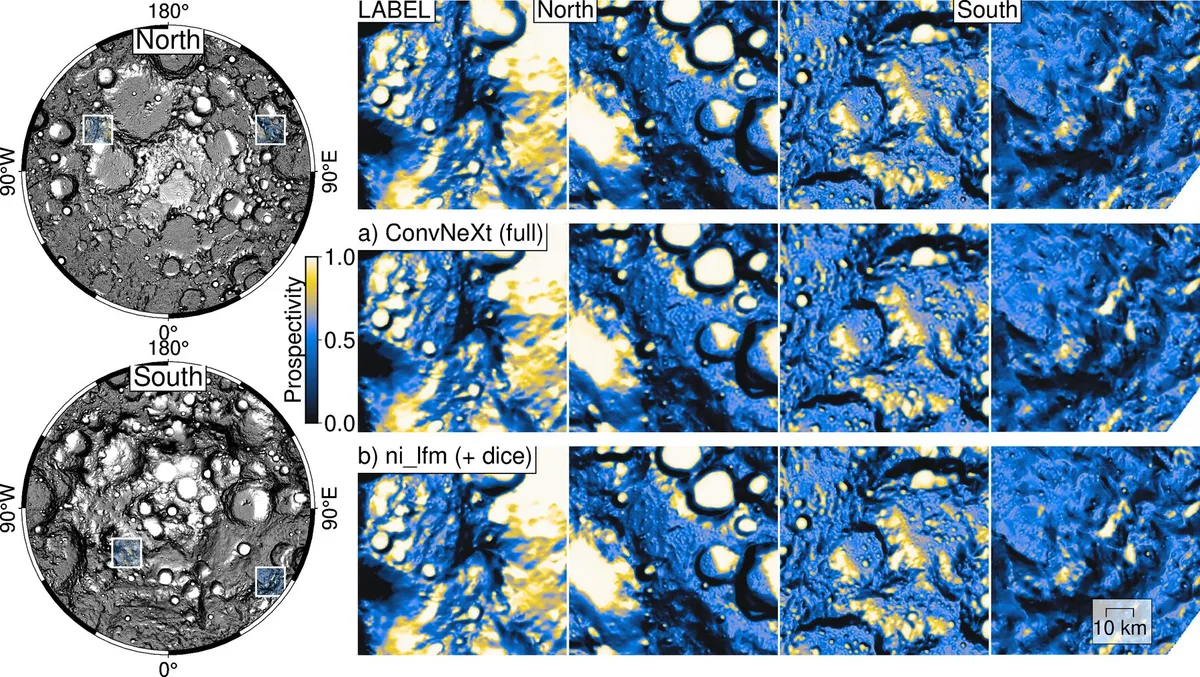
در زمینه شناسایی دهانهها، نتایج ترکیبی اما امیدوارکننده بود:
- در شناسایی مقیاسهای درشت، مدل ناسا-آیبیام نزدیک به ۱۹ درصد بهتر از SwinV2-B عمل کرد، در حالی که تنها از نیمی از دادههای برچسبدار استفاده کرده بود. این نشان میدهد مدل برای عملکرد خوب به نمونههای کمتری نیاز دارد.
- در شناسایی مقیاس متری و قطعهبندی لکههای دریایی نامنظم (IMP) — ویژگیهای آتشفشانی جوانی که جدول زمانی خنک شدن ماه را به چالش میکشند — عملکرد مدل تقریباً با قویترین مدلهای پایه برابر بود.
- در قطعهبندی IMP، آیبیام ادعا میکند که ۳ درصد برتری نسبت به SwinV2-B دارد، هرچند این نتایج با میزان نوسانات بین دفعات مختلف آموزش قابل مقایسه است.
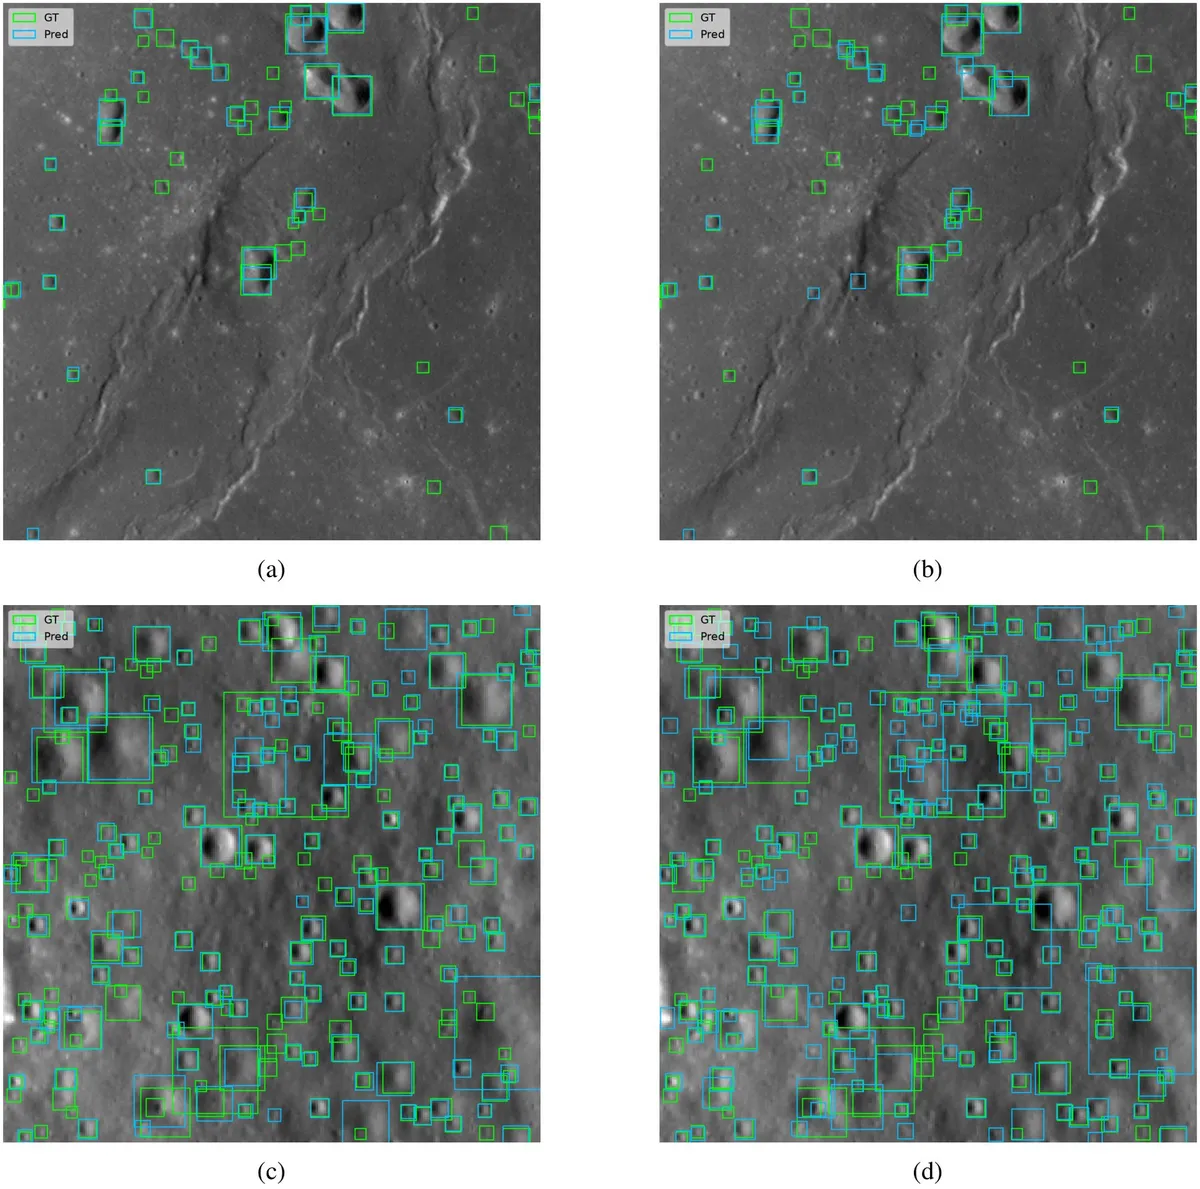
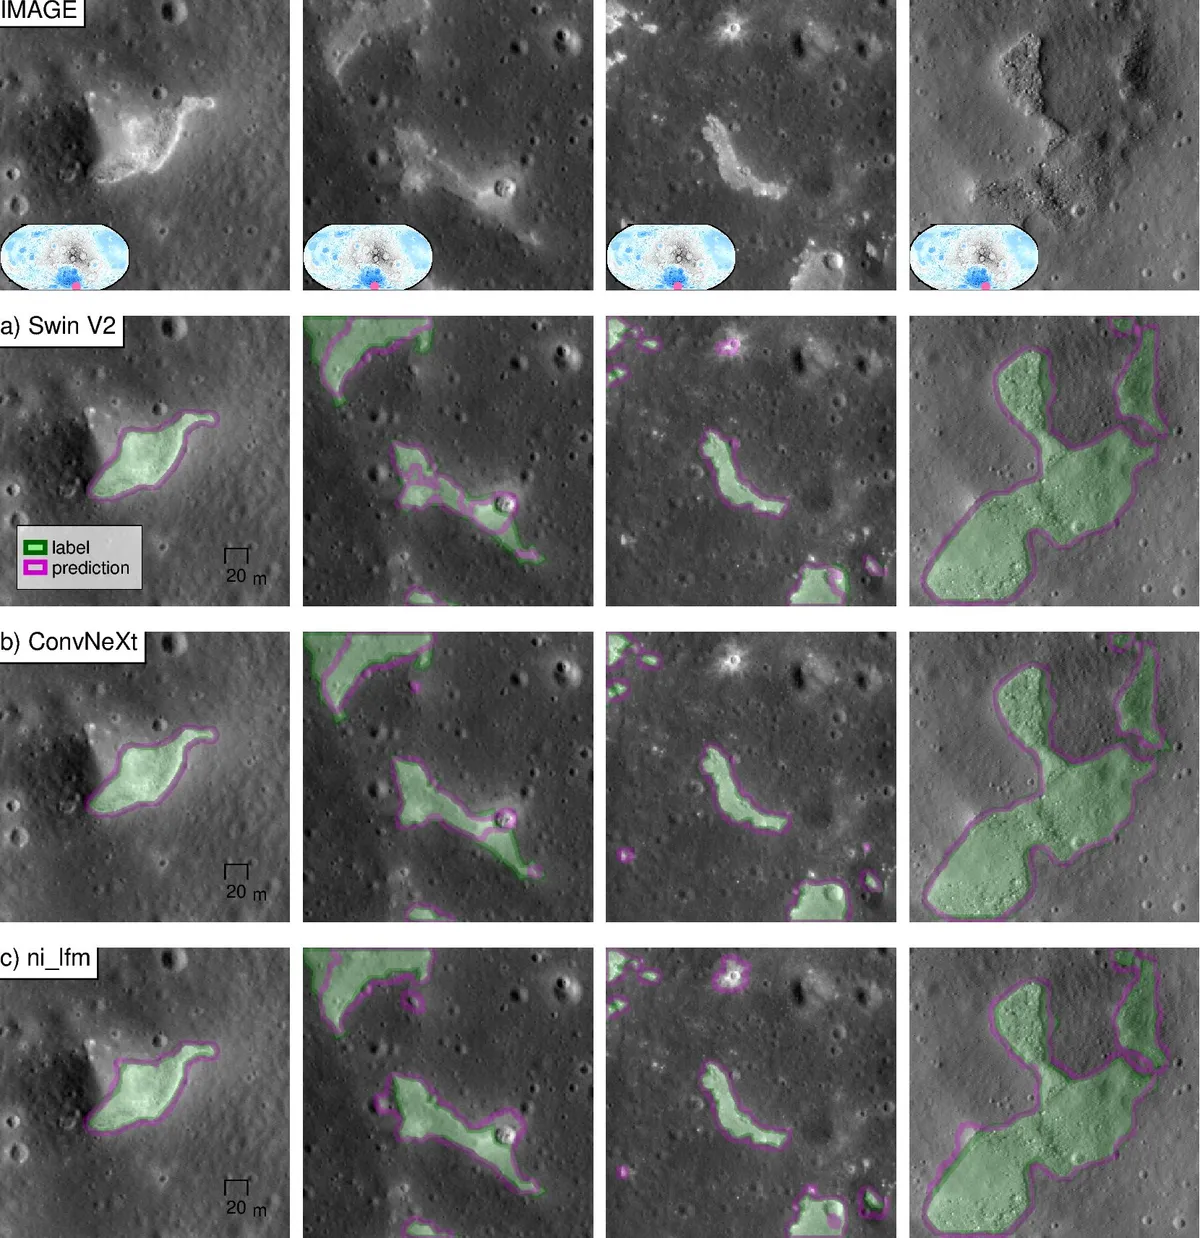
یک مزیت معماری کلیدی، مسیر پردازش است. در حالی که مدلهای پایه تمام ورودیها را بهعنوان کانالهای روی هم انباشته شده (stacked channels) میبینند، مدل ناسا-آیبیام برای هر لایه داده، یک مسیر پردازش مجزا اختصاص میدهد. این قابلیت به مدل اجازه میدهد ویژگیهای آتشفشانی در قطعهبندی IMP را شناسایی کند که هر دو مدل پایه از آن غافل شده بودند. علاوه بر این، تیم متوجه شد که روش لورا (LoRA) — یک متد تنظیم دقیق سبکتر که تنها بخشی از پارامترها را آموزش میدهد — در تمام زمینهها با تنظیم کامل (Full Fine-tuning) رقابت کرد و در شناسایی دهانهها حتی عملکرد بهتری داشت.
محدودیتها و قلمرو کاربرد
با وجود نقاط قوت، این مدل جایگزینی برای ابزارهای فیزیکی نیست. خوانه برنابه-مورنو، مدیر تحقیقات آیبیام اروپا، تأکید کرد که اگرچه مدل میتواند مشاهدات ابزارهای مختلف را برای آشکار کردن الگوهای پنهان به هم متصل کند، اما برای موقعیتیابی دقیق ژئودتیک (Geodetic Positioning) مناسب نیست.
تحقیقات محدودیتهای زیر را نشان داده است:
- در تستهای تولیدی، طول و عرض جغرافیایی در برخی موارد دهها درجه خطا داشتند.
- ساختارهای ارتفاعی ممکن است با مقادیر ارتفاع مطلق جابهجا شده باشند، حتی زمانی که شکل کلی آنها بهدرستی بازسازی شده بود.
همچنین آزمایشهای کنترلشده برای جداسازی سهم هر نوآوری هنوز در جریان است و برخی از مجموعهدادههای آزمون همچنان کوچک هستند.
استراتژی کلان «هوش مصنوعی برای علم»
این پروژه بخشی از یک همکاری گستردهتر تحت عنوان «هوش مصنوعی برای علم» بین ناسا و آیبیام است که بر اساس یک توافقنامه Space Act از اوایل سال ۲۰۲۲ آغاز شد. این گام پس از انتشار مدل Prithvi در اوت ۲۰۲۳ برداشته شد؛ مدلی برای نقشهبرداری از سیل و آتشسوزی که روی تصاویر Landsat و Sentinel-2 از ایالات متحده آموزش دیده و در پلتفرم Watsonx ادغام شده بود. این رویکرد در سایر همکاریهای ناسا نیز دیده میشود، برای مثال مدل MAPL-EMIT گوگل توانست ۲۳ هزار منبع نشت متان را شناسایی کند که نشاندهنده قدرت مدلهای بنیادی در شناسایی پدیدههای محیطی در مقیاس وسیع است.
این مدل ماه اکنون بهصورت عمومی در Hugging Face در دسترس است، کدهای آن در GitHub قرار دارد و با ابزار TerraTorch یکپارچه شده است. تیم سازنده همچنین مجموعهدادههای پیشآموزش آماده برای یادگیری ماشین و مجموعههای محک (Benchmark) را منتشر کرده است. این تلاش مشابه روندهای صنعتی دیگر است، مانند AlphaEarth Foundations گوگل دیپمایند که تصاویر راداری، لیدار و نوری را به بردارهای معنایی (Embeddings) فشرده از سطح زمین تبدیل میکند.
این تغییر مسیر به سمت مدلهای بنیادی متنباز برای علوم سیارهای به این معناست که پژوهشگران دیگر مجبور نیستند برای هر ویژگی ماه، یک هوش مصنوعی را از صفر بسازند. با ارائه یک پایه پیشآموزشدیده، ناسا و آیبیام سد ورود برای کشف یخهای آبی و تاریخچه آتشفشانی ماه را شکستهاند.
گام بعدی شما
- اگر پژوهشگر داده هستید، مدل را از Hugging Face دریافت کرده و روی مجموعهدادههای کوچکتر خود تست کنید.
- مستندات TerraTorch را برای یادگیری نحوه ترکیب دادههای چندوجهی در علوم سیارهای مطالعه کنید.
- نتایج مدل را با دادههای مأموریتهای جدیدتر ماهوارهای مقایسه کنید تا میزان تعمیمپذیری آن را بسنجید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو