
اگر امروز در نتفلیکس فیلم تماشا میکنید، احتمالاً متوجه شدهاید که پیشنهادات این سرویس هر روز دقیقتر میشوند. اما پشت این دقت، یک تغییر بنیادین در حال رخ دادن است: جایگزینی هزاران خط کد دستی با یک مدل زبانی که رفتار شما را مثل یک گفتگو میفهمد.
به گزارش وبلاگ فنی نتفلیکس در ۲۲ اوت ۲۰۲۶، سامانه جدیدی به نام GenRec توانسته است کیفیت رتبهبندی محتوا را نسبت به سیستمهای قدیمی بهبود ببخشد. این مدل بهجای استفاده از بردارهای عددی خشک، رفتار کاربر را به شکل یک مکالمه تحلیل میکند.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، انتقال به مدلهای زبانی در مقیاس صنعتی همواره با چالشهایی همراه است. نتفلیکس سالهاست که بر مهندسی ویژگی (Feature Engineering) — شبیه به نوشتن یک دفترچه دستورالعمل بسیار طولانی برای یک آشپز که دقیقاً بگوید چه زمانی نمک بزند — تکیه کرده است. در این روش، مهندسان باید هزاران قانون دستی برای عادتهای کاربر و ویژگیهای هر اثر تعریف کنند. این رویکرد بسیار صلب است و مقیاسبندی آن بسیار گران و سخت است.
برای مثال، وقتی نتفلیکس میخواست فرمتهای جدیدی مثل ورزشهای زنده، پادکستها یا بازیها را اضافه کند، سیستم قدیمی نیازمند بهروزرسانیهای دستی گستردهای بود تا بتواند این انواع جدید محتوا را شناسایی کند. همچنین، این ساختار باعث میشد گسترش قابلیتها به بخشهای جدید از رابط کاربری نتفلیکس دشوار شود.
مدلهای زبانی آماده (Off-the-shelf) هم راهکار آمادهای نبودند؛ چون این مدلها تمایل داشتند بیش از حد روی محتواهای محبوب تمرکز کنند، قوانین تجاری شرکت را نادیده بگیرند و عناوینی را اختراع کنند (توهم بزنند) که اصلاً در کاتالوگ موجود نبودند. به همین دلیل GenRec طراحی شد تا این شکاف را پر کند.
سازوکار GenRec ساده اما هوشمندانه است: تاریخچه تماشا و بستر کاربر را به متن ساده تبدیل میکند. حالا تماشای یک فیلم، لایک کردن (thumbs-up)، مدت زمان تماشا، اضافه کردن به لیست و حتی لحظه قطع کردن ویدیو، به جای فرمولهای ریاضی پیچیده، به شکل یک دیالوگ زبان طبیعی بین کاربر و هوش مصنوعی در میآید.
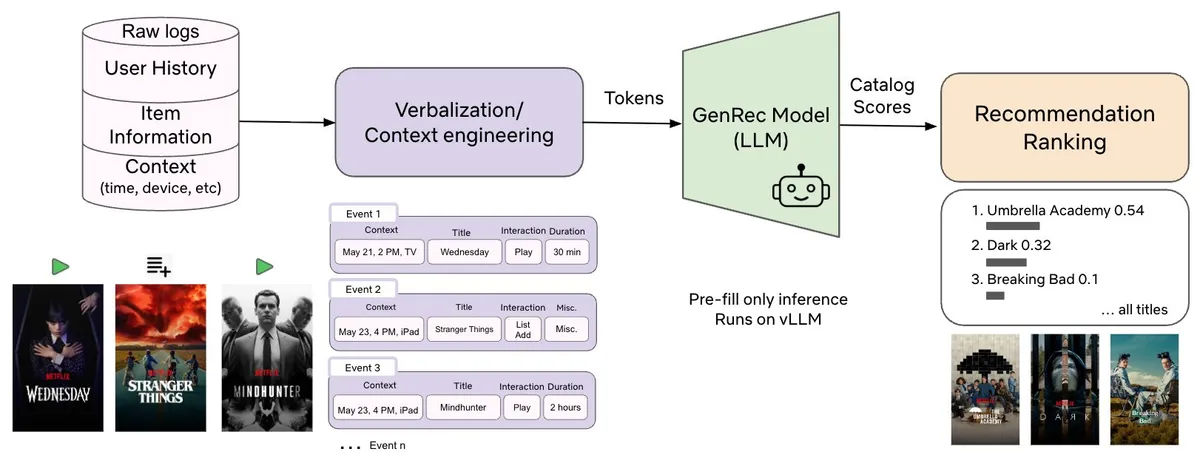
این مدل بهطور خودکار الگوهایی مثل ترجیحات ژانری یا تغییر سلیقه کاربر در طول زمان را میشناسد و دیگر نیازی نیست مهندسان این موارد را از طریق ویژگیهای مهندسیشدهی دستی تعریف کنند. عملیات در دو مرحله متمایز انجام میشود:
- مرحله اول: یک مدل زبانی بزرگ (LLM) با وزنهای باز (Open Weights) — یعنی دستور پخت مدل علناً منتشر شده و نه فقط غذای آماده — روی دادههای اختصاصی نتفلیکس تنظیم دقیق (Fine-tuning) میشود تا کاتالوگ و رفتار کاربران را بهطور کامل یاد بگیرد.
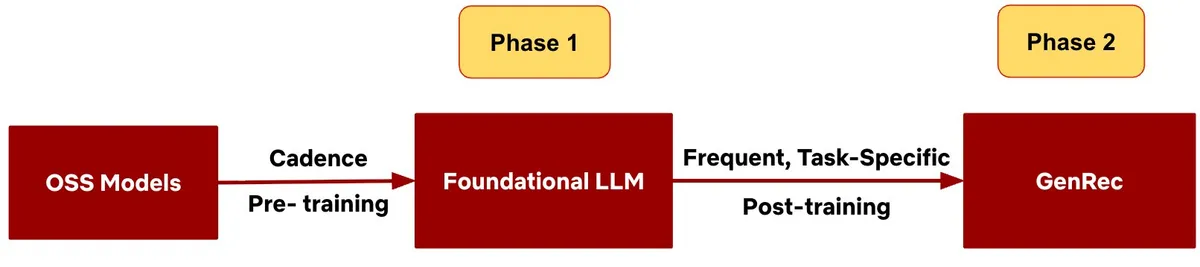
- مرحله دوم: مدل تحت یک آموزش تخصصی قرار میگیرد تا به یک رتبهبند (Recommendation Ranker) تبدیل شود. این مرحله بهطور مکرر بهروزرسانی میشود تا عناوینی که تازه اضافه شدهاند و تغییرات سریع سلیقه کاربران را لحاظ کند.
برای جلوگیری از توهم (Hallucination) — وقتی مدل با اطمینان چیزی میگوید که وجود ندارد، مثل دوستی که خاطرهای را اشتباه تعریف میکند — نتفلیکس یک بخش امتیازدهی جداگانه اضافه کرده که فقط عناوینی را تأیید میکند که واقعاً در کاتالوگ موجود هستند. همچنین برای مدیریت پنجره متنی (Context Window) — میزان متنی که مدل همزمان در ذهن نگه میدارد، شبیه میز کاری که جای چند ورق دارد — از فیلترهای شدید استفاده میکنند.
در این سیستم، رویدادهای با سیگنال بالا مثل جلسات تماشای طولانی با جزئیات کامل حفظ میشوند، اما ضربههای کوتاه یا اسکرولهای سریع حذف شده و جلسات تماشای متوالی (Binge sessions) فشرده میشوند.
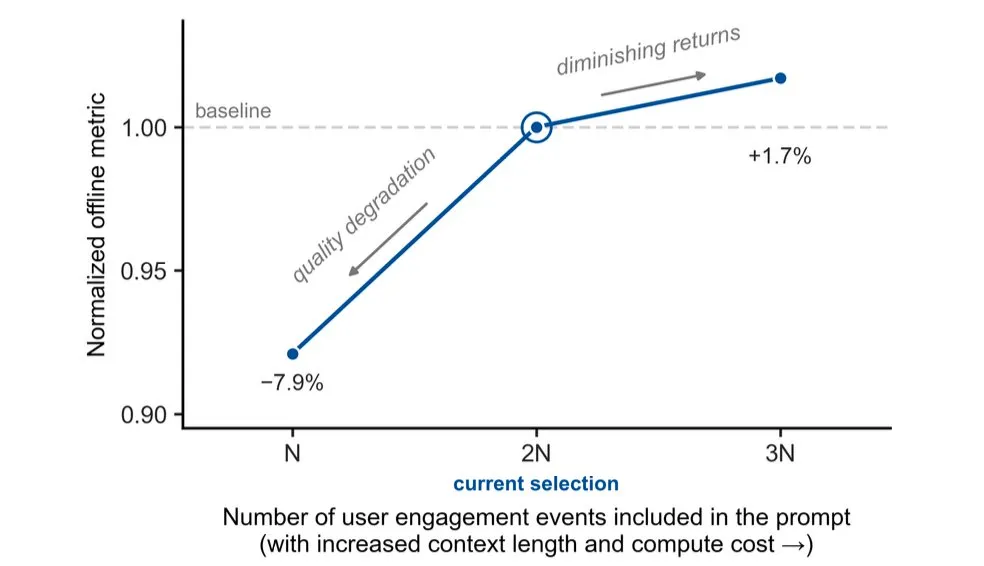
نتفلیکس دریافت که فراتر از یک طول متنی خاص، هر رویداد اضافی در ورودی (Prompt) بهسختی کیفیت رتبهبندی را بهبود میبخشد اما هزینه محاسباتی را افزایش میدهد. بنابراین برای مدیریت هزینهها، GenRec روی vLLM اجرا میشود. مدل ورودی را یکبار میخواند و تمام کاندیداها را در یک مسیر (Single Pass) رتبهبندی میکند، بدون اینکه نیاز باشد متنی تولید کند.
نتایج بهدستآمده طبق مستندات فنی، از نظر آماری معتبر هستند. در تستهای آفلاین، کیفیت رتبهبندی ۱.۶ درصد بهبود یافت. نکته کلیدی این است که GenRec برای رسیدن به این نتیجه، تقریباً ۴۰ برابر دادههای برچسبدار کمتری در مرحله دوم آموزش نیاز داشت تا آنچه سیستم تولیدی فعلی نیاز دارد.
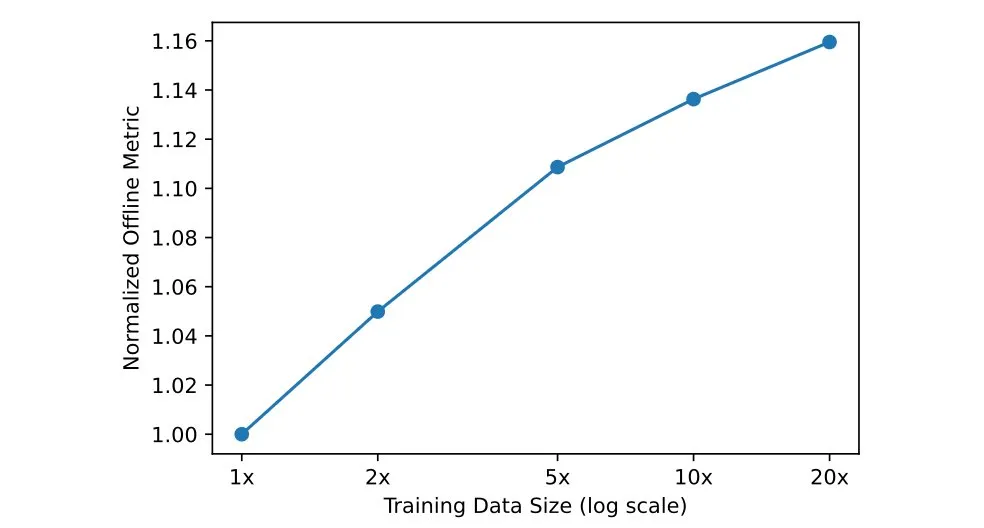
در این مدل ۱۰ میلیارد پارامتری، افزایش دادههای آموزشی در مرحله دوم باعث بهبود کیفیت میشود، هرچند که در حجمهای بسیار بالا، میزان بازدهی کاهش مییابد. این مرحله دوم از تنظیم دقیق، بین ۳۵ تا ۵۰ درصد به عملکرد مدل پایه اضافه میکند. اگر مدل پایه دو هفته قدیمی باشد، این فاصله به ۸۰ درصد میرسد چون مدل پایه نمیتواند عناوینی که تازه منتشر شدهاند را منعکس کند.
در یک تست A/B چهار هفتهای که روی ۱۰ درصد از ترافیک در سطوح توصیهی پیشمحاسبهشده انجام شد، نتایج زیر ثبت شد:
- تعامل کوتاهمدت در صفحه اصلی: ۰.۱۱۵ درصد افزایش
- معیارهای کلیدی بلندمدت: ۰.۰۰۶ درصد بهبود
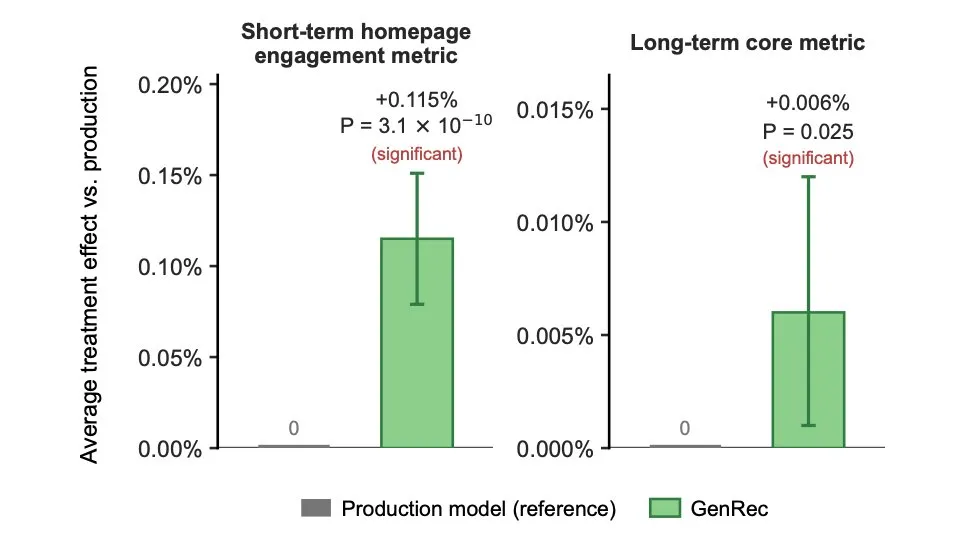
این تغییر، نشاندهنده گذار به «مهندسی بستر» (Context Engineering) است؛ رویکردی که در پروژههای دیگر مانند PLUM، GLIDE و OneRec-Think نیز دیده میشود. بهجای ساخت معماریهای سفارشی برای هر وظیفه، یک مدل زبانی واحد چندین مورد کاربرد را مدیریت میکند. حالا کار مهندسان از نوشتن کد برای ویژگیها به تصمیمگیری درباره این تغییر میکند که کدام سیگنالها باید در ورودی مدل قرار گیرند.
برای بیننده، این یعنی توصیههایی که سریعتر با مود و حالوهوای او و آثار جدید منتشر شده تغییر میکنند. برای صنعت، این ثابت میکند که LLMها میتوانند وظایف رتبهبندی در مقیاس بالا را بدون هزینههای سنگین خط لولههای سنتی یادگیری ماشین (ML Pipelines) مدیریت کنند.
نتفلیکس هنوز کل سیستم را جایگزین نکرده، اما GenRec گامی امیدوارکننده به سوی زیرساختهای متمرکز بر GPU است. این شرکت پیش از این از چارچوب VOID برای حذف اشیا از ویدیو استفاده کرده بود. همچنین در سال ۲۰۲۰، آنها از گرافهای دانش و نقشههای شباهت برای پیشبینی مخاطبان بهره میبردند، در حالی که مدل BERT گوگل برای پردازش خلاصههای متنی نوشته شده توسط انسان به کار میرفت.
گام بعدی شما
- اگر توسعهدهنده هستید، بررسی کنید چگونه میتوانید دادههای رفتاری کاربر را به توالیهای متنی تبدیل کنید تا از قدرت LLMها برای رتبهبندی استفاده کنید.
- روی کاهش حجم دادههای آموزشی از طریق استفاده از مدلهای پیشآموزشدیده (Pre-trained) تمرکز کنید.
- مدلهای رتبهبندی تکمرحلهای (Single-pass) را برای کاهش هزینه استنتاج در پروژههای خود تست کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو