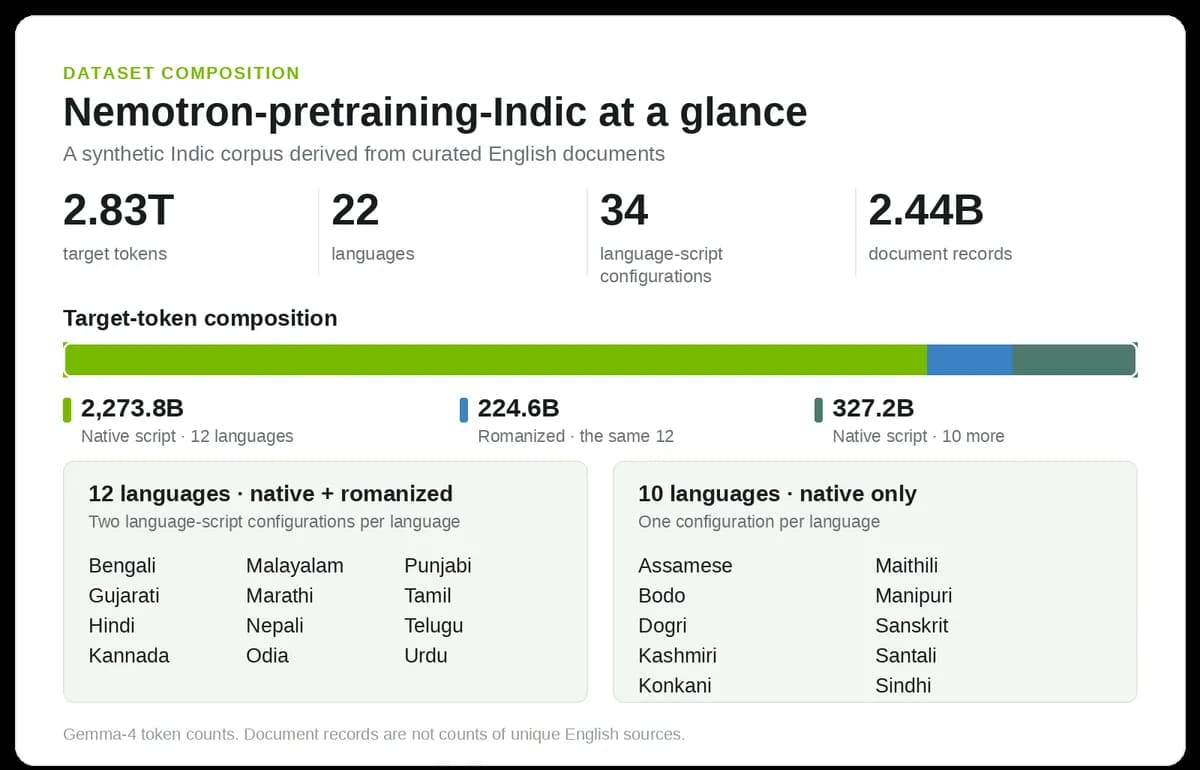
اگر توسعهدهندهای هستید که میخواهید مدلهای زبانی را برای بازارهای غیرانگلیسی بهینه کنید، باید بدانید که کمبود دادههای باکیفیت بزرگترین سد راه شماست. انویدیا با انتشار یک مجموعه داده ۲.۸ تریلیونی، قصد دارد این سد را برای ۱.۲ میلیارد نفر از شهروندان هند بشکند.
کمبود شدید دادهها برای مدتها باعث شده بود که فناوری زبانهای هندی از زبان انگلیسی عقب بماند. میتش خاپرا (Mitesh Khapra)، رئیس AI4Bharat و یکی از اعضای لیست TIME100 AI سال ۲۰۲۵، این موضوع را به عنوان مشکل اصلی شناسایی کرده و میگوید: «ما دادههای کافی برای زبانهای هندی نداریم.» در پاسخ به این چالش، شرکت انویدیا (NVIDIA) در ۱۶ اکتبر ۲۰۲۶، با همکاری IIT Madras و آزمایشگاه AI4Bharat، مجموعه داده Nemotron-pretraining-Indic-v1 را معرفی کرد. این منبع شامل تقریباً ۲.۸ تریلیون توکن (Token) — تکههای کوچکی از متن، مثل برشهای یک کیک طولانی که مدل تکهتکه میخورد — است که ۲۲ زبان رسمی هند را پوشش میدهد.
این انتشار دقیقاً ۲۲ زبانی را هدف قرار داده است که در قانون اساسی هند ذکر شدهاند. این زبانها زبان اصلی ۹۷٪ از مردم هند، یا تقریباً ۱.۲ میلیارد شهروند بر اساس سرشماری سال ۲۰۱۱ هستند. شرکای این پروژه با ارائه همزمان دادهها و «دستورالعمل تولید» (Generation Recipe)، تلاش میکنند تا خلق مجموعههای آموزشی مصنوعی باکیفیت برای زبانهای کممنبع را دموکراتیزه کنند. این پروژه حاصل تلاش مشترک پژوهشگران AI4Bharat — از جمله محمد صفیالدین رحمان خان، میتش خاپرا و آنوپ کونچوکوتان — و متخصصان انویدیا مانند نیکت آگاروال، راویراج جوشی، آنوشا کامات، مارکوس کلیگل، یِو مایر، سریهارشا نیورتی، کیران پراوین و اوتکارش وایدیا بود است.
با نگاهی به پوششهای قبلی ما درباره آموزش در مقیاس بزرگ — مانند پروژه Cedana که از ۳۶۷ پردازنده گرافیکی H100 برای ۱ تریلیون توکن استفاده کرد — این پروژه تمرکز را از قدرت محاسباتی خام به سمت کیفیت و منشأ (Provenance) خودِ دادهها تغییر میدهد. در همین راستا، برخی پژوهشها بر بهینهسازی سختافزاری تمرکز کردهاند، مانند پروژه CetinLM که امکان آموزش ۲ میلیارد توکن را تنها با یک پردازنده مصرفکننده ۱۶ گیگابایتی فراهم کرد. برای اکثر برنامهنویسان، چالش اصلی تنها در دسترس بودن GPUها نیست، بلکه یافتن متون فنی پاک و کافی در خطوط بومی است تا مدل برای کارهای حرفهای کاربردی شود. این انتشار، دادههای آموزشی مصنوعی باز (Open) در زبانهای هندی را گسترش میدهد و مطالب منتخب انگلیسی در زمینههای ریاضیات، کدنویسی و محتوای پرسش و پاسخ را به زبانهای هندی منتقل میکند.
ترکیب مجموعه داده
این مجموعه داده برای انعکاس نحوه ارتباط واقعی مردم، بین متن با خط بومی و متن رومیسازیشده (Romanized) تقسیم شده است. بر اساس گزارش huggingface.co، مجموع توکنها شامل ۲,۶۰۱ میلیارد توکن با خط بومی و ۲۲۴.۶ میلیارد توکن رومیسازیشده است. این اعداد با استفاده از توکنساز Gemma-4 محاسبه شدهاند.
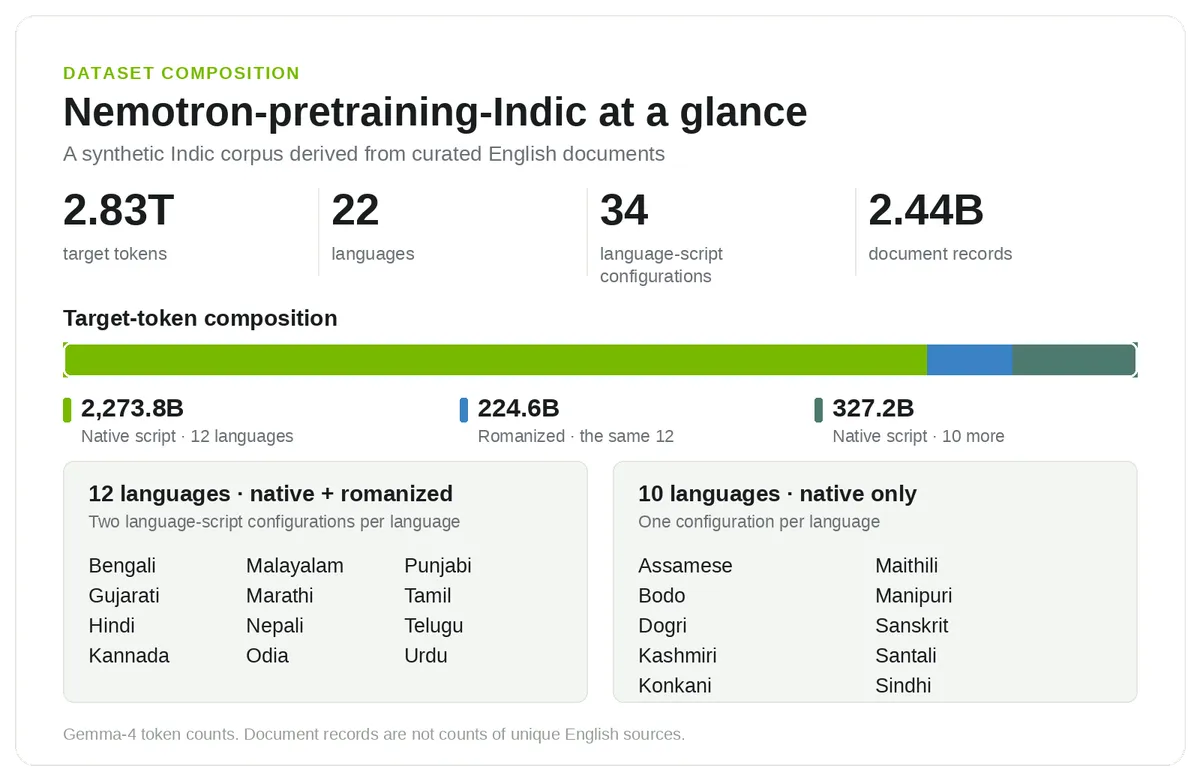
این مجموعه داده در دو گروه پیکربندی زبانی سازماندهی شده است:
- زبانهای دو-خطی (بومی و رومی): بنگالی، گجراتی، هندی، کانادا، مالایالم، ماراتی، نپالی، اودیا، پنجابی، تامیلی، تلوگو و اردو.
- زبانهای تک-خطی (فقط بومی): آسامی، بودو، دوگری، کشمیری، کونکانی، مایتلی، مانیپوری، سانسکریت، سانتالی و سندی.
دوازده زبان دارای هر دو نسخه بومی و رومی هستند و ده زبان باقیمانده فقط در خط بومی ارائه شدهاند. این تمایز برای آموزش مدلها حیاتی است، زیرا متن رومیسازیشده (زبانهای هندی که با خط لاتین نوشته شدهاند) در حالی که همان معنای زیربنایی را منتقل میکند، مواجهه متفاوتی با خط (Script) ایجاد میکند. برای دوازده زبان دو-خطی، رومیسازی تنها بخشی از ترجمههای پذیرفتهشده در خط بومی را پوشش میدهد.
زیرساخت و پیشینه
آزمایشگاه AI4Bharat در IIT Madras، سابقهای طولانی در ساخت مجموعهدادهها و مدلهای متنباز دارد. یکی از منابع بنیادین این مرکز، Sangraha است؛ یک مجموعه داده پیشآموزش باز برای ۲۲ زبان هندی که به ایجاد پایه و اساس پژوهشهای مدلهای زبانی باز در هند کمک کرد. این تلاشها در کنار پیشرفتهای دیگر در استخراج دادههای محلی، مانند دستاورد جدید در استخراج دادههای PDF برای زبان مالایالم، به تقویت زیرساختهای زبانی منطقه کمک میکند.
انتشار Nemotron-pretraining-Indic-v1 نشاندهنده گسترش قابل توجه این تلاشهاست. تیم سازنده با ادغام ترکیبی گسترده از مطالب منتخب انگلیسی — بهویژه در حوزههای فنی مانند ریاضیات و کدنویسی — مواد لازم را فراهم کرده است تا مدلها بتوانند مفاهیم فنی را توضیح دهند و مسائل پیچیده را در زبانهای بومی هند حل کنند.
خط لوله تولید داده
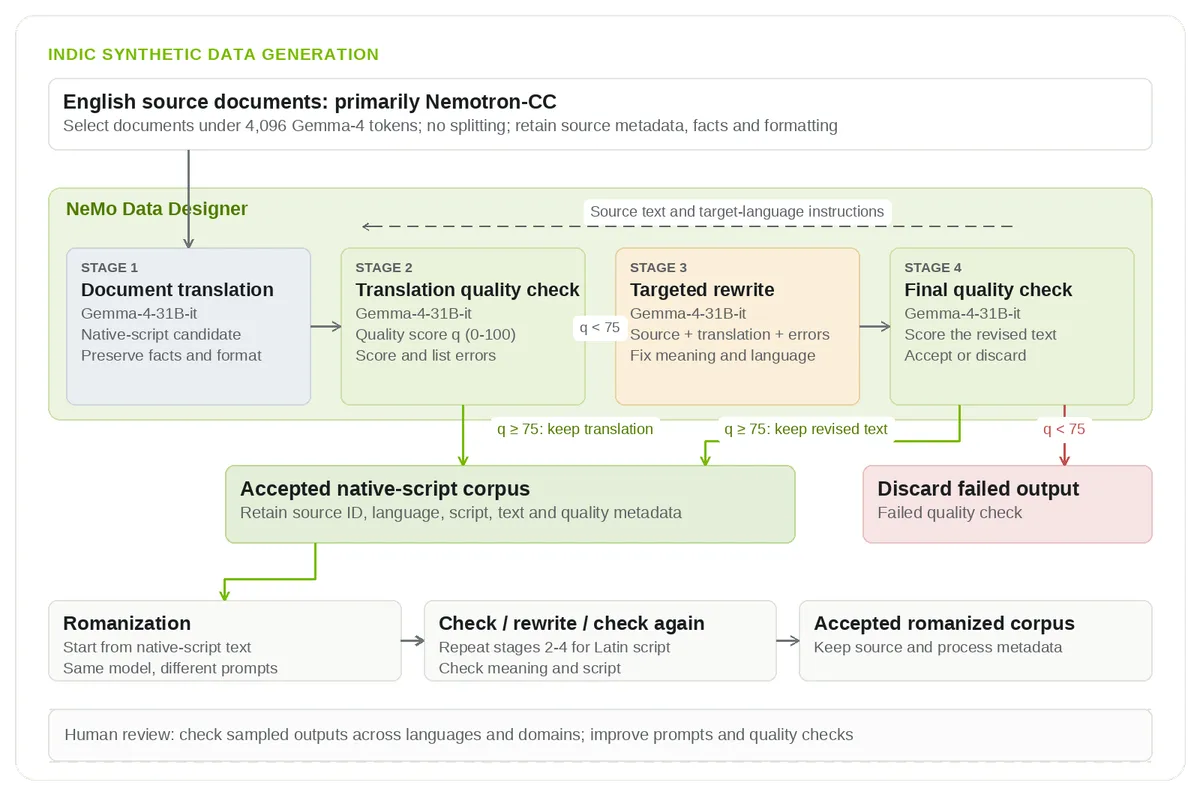
تیم سازنده برای خلق این مجموعه از NeMo Data Designer استفاده کرد؛ یک چارچوب بازمتن متعلق به انویدیا برای تولید دادههای مصنوعی (Synthetic Data). آنها کار را با اسنادی از ۱۵ زیرمجموعه Nemotron-CC-v2 آغاز کردند که شامل متون وب، مطالب پرسش و پاسخ، ریاضیات، کد و سایر محتواهای تخصصی بود. در طول کل گردش کار، تیم شناس هر منبع (Source Identifier) را حفظ کرد تا توسعهدهندگان بتوانند هر خروجی را برای حسابرسی و بررسی منشأ، به سند اصلی آن بازگردانند.
برای گروه اصلی دوازده زبانه، تیم از مدل Gemma-4-31B-it برای ترجمه کامل اسناد استفاده کرد. این رویکرد به مدل اجازه میدهد تا بستر متن (Context) را در سراسر پاراگرافها، جداول و معادلات حفظ کند. این گردش کار از یک فرآیند سختگیرانه چهار مرحلهای پیروی میکند:
- ترجمه: اسناد انگلیسی ترجمه میشوند. پرامپتها بهگونهای طراحی شدهاند که متن ادبی (Prose) را از محتوایی که باید حفظ شود (مانند کدها، معادلات، URLها و فرمتبندیها) متمایز کند. در حالی که این مدل بر کیفیت متمرکز است، مقایسههای اخیر بین ابزارهای ترجمه پیشرو در سال ۲۰۲۶ نشان میدهد که تعادل بین سرعت و دقت همچنان یک چالش کلیدی در سیستمهای ترجمه زنده است.
- ارزیابی: همان مدل، خروجی را در برابر منبع انگلیسی میسنجد. برای این کار از یک دستورالعمل (Rubric) الهام گرفته از MQM (معیارهای کیفیت چندبعدی) استفاده میشود که چارچوبی باز برای طبقهبندی خطاهای ترجمه بر اساس نوع و شدت در زمینههای معنا، روانی، اصطلاحات، استایل و فرمت است.
- اصلاح: تنها خروجیهایی که امتیاز ۷۵ از ۱۰۰ یا بالاتر کسب کنند، حفظ میشوند. برای خروجیهای با امتیاز پایینتر، مدل از بازخوردهای ارزیابی برای هدایت اصلاحات هدفمند استفاده میکند و سپس دوباره آنها را با همان آستانه ۷۵/۱۰۰ میسنجد.
- رومیسازی: بخشی از ترجمههای بومی پذیرفتهشده به خط لاتین تبدیل میشوند. مشخص شد که این رویکرد دو مرحلهای (ابتدا ترجمه و سپس تبدیل)، توهمات (Hallucinations) کمتر و باقیماندههای انگلیسی کمتری نسبت به تولید مستقیم انگلیسی به رومی دارد.
این فیلترینگ دقیق باعث شد ۴۳۸.۴ میلیارد توکن که در حالت عادی دور ریخته میشدند، بازیابی شوند. برای اطمینان از دقت، تیم از بررسیهای نمونهبرداری شده انسانی و تستهایی با خطاهای عمدی برای بهینهسازی پرامپتها و بررسیها استفاده کرد.
گردش کار ۱۰ زبان خاص
برای ۱۰ زبان باقیمانده، تیم فرآیند را برای رفع مشکلات پایداری خط و کیفیت اسناد طولانی تغییر داد. به جای استفاده از Gemma-4 برای ترجمه، آنها Indic Translate متعلق به Bodhan AI را ادغام کردند؛ یک مرکز غیرانتفاعی برای هوش مصنوعی در آموزش که در IIT Madras پرورش یافته است.
- روش ترجمه: Indic Translate ترجمه در سطح سند را برای انگلیسی و ۲۲ زبان هندی مدیریت میکند.
- کنترل کیفیت: مدل Gemma-4-31B-it برای ارزیابی ترجمهها در برابر منبع انگلیسی استفاده میشود و تنها موارد با امتیاز ۷۵/۱۰۰ یا بالاتر حفظ میشوند.
- مدیریت خاص: برای زبان مانیپوری، گردش کار ابتدا ترجمه به خط بنگالی و سپس تبدیل به خط بومی (Meitei Mayek) را انجام میدهد. برای اسناد طولانیتر زبان سانتالی، تیم از پنجرههای متداخل (Overlapping Windows) برای ترجمه استفاده کرد و سپس سند را بازسازی نمود.
- محدودیت: برخلاف گروه دوازده زبانه، این گردش کار فقط دادههای خط بومی تولید میکند و شامل بازنویسی بر اساس بازخورد نیست.
اثر بر عملکرد مدل
انویدیا این دادهها را از طریق پیشآموزش (Pretraining) — مرحلهای که مدل کلیات زبان را یاد میگیرد — روی مدل Nemotron 3.5 Super VL آزمایش کرد. آنها بودجهای معادل ۱۰۰ میلیارد توکن آموزشی را پیکربندی کردند و ۱۰٪ آن (۱۰ میلیارد توکن) را به ترکیبی از این دادههای مصنوعی و متون طبیعی هندی اختصاص دادند. ۹۰٪ باقیمانده، تناسبات ترکیب آموزشی قبلی را حفظ کرد.
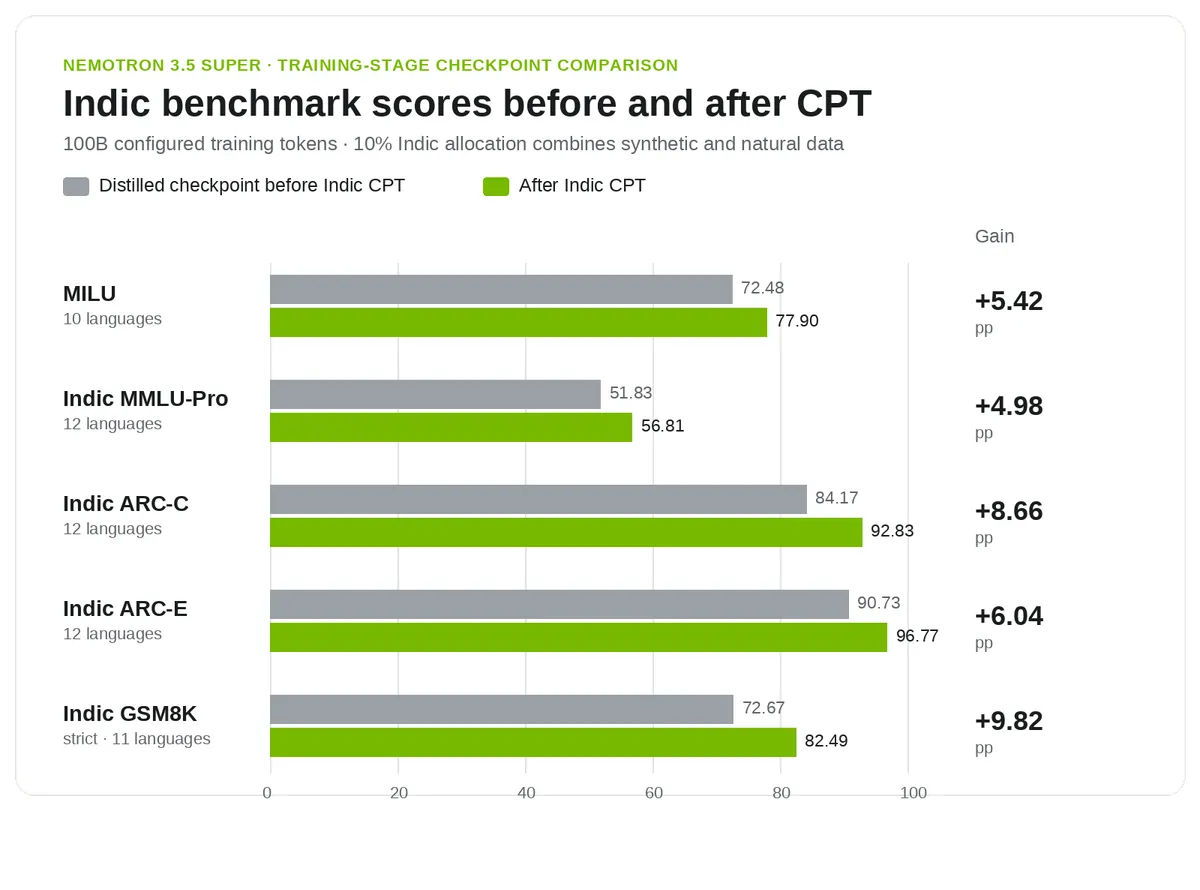
نتایج در پنج محک (Benchmark) کلیدی شامل MILU، Indic MMLU-Pro، Indic ARC-Challenge، Indic ARC-Easy و Indic GSM8K، افزایشی بین ۴.۹۸ تا ۹.۸۲ درصد را نشان داد. شایان ذکر است که در ارزیابی GSM8K، زبان اودیا حذف شد زیرا ارزیابی آن از حد مجاز بستر سرویس (Serving Context Limit) فراتر رفت.
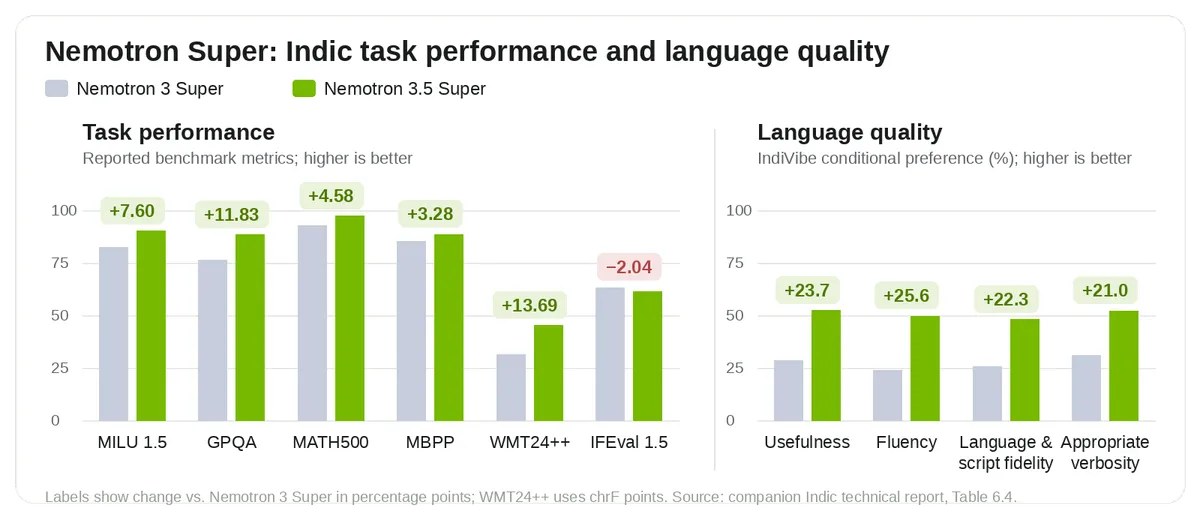
در مقایسه مدل نهایی Nemotron 3.5 Super VL با نسخه قبلی Nemotron 3 Super، مدل جدید در پنج مورد از شش محک وظیفهای (شامل دانش، استدلال، ریاضیات، کد و ترجمه) امتیاز بالاتری کسب کرد. اگرچه دنبال کردن دستورالعملها در IFEval 1.5 حدود ۲.۰۴ امتیاز افت کرد، اما مدل در هر چهار بعد IndiVibe (توسعه یافته توسط Sarvam AI) شامل کاربردی بودن، روانی، وفاداری به زبان و خط، و ایجاز مناسب، پیشرفت چشمگیری داشت.
راهنمای پیادهسازی برای توسعهدهندگان
برنامهنویسان اکنون میتوانند این مجموعه را از طریق Hugging Face Datasets و با استفاده از تگهای منطقهای خاص بارگذاری کنند؛ مثلاً hi-Deva-IN برای زبان هندی در خط دیواناگری یا hi-Latn-IN برای هندی رومیسازیشده. توصیه میشود برای بازرسی رکوردها بدون دانلود کل مجموعه چند تریلیونی، از قابلیت streaming استفاده کنید.
from datasets import get_dataset_split_names, load_dataset
dataset_id = input("Repository ID from the dataset card: ").strip()
config = "hi-Deva-IN"
splits = get_dataset_split_names(dataset_id, config_name=config)
print("Available splits:", splits)
data = load_dataset(
    dataset_id, name=config, split=splits[0], streaming=True
)
print(next(iter(data)))
برای تطبیق این دستورالعمل، پلاگین Nemotron Bharat برای NeMo Data Designer اکنون در دسترس است. این پلاگین دقیقاً همان پرامپتها، دستورالعملهای ارزیابی، پنجرهبندی اسناد و پشتیبانی از بازنگاری خط را فراهم میکند که انویدیا استفاده کرده است. به توسعهدهندگان توصیه میشود از Nemotron-Personas-India برای تغذیه طراح استفاده کنند که پرسوناهای مصنوعی در انگلیسی و هندی را بر اساس توزیعهای واقعی دنیای هند ارائه میدهد.
جزئیات فنی اجرا
برای کسانی که قصد ساخت یک دستورالعمل آموزشی کامل را دارند، تیم گامهای زیر را پیشنهاد میکند:
- تست ترکیب: مقایسه ترکیبات مختلف در یک بودجه توکن ثابت و ثبت سهم دادههای طبیعی در برابر مصنوعی و بومی در برابر رومی.
- ردیابی معیارها: نظارت بر نتایج هر زبان در حالی که حفظ تواناییهای انگلیسی و کیفیت کلی خط رصد میشود.
- ایجاد تقسیمبندی (Split): هنگام ایجاد مجموعههای آزمایشی (Held-out splits)، باید رکوردهایی که از یک منبع واحد در زبانها و خطوط مختلف مشتق شدهاند شناسایی شوند تا از نشت داده (Data Leakage) جلوگیری شود.
- پسآموزش: جفت کردن این مجموعه با دادههای پسآموزش Nemotron، مانند مجموعههای Chat & Instruction یا Post-Training Blends.
محدودیتها و قلمرو
نویسندگان هشدار میدهند که ترجمه مصنوعی جایگزین متون بومی نیست، زیرا متون طبیعی برای دانش محلی و بستر فرهنگی ضروری هستند. دادههای مصنوعی دسترسی به منابع را گسترش میدهند اما پوشش کامل فرهنگ محلی را تضمین نمیکنند.
- سوگیری اتوماسیون: ارزیابی کیفیت عمدتاً خودکار است. در حالی که گردش کار دوازده زبانه از خودِ مترجم به عنوان داور استفاده میکند، گردش کار ده زبانه به تایید گستردهتر گویشوران بومی نیاز دارد.
- حذف تکرار: بررسیهای Source-ID تکرارهای پردازشی را حذف میکنند، اما این مجموعه از حذف تکرارهای معنایی (Semantic Deduplication) برای محتواهای مشابه استفاده نکرده است.
- تداوم خطاها: متون پذیرفتهشده ممکن است علیرغم آستانه ۷۵/۱۰۰، همچنان حاوی خطا باشند.
این تلاش با Indic-LLM-Eval-Suite همراه شده است؛ مجموعهای در حال تکامل از محکها توسط AI4Bharat و انویدیا که به جامعه کمک میکند عملکرد وظایف و کیفیت زبان را دقیقتر اندازهگیری کند.
این تحول به سمت باز کردن «فرآیند» تولید داده، نه فقط فایل نهایی، فرضیات این حوزه را تغییر میدهد. مسیر رسیدن به برابری زبانی در هوش مصنوعی، دیگر فقط با خزش (Scraping) وب نیست، بلکه با ساخت پلهای مصنوعی باکیفیت از زبانهای غنی مانند انگلیسی به سایر زبانهای جهان است. برای مشاهده اثر این موضوع بر مدلهای خود، میتوانید پلاگین Nemotron Bharat را روی نمونه کوچکی از اسناد تخصصی خود تست کنید تا پرامپتهای ترجمه را پیش از مقیاسبندی بهینه کنید.
گام بعدی شما
- اگر روی مدلهای چندزبانه کار میکنید، پلاگین Nemotron Bharat را روی نمونه کوچکی از اسناد تخصصی خود تست کنید تا پرامپتهای ترجمه را بهینه کنید.
- مجموعه دادههای رومیسازیشده را برای تحلیل رفتار کاربران در شبکههای اجتماعی (که از خط لاتین استفاده میکنند) بررسی کنید.
- از Indic-LLM-Eval-Suite برای سنجش دقیقتر کیفیت مدلهای خود در زبانهای غیرانگلیسی استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو