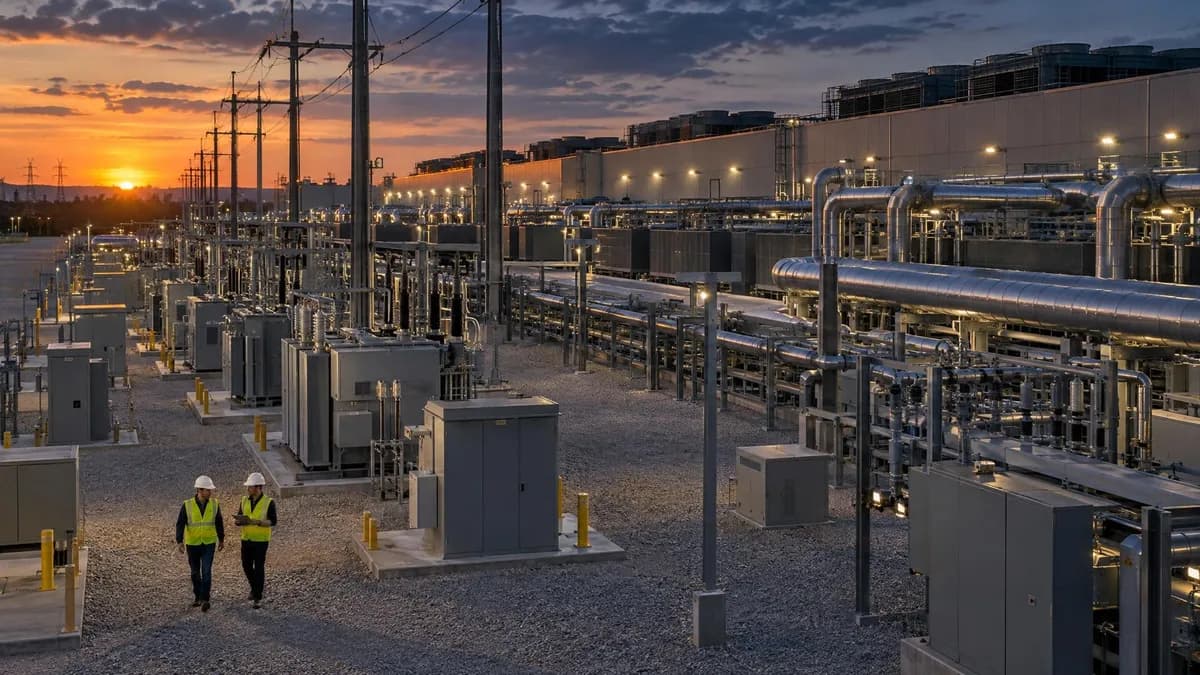
انویدیا و اوراکل در ۲۷ اکتبر ۲۰۲۶ اعلام کردند ابرخوشههای زیرساخت ابری اوراکل (Oracle Cloud Infrastructure) را با سیستمهای ورا روبین NVL72 به مقیاس چند گیگاواتی میرسانند. به گفتهٔ اوراکل، ورا روبین تا ۳۰ برابر توان عملیاتی استنتاج در هر وات و ۴ برابر عملکرد آموزش نسبت به نسل بلکول دارد.
دو شرکت همچنین از دسترسی عمومی ورا روبین NVL72 و پردازندههای ورا انویدیا روی OCI خبر دادند. اوراکل قصد دارد سیستمهای HGX Rubin NVL8 را هم بهزودی عرضه کند.
چرا ابرخوشههای OCI بزرگتر میشوند
به گفتهٔ دو شرکت، تقاضای مشتریان برای زیرساختی رو به افزایش است که دو نوع کار را همزمان انجام دهد. نوع اول، کار سنگین واحد پردازش گرافیکی (GPU) برای آموزش و سرویسدهی مدلهای پیشرو است. نوع دوم، کارهای سنگین پردازنده است که عاملهای خودمختار بین فراخوانی مدلها انجام میدهند؛ مثل اجرای ابزار، آزمایش کد و بازیابی داده.
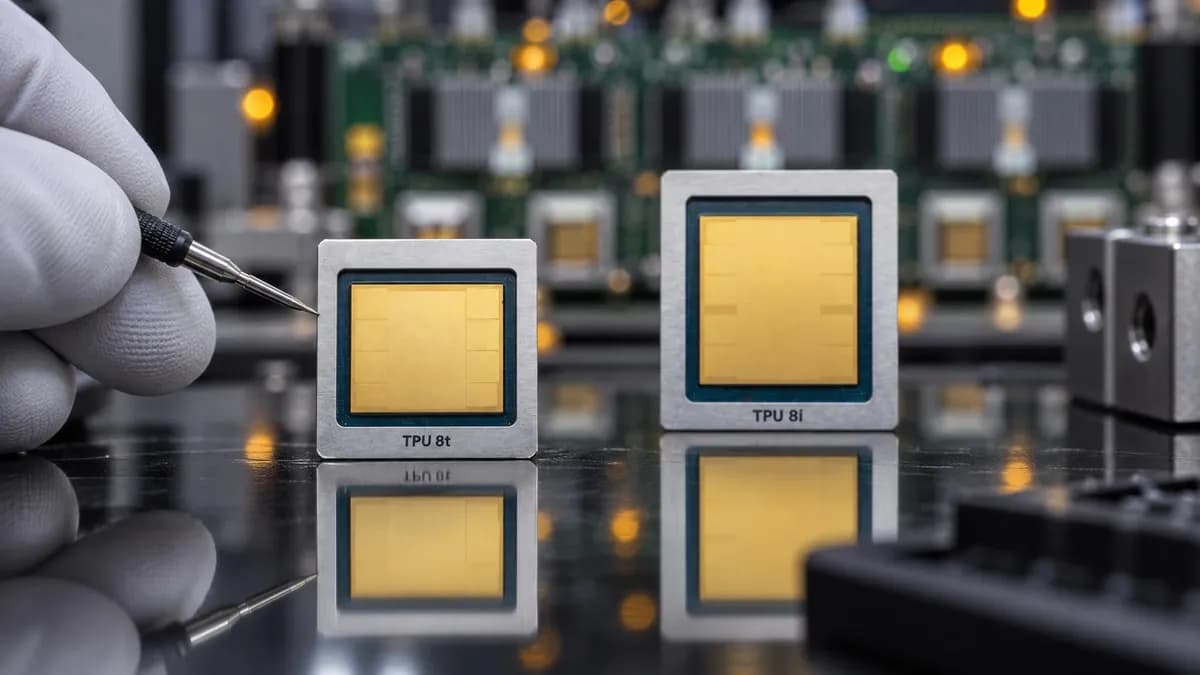
در معماری جدید، مشتریان میتوانند منابع CPU و GPU را مستقل از هم مقیاس دهند. هدف این کار کاهش ظرفیت بیکار و بهبود بهرهوری کلی است. این گسترش بر زیرساخت فعلی OCI با سیستمهای GB200 و GB300 NVL72 بنا شده و از پایهٔ نرمافزاری مشترک CUDA استفاده میکند که بارهای کاری را در نسلهای مختلف سختافزار پشتیبانی میکند. این گسترش بر زیرساخت فعلی OCI با سیستمهای GB200 و GB300 NVL72 بنا شده است، در حالی که اوراکل TPUهای نسل هشتم گوگل را هم در ابری خود عرضه میکند.
معماری ورا روبین و شبکهٔ Acceleron
- هر رک ورا روبین NVL72 تعداد ۷۲ GPU را با شبکهٔ مقیاسافزای NVLink به هم وصل میکند.
- شبکهٔ Acceleron اوراکل بر پایهٔ اترنت ۱۰۲٫۴ ترابیت بر ثانیه و Spectrum-X انویدیا با سوئیچهای Spectrum-6 و DPUهای BlueField-4 ساخته شده است.
- این شبکهٔ چندصفحهای میتواند تا صدها هزار GPU گسترش یابد و طبق پست اوراکل، شبکههای دوسطحی با بیش از ۱۳۱٬۰۰۰ GPU را ممکن میکند.
- تأمین برق در کلاس گیگاوات و خنکسازی مایع برای سیستمهایی طراحی شده که چند رک را در بر میگیرند.
- محوطههای OCI برای تراکم در شعاع دو کیلومتر بهینه شدهاند تا ظرفیت بتواند بین آموزش مدلهای پیشرو و استنتاج در محیط عملیاتی جابهجا شود.
اوراکل افزایش کارایی ورا روبین را به بهبودهای معماری در پردازنده ورا و GPU روبین و بهینهسازی مداوم نرمافزار در پشتهٔ CUDA نسبت میدهد. انتظار میرود ادغام Acceleron با Spectrum-X تأخیر دنباله (tail latency) را کم کند و کارایی ارتباطات جمعی را بالا ببرد.
ترکیب اترنت پرپهنایباند، NVLink و انتقال بار به DPU یک شبکهٔ یکپارچه میسازد. این شبکه هم آموزش با موازیسازی داده و هم استنتاج با موازیسازی مدل را بدون بازطراحی شبکه پشتیبانی میکند. مشتریان منابع GPU و CPU را از طریق کنسول و APIهای فعلی OCI مدیریت میکنند.
پردازنده ورا و سیستمهای HGX Rubin NVL8
اوراکل دسترسی عمومی OCI Compute با پردازندههای ورا را با استقرار اولیهٔ ۱۵۰٬۰۰۰ پردازنده در مناطق خود اعلام کرد. این پردازندهها از سهماههٔ چهارم ۲۰۲۶ در برخی مناطق و در قالب نمونههای Bare Metal و Flex Virtual Machine عرضه میشوند. اوراکل خود را نخستین ارائهدهندهٔ ابرمقیاسی معرفی کرد که پردازندههای ورا را به بازار میآورد.
- هر پردازنده ورا ۸۸ هستهٔ Olympus سازگار با Arm و ۱۷۶ رشته دارد.
- پهنای باند حافظه تا ۱٫۲ ترابایت بر ثانیه است.
- نمونههای دوپردازندهای OCI شامل ۱۷۶ هسته، ۳۵۲ رشته، ۱ ترابایت حافظهٔ LPDDR5X، ۷٫۶۸ ترابایت حافظهٔ NVMe و شبکهٔ ۲۰۰ گیگابیت بر ثانیه هستند.
انویدیا میگوید عملکرد عاملمحور این پردازنده تا ۸۰ درصد سریعتر از پردازندههای پیشروی x86 است. اوراکل تأکید کرده این نتایج بر محکهای پلتفرم انویدیا تکیه دارد، نه آزمایش نمونههای OCI، و عملکرد واقعی به بار کاری بستگی دارد.
سیستم HGX Rubin NVL8 هم هشت GPU روبین را با NVLink در یک سرور x86 کنار هم میگذارد. این سیستم دو پردازندهٔ ۶۴ هستهای Intel Xeon 6، ۴ ترابایت حافظهٔ DDR5 و شبکهٔ ۶٫۴ ترابیت بر ثانیه دارد و برای آموزش، تنظیم دقیق و استنتاج در نظر گرفته شده است.
اوپنایآی و نقشهراه ورا روبین
اوپنایآی مدل GPT-6 Astra را روی یک ابرخوشهٔ OCI با بیش از ۱۰۰٬۰۰۰ GPU بلکول در ابیلین، تگزاس آموزش داده و سرویس میدهد. سریکانت پوتانیس، از مدیران مهندسی زیرساخت محاسبات اوپنایآی، گفت: «ورا روبین انویدیا روی OCI عملکرد و مقیاس محاسباتی لازم را برای شتاب دادن به آموزش مدل و سرویسدهی به بارهای کاری هوش مصنوعیِ روزبهروز سنگینتر به ما میدهد.» اودای رودارجو، مدیر ارشد فناوری محاسبات اوپنایآی، هم گفت: «ما ورا را روی OCI وارد مرحلهٔ تولید میکنیم تا از این بارهای کاری در مقیاس بزرگ پشتیبانی کنیم.» اوپنایآی ورا روبین را برای بارهای کاری سنگینتر هوش مصنوعی در مقیاس بزرگ به کار میبرد، در حالی که انویدیا نسخه ۶۴ گیگابایتی DGX Spark را برای عاملهای هوش مصنوعی محلی عرضه کرده است.
طبق جمعبندی منابع، نقشهراه مشترک شامل ادغام تراشههای Grace Hopper انویدیا در ابرخوشههای OCI هم هست تا مشتریان بدون بازنویسی نرمافزار به معماریهای جدید CPU و GPU کوچ کنند. به گفتهٔ همین منابع، شرکتهایی در خدمات مالی، سلامت و توسعهٔ خودروهای خودران به مقیاسدهی مستقل CPU و GPU برای بهینهسازی هزینه در خطوط ترکیبی آموزش و استنتاج علاقه نشان دادهاند.
تحلیلگران صنعت نقشهراه چند گیگاواتی را نشانهٔ آمادگی ارائهدهندگان بزرگ ابر برای موج بعدی بارهای عاملمحور میدانند. در این بارها، مدلهای زبانی بزرگ کنار گروههایی از عاملهای تخصصی کار میکنند و هم به محاسبات موازی عظیم و هم به هماهنگی کمتأخیر پردازنده نیاز دارند. به گفتهٔ آنها، مقیاسدهی مستقل لایههای محاسبات میتواند هزینهٔ کل مالکیت را برای سازمانها کاهش دهد. کارایی بالاتر در هر وات هم به مراکز داده امکان میدهد در همان سقف توان موجود عملکرد بیشتری بگیرند و هزینهٔ عملیاتی و ردپای کربن را کم کنند.
گام بعدی شما
- اگر خط ترکیبی آموزش و استنتاج دارید، هزینهٔ مقیاسدهی مستقل CPU و GPU را در کنسول OCI بسنجید.
- برای بارهای پرنوسان مثل یادگیری تقویتی در مقیاس بزرگ یا سرویسهای زایای بلادرنگ، رکهای خنکشونده با مایع در محوطههای OCI را ارزیابی کنید.
- کد خود را روی پشتهٔ مشترک CUDA نگه دارید تا مهاجرت به نسلهای بعدی سختافزار بدون بازنویسی ممکن بماند.
گفتگو