تصور کنید توسعهدهندهای باشید که دیگر برای هر توکن مصرفشده توسط یک عامل پسزمینه که شبانهروز مسائل گیتهاب را مدیریت میکند، هزینه نمیپردازد. با مالکیت سختافزار، هزینه نهایی هر توکن به صفر میرسد و مسیر برای آزمایشهای جسورانه و عملیات مداوم بدون هیچگونه اصطکاک مالی باز میشود. این موضوع بهویژه برای عاملهایی که بهصورت شبانهروزی فعال هستند، حیاتی است.
یک دستگاه دسکتاپ NVIDIA DGX Spark 64GB اکنون ۱ پتافلاپ محاسبات هوش مصنوعی FP4 ارائه میدهد و هزینه نگهداری عاملهای همیشهفعال را از یک صورتحساب متغیر و ماهانه ابری به یک سرمایهگذاری سختافزاری یکباره تبدیل میکند. طبق اعلام انویدیا، این تغییر در پاسخ به رشد ۱۴ برابری مصرف توکنها توسط عاملهای خودمختار از ابتدای سال ۲۰۲۶ صورت گرفته است.
استقرار محلی عاملها اکنون به یک ضرورت تجاری تبدیل شده است؛ چراکه فراخوانی ابزارها (Tool Calls)، تلاشهای مجدد برای اصلاح خطا (Retries) و برنامهریزی با زمینه متنی طولانی (Long-context planning)، اعتبارات API را بهسرعت میسوزانند. همانطور که در تحلیل قبلی ما دربارهی نحوه عملکرد مسیریابهای شغلی (Job Routers) برای جلوگیری از نشت اسرار تجاری در عاملهای محلی اشاره کردیم، DGX Spark زیرساخت فیزیکی لازم برای دور نگه داشتن کامل این جریانهای کاری حساس از فضای ابری را فراهم میکند.
این سیستم روی یک پریز برق استاندارد کار میکند و نیازی به اتاق سرور یا سیستمهای خنککننده خاص ندارد. به این ترتیب، توسعهدهندگان میتوانند بدون نگرانی از هزینههای استنتاج (Inference) — که شبیه لحظه آشپزی واقعی است، نه دورهی آموزش آشپز — مدلهای خود را بهصورت مداوم اجرا کنند.
معماری سختافزاری
قلب تپنده DGX Spark 64GB تراشه فوقسریع GB10 Grace Blackwell است. این تراشه یک GPU بلکول که دارای هستههای تنسور نسل پنجم است را با یک CPU مدل Grace Arm ۲۰ هستهای ترکیب میکند. این پردازنده مرکزی از ۱۰ هسته Cortex-X925 و ۱۰ هسته Cortex-A725 تشکیل شده است. این رویکرد در استفاده از معماری ARM، یادآور تلاش انویدیا برای به چالش کشیدن سلطه اپل در بازار سختافزارهای پرقدرت است که پیشتر در سری RTX Spark مشاهده شد.
یک تصمیم طراحی کلیدی، معماری حافظه یکپارچه (Unified Memory Architecture) است. CPU و GPU از ۶۴ گیگابایت حافظه LPDDR5x از طریق NVLink-C2C بهطور مشترک استفاده میکنند که پهنای باندی ۵ برابر بیشتر از PCIe Gen 5 فراهم میکند. این ساختار نیاز به کپی کردن وزنها بین رم سیستم و حافظه گرافیکی (VRAM) را بهطور کامل از بین میبرد و اجازه میدهد مدلها، حافظههای موقت KV (KV Caches) و فرآیندهای ابزاری همگی در یک فضای آدرس واحد قرار گیرند.
مشخصات فنی
- محاسبات هوش مصنوعی: تا ۱ پتافلاپ FP4 (با استفاده از sparsity)
- حافظه: ۶۴ گیگابایت LPDDR5x، یکپارچه و منسجم (Coherent)
- پهنای باند حافظه: ۲۷۳ گیگابایت بر ثانیه
- شبکه: کارت شبکه ConnectX-7 (200GbE)، Wi-Fi 7 و بلوتوث ۵.۳
- ذخیرهسازی: ۱، ۲ یا ۴ ترابایت NVMe M.2 با قابلیت رمزنگاری سختافزاری (Self-encrypting)
- سیستمعامل: NVIDIA DGX OS (بر پایه اوبونتو)
- ابعاد و وزن: ۱۵۰ در ۱۵۰ در ۵۰.۵ میلیمتر؛ ۱.۲ کیلوگرم
- خروجی: یک پورت HDMI 2.1a
پشته نرمافزاری و امنیت
این سیستم در اولین بوت کاملاً آماده به کار است. سیستمعامل DGX همراه با پشته هوش مصنوعی انویدیا شامل PyTorch، Jupyter و Ollama عرضه میشود. برای توسعهدهندگان عاملها، NVIDIA NemoClaw با یک دستور ساده نصب میشود تا کنترلهای حریم خصوصی و امنیتی را به عاملهای OpenClaw اضافه کند. علاوه بر این، NVIDIA OpenShell™ که بخشی از ابزارک عاملهای انویدیا (NVIDIA Agent Toolkit™) است، حفاظهای (Guardrails) مبتنی بر سیاست را پیادهسازی میکند. مدلهای NVIDIA Nemotron™ بهطور ویژه برای این سختافزار بهینه شدهاند.
سازگاری با مدلهای محلی
انویدیا ظرفیت ۶۴ گیگابایتی را برای توانمندترین مدلهای باز با کلاس ۳۰ تا ۳۵ میلیارد پارامتر کافی میداند. بر اساس مستندات انویدیا، این دستگاه بسته به نوع کوانتش (Quantization) — که شبیه فشردهسازی یک فایل حجیم برای اشغال فضای کمتر است — میتواند مدلهایی تا ۱۰۰ میلیارد پارامتر را پشتیبانی کند.
مدلهای کلیدی بهینه شده برای این سختافزار عبارتاند از:
- Muse Glimmer (Meta): یک مدل متنی-تصویری متراکم ۲۹.۶ میلیارد پارامتری (تحت لایسنس Apache 2.0). این مدل در حالت کوانتیده به ۱۷ گیگابایت حافظه نیاز دارد. این مدل که از Muse Spark تقطیر (Distilled) شده است، بر فراخوانیهای قابلاعتماد ابزارها و بازیابی از خطاها تمرکز دارد و در محک SWE-Bench Pro امتیاز ۵۱.۲ و در MCP Atlas با زمینه متنی ۱۳۱ هزار توکنی، امتیاز ۷۵.۵ را کسب کرده است. در حالی که نسخه کامل BF16 به بیش از ۵۵ گیگابایت حافظه نیاز دارد، نسخه کوانتیده انتخاب عملی برای حافظه ۶۴ گیگابایتی است.
- Nemotron 3.5 Lightning (NVIDIA): یک مدل ۳۰ میلیارد پارامتری از نوع ترکیب خبرهها (MoE با ساختار 30B-A3B) که از چکپوینت NVFP4 استفاده میکند و بهعنوان یک مجری سریع برای عاملهای طولانیمدت عمل میکند.
- Qwen3.8-27B (Alibaba): یک مدل متراکم ۲۷ میلیارد پارامتری که برای کارهای کدنویسی و عاملهای عمومی، به ۱۳.۵ گیگابایت حافظه برای وزنها (در حالت ۴ بیتی) نیاز دارد.
پنج مورد کاربردی واقعی
اول، توسعهدهندگان میتوانند با ترکیب Hermes و Muse Glimmer یا Nemotron 3.5 Lightning یک عامل شخصی همیشهفعال بسازند. با دادن ابزارهایی مانند مخازن گیتهاب، یک محیط اجرای تست (Test Runner) و فید RSS از دستهبندیهای arXiv، این عامل میتواند شبها مسائل را اولویتبندی کرده و پیشنویسهای Pull Request را آماده کند، در حالی که یادداشتهای خصوصی و ایمیلها را روی خود دستگاه نگه میدارد.
دوم، این سختافزار از تنظیم دقیق (Fine-tuning) مدلهای ۷۰ میلیارد پارامتری با روش QLoRA — که شبیه دادن تخصص پوست به یک پزشک عمومی است — پشتیبانی میکند. انویدیا سرعت ۱۸,۴۰۰ توکن بر ثانیه را برای آموزش توزیعشده nanochat روی یک نود ثبت کرده است که به تیمها اجازه میدهد مدلها را روی کدهای داخلی و بررسیهای PR گذشته برای تبدیل شدن به یک دستیار کدنویسی محلی آموزش دهند.
سوم، این دستگاه بهعنوان یک میز ارزیابی (Evaluation Bench) روز اول عمل میکند. توسعهدهندگان میتوانند مدلهای جدید بازمتن را در همان روز انتشار از Hugging Face از طریق Ollama یا vLLM دریافت کنند. آنها میتوانند زمان تا نخستین توکن (TTFT) و تعداد توکن بر ثانیه را بدون پرداخت هزینه API برای اجرای ۵۰ باره ارزیابیها، اندازهگیری کنند.
چهارم، حافظه یکپارچه اجازه اجرای همزمان چندین مدل را میدهد (Multi-model teams). برای مثال، یک کاربر میتواند مدل Bonsai 2 را بهعنوان مسیریاب و Glimmer را بهعنوان عامل استدلالی بهطور همزمان اجرا کند که در مجموع حدود ۲۳ گیگابایت از وزنها را اشغال میکند. اگر مسئلهای از ظرفیت محلی فراتر رود، عامل میتواند یک پرسش پاکسازیشده (Sanitized) را به یک مدل ابری بزرگتر ارسال کند.
پنجم، این سیستم قطب نمونهسازی برای رباتیک لبه است. یک ترنسفورمر بینایی را میتوان برای شناسایی ناهنجاریها در دوربینهای یک کف کارخانه تنظیم کرد و پیش از انتقال به دستگاه NVIDIA Jetson، آن را روی پشته CUDA بهصورت محلی اعتبارسنجی نمود.
مقیاسپذیری از طریق NVIDIA Sync
زمانی که ۶۴ گیگابایت حافظه کافی نباشد، شبکه ConnectX-7 امکان خوشهبندی (Clustering) بومی را فراهم میکند. با استفاده از NVIDIA Sync، یک لایه مدیریتی با اپلیکیشنهای ویندوز و مک، کاربران میتوانند دستگاههای Spark موجود در شبکه خود را شناسایی و دسترسی SSH آنها را مدیریت کنند. دستیار خوشه (Cluster Assistant) میتواند شبکه را برای حداکثر ۴ سیستم پیکربندی کند که حتی میتوانند از طریق یک مش Tailscale در مکانهای مختلف به هم متصل شوند.
گزینههای خوشهبندی عبارتاند از:
- ۱ دستگاه (۶۴ گیگابایت): ۶۴ گیگابایت حافظه، تا ۱ پتافلاپ FP4.
- ۲ دستگاه (هر کدام ۶۴ گیگابایت): ۱۲۸ گیگابایت حافظه مشترک (Pooled)، تا ۲ پتافلاپ از طریق کابل مستقیم QSFP.
- ۳ دستگاه (هر کدام ۱۲۸ گیگابایت): ۳۸۴ گیگابایت حافظه مشترک، تا ۳ پتافلاپ از طریق حلقه QSFP.
- ۴ دستگاه (هر کدام ۱۲۸ گیگابایت): ۵۱۲ گیگابایت حافظه مشترک، تا ۴ پتافلاپ از طریق سوئیچ 200GbE (مدل QSFP56-DD با پروتکل RoCE v2).
انویدیا بیان میکند که دو واحد ۶۴ گیگابایتی خوشهبندیشده، تا ۱.۷ برابر بیشتر از یک واحد ۱۲۸ گیگابایتی عملکرد دارند، زیرا توان محاسباتی هوش مصنوعی دو برابر شده و پهنای باند ترکیبی به ۵۴۶ گیگابایت بر ثانیه میرسد. در حالی که سرعت رمزگشایی (Decode) بهبود متوسطی دارد (۱.۴ برابر در ۴ نود)، خوشهبندی تقریباً با هر دو برابر شدن تعداد دستگاهها، TTFT را نصف میکند که برای عاملهایی که ورودیهای طولانی میخوانند، حیاتی است. این تمرکز بر بهینهسازی نرخ خروجی، مشابه بهبودهای ۲۴ درصدی در توان عملیاتی توکنها در پلتفرم DSX است که انویدیا پیشتر برای محیطهای سازمانی به دست آورده بود.
تحلیل استراتژیک
این محصول یک سرور چت برای صدها کاربر نیست؛ پهنای باند ۲۷۳ گیگابایت بر ثانیهای آن، توان عملیاتی همزمان (Concurrent Throughput) را محدود میکند. در عوض، این یک ابزار تخصصی برای حجمهای کاری با «ورودی طولانی و خروجی کوتاه» است، مانند تحلیل یک فایل لاگ عظیم یا یک مخزن کد. مدلهای بزرگتر، مانند DeepSeek V4 Flash، به بیش از یک دستگاه نیاز دارند؛ بنچمارکهای انویدیا این مدل را روی چهار دستگاه ۶۴ گیگابایتی خوشهبندیشده اجرا کردهاند.
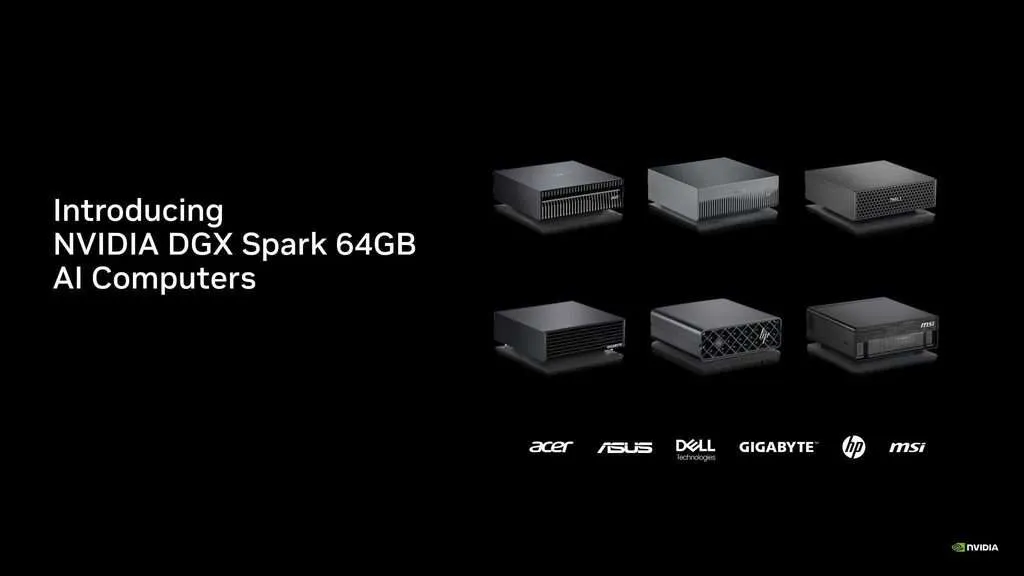
انویدیا با ارائه این محصول در لایههای ۶۴ و ۱۲۸ گیگابایتی از طریق شرکایی مانند Acer, ASUS, Dell, Gigabyte, HP و MSI، در تلاش است تا «ایستگاه کاری هوش مصنوعی» را به یک کالای تجاری تبدیل کند. آنها در حال انتقال محیط اصلی توسعهدهنده از APIهای ابری به روی میز کار هستند تا اطمینان حاصل کنند که پشته نرمافزاری همچنان در اکوسیستم CUDA قفل میماند. در این راستا، بررسی جایگزینی خوشههای ابری با سختافزارهای محلی مانند RTX PRO 5500 نشان میدهد که انویدیا بهشدت بر روی انتقال قدرت پردازشی به دسکتاپ متمرکز شده است.
این حرکت در واقع یک پوشش در برابر نوسانات قیمت API است. برای کسبوکارها، تغییر از هزینههای عملیاتی (OpEx - هزینههای هر توکن) به هزینههای سرمایهای (CapEx - مالکیت سختافزار) از لحظهای سودآور میشود که مصرف توکن روزانه یک عامل از هزینه استهلاک دستگاه Spark بیشتر شود.
این دستگاه از ۲۳ اکتبر ۲۰۲۶ از طریق NVIDIA Marketplace و شرکای OEM در دسترس خواهد بود و شکاف بین GPUهای مصرفکننده و رکهای سرور سازمانی را هدف قرار میدهد. باید منتظر ماند و دید جامعه مدلهای بازمتن چگونه مدلهای کلاس ۳۰ میلیارد پارامتری را بهینه میکنند تا از این فضای حافظه خاص بیشترین بهره را ببرند.
گام بعدی شما
- اگر از مدلهای ۳۰ میلیارد پارامتری استفاده میکنید، هزینه ماهانه API خود را با قیمت خرید یک DGX Spark مقایسه کنید تا نقطه بازگشت سرمایه را بیابید.
- مدلهای کوانتیده Muse Glimmer را برای تست قابلیتهای Tool Use در محیط محلی امتحان کنید.
- برای پروژههای تیمی، امکانات خوشهبندی NVIDIA Sync را برای ایجاد یک استخر حافظه مشترک بررسی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو