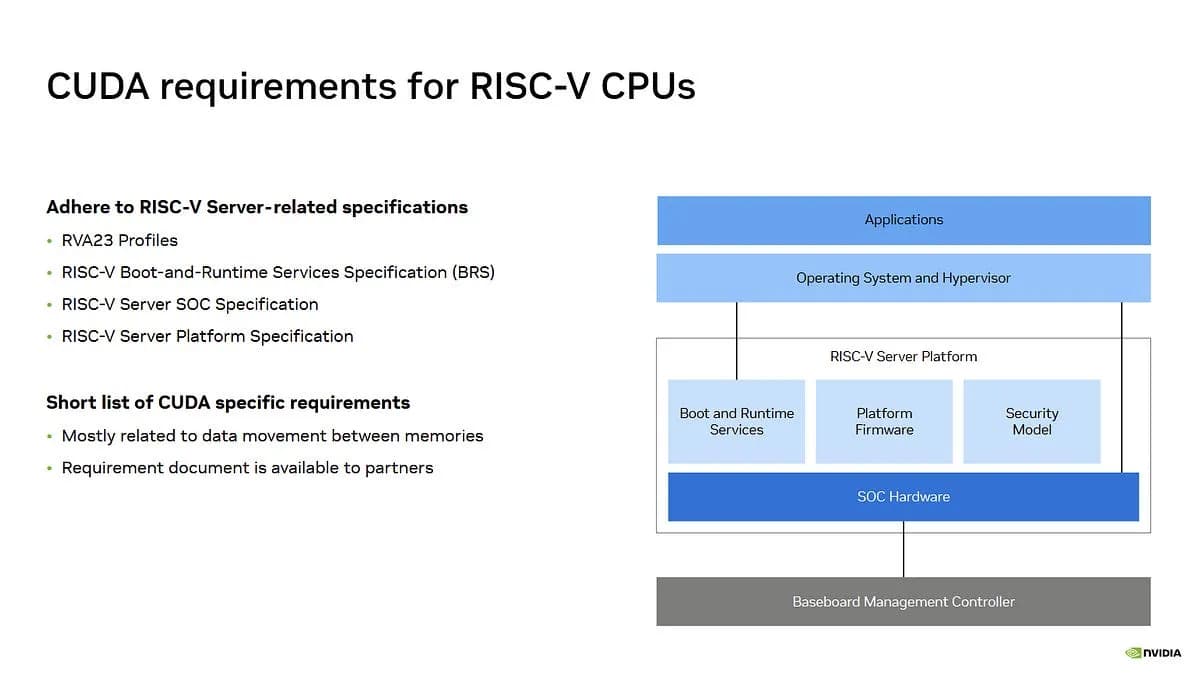
اگر امروز قصد طراحی یک تراشه سفارشی برای مراکز داده را دارید، خبر خوب این است که دیگر مجبور به استفاده از معماریهای بسته نیستید. اما یک شرط بزرگ وجود دارد: سختافزار شما باید استانداردهای سختگیرانه انویدیا را برای ورود به اکوسیستم CUDA پاس کند. انویدیا در این مسیر صرفاً به پورت کردن نرمافزار بسنده نکرده و مجموعهای از الزامات سختافزاری را اجباری کرده است تا از اجرای ناکارآمد کدها جلوگیری کند.
به گزارش وبسایت chipsandcheese.com در ۲۴ اوت ۲۰۲۶، یک تراشه سروری با تعداد هستههای بالا از شرکت SiFive بهزودی نخستین پل ارتباطی عملیاتی بین معماری RISC-V و اکوسیستم CUDA را به نمایش میگذارد. این اتفاق نشاندهنده یک نقطه عطف در نحوه تعامل پردازندههای باز با شتابدهندههای بسته است.
این تغییر استراتژیک، پایان سالها انحصار CUDA در پردازندههای x86-64 و aarch64 است. در واقع انویدیا به سمت استانداردهای باز سختافزاری حرکت میکند، به شرطی که این سختافزارها مانند یک پلتفرم حرفهای مرکز داده رفتار کنند. تصور کنید دنیایی را که در آن یک شرکت میتواند CPU سفارشی خود را طراحی کند اما همچنان از استک نرمافزاری استاندارد صنعت برای هوش مصنوعی و شتابدهی GPU استفاده کند. همانطور که در تحلیلهای پیشین ما دربارهی استقلال سختافزاری در مراکز داده اشاره کردیم، هدف نهایی این است که شرکتها بتوانند CPU سفارشی خود را طراحی کنند اما همچنان از استک نرمافزاری استاندارد صنعت برای محاسبات (Compute) — که مثل موتور محرک یک ماشین، تمام کارهای سنگین ریاضی را انجام میدهد — استفاده کنند. برای درک بهتر نحوه توزیع این محاسبات، میتوانید بررسی ما درباره تفکیک وظایف در هستههای تخصصی GPUهای انویدیا را مطالعه کنید.
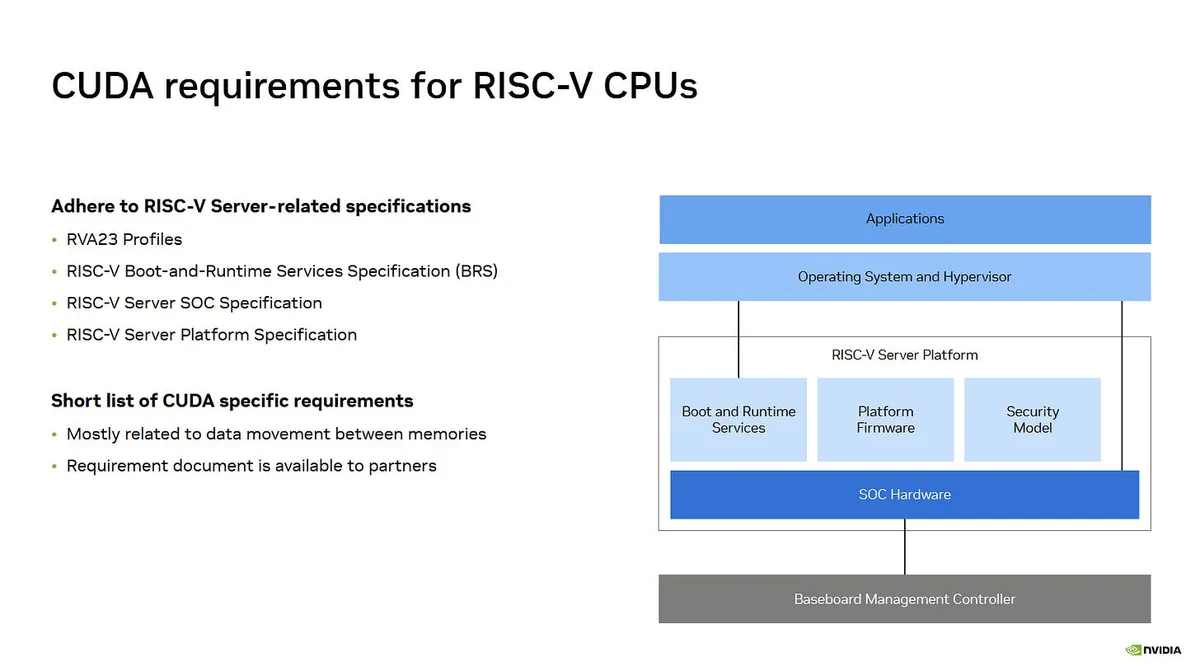
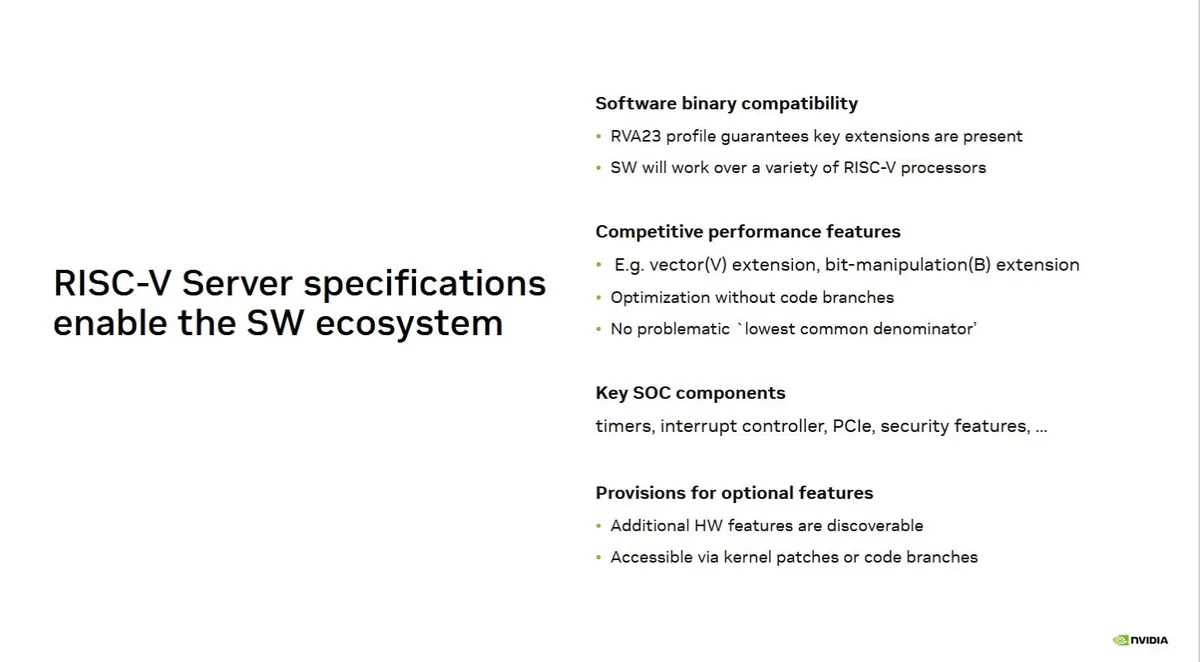
انویدیا میخواهد مطمئن شود که پردازندههای RISC-V میتوانند بهطور بهینه دادهها را به واحد پردازش گرافیکی برسانند. آنها به دنبال یک پورت عمومی و ساده نیستند، بلکه دقیقاً یک CPU و پلتفرم در سطح سرور میخواهند. این رویکرد مانع از مشکل «کمترین مخرج مشترک» میشود؛ وضعیتی که در آن انویدیا مجبور میشد کدهای ناکارآمدی منتشر کند چون نمیتوانست وجود افزونههای افزایش عملکرد را در تمام دستگاهها تضمین کند. در واقع، انویدیا نمیخواهد کیفیت اجرای CUDA را به خاطر پشتیبانی از سختافزارهای ضعیف فدا کند.
برای دریافت پشتیبانی CUDA، پردازندههای RISC-V باید از پروفایل RVA23 و مشخصات خاص SoCهای سروری و پلتفرم پیروی کنند. این الزامات سختگیرانه شامل موارد زیر است:
- ویژگیهای RAS: ابزارهای قابلیت اطمینان (Reliability)، در دسترس بودن (Availability) و سرویسدهی (Serviceability) که برای تضمین زمان فعال بودن (Uptime) در سیستمهای سازمانی حیاتی هستند.
- امنیت: وجود یک پردازنده امنیتی تخصصی که بهطور مستقیم در دل SoC ادغام شده باشد.
- افزونههای برداری (Vector Extensions): پشتیبانی از Predication برای جلوگیری از شاخههای شرطی که باعث توقف خط لوله پردازش و افت شدید عملکرد میشوند.
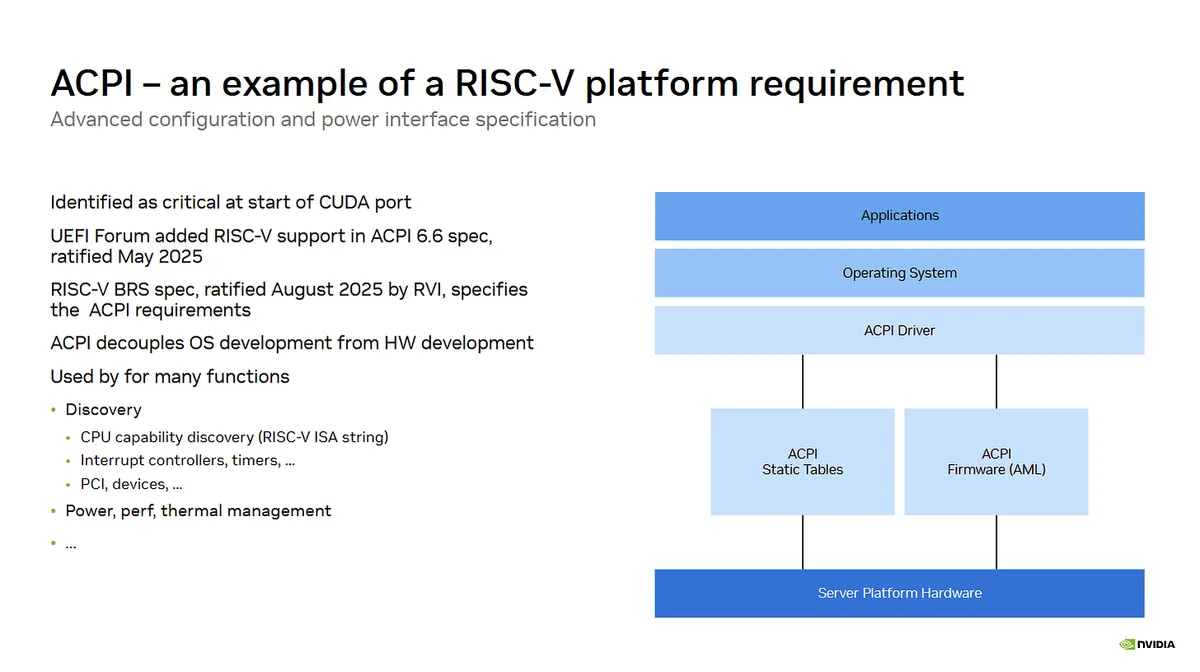
- پشتیبانی از ACPI: استاندارد مدیریت توان، عملکرد و حرارت که انجمن UEFI در سال ۲۰۲۵ آن را به RISC-V اضافه کرد و اکنون انویدیا آن را برای مدیریت بهینه سیستم الزامی میداند.
پشتیبانی از ACPI یکی از دشوارترین مراحل بود، زیرا به نرمافزار اجازه میدهد قابلیتهای سختافزاری را شناسایی و کشف کند. تیم نرمافزاری انویدیا در ابتدا با این مشکل روبرو بود چون سختافزارهای RISC-V در زمان شروع پورت CUDA، فاقد ACPI بودند. این خلأ باعث میشد نرمافزار نتواند بهطور دقیق با سختافزار ارتباط برقرار کند.
این وضعیت اخیراً حل شد. مشخصات BRS (سرویسهای بوت و زمان اجرا) در سال گذشته تصویب شد و ACPI را در بر میگیرد. با این حال، تاریخ نشان میدهد که پذیرش گسترده استانداردهای جدید زمانبر است؛ درست مانند دنیای aarch64 که سالها با وجود حضور در استانداردها، پشتیبانی از ACPI در آن لنگ میزد و بهصورت پراکنده اجرا میشد.
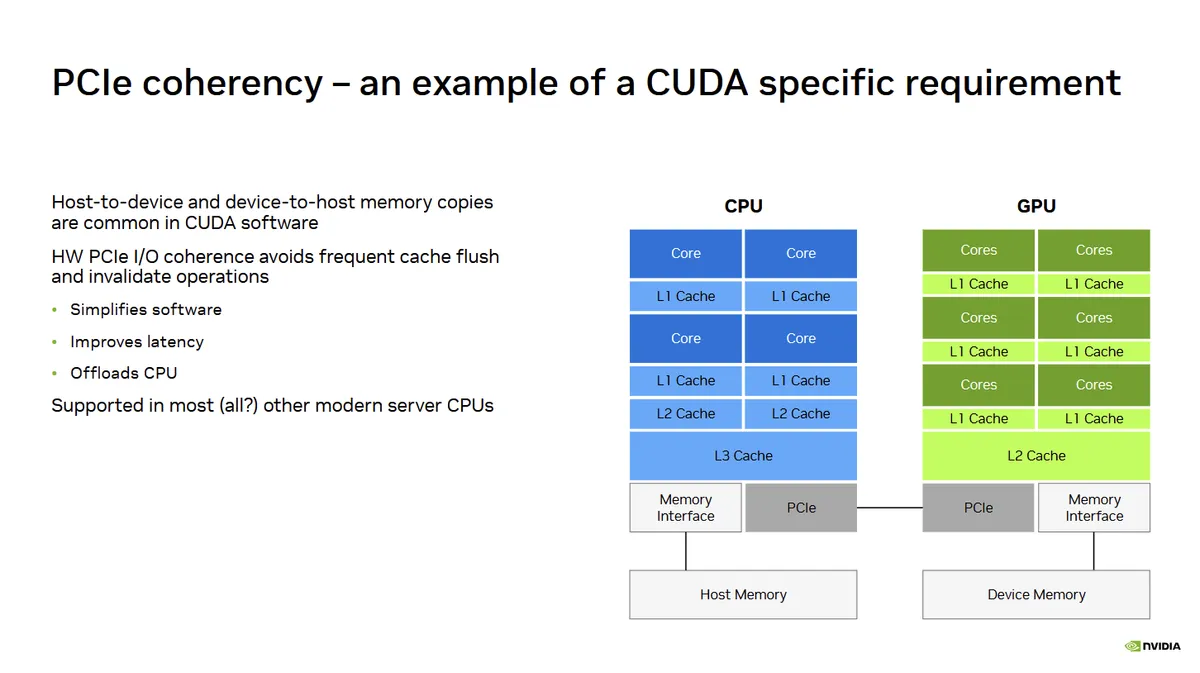
یکی از بحرانیترین موانع فنی، «همگامی PCIe» (PCIe Coherency) است. بدون این قابلیت، یک مشکل جدی در ترتیب حافظه رخ میدهد: CPU دادهای را مینویسد که در حافظه پنهان (Cache) باقی میماند. اگر CUDA یک درخواست DMA برای کپی آن داده به GPU صادر کند، موتورهای DMA ممکن است دادههای قدیمی (Stale) را از DRAM بخوانند و تغییرات جدید موجود در کش CPU را نادیده بگیرند.
همین مشکل در مسیر بازگشت دادهها نیز وجود دارد؛ وقتی نتایج از GPU بازمیگردند، CPU ممکن است دادههای قدیمی را از کش خود بخواند در حالی که موتورهای DMA دادههای جدید را در DRAM نوشتهاند. برای جلوگیری از این اتفاق، نرمافزار باید بهطور صریح کشها را نامعتبر (Invalidate) کند. انویدیا معتقد است ادغام این فرآیند دستی در استک CUDA بیش از حد دشوار است و همگامی PCIe را یک ویژگی استاندارد و ضروری برای هر CPU سرور میداند.
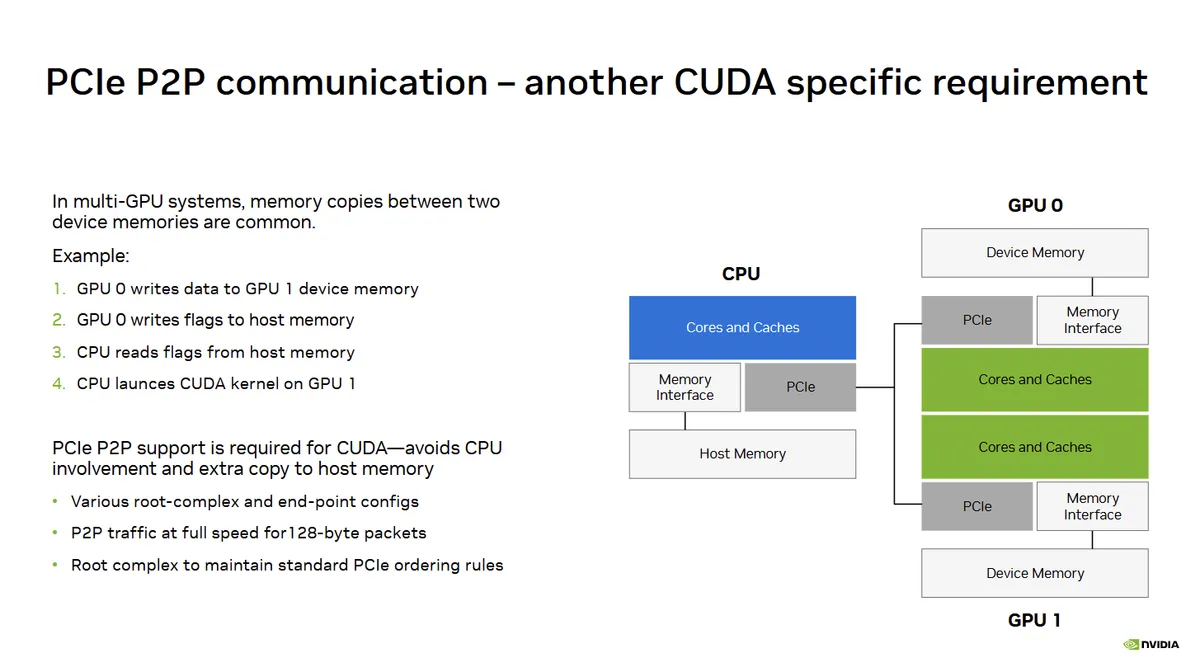
علاوه بر این، انویدیا ارتباط Peer-to-Peer در PCIe را میطلبد. این قابلیت اجازه میدهد دو دستگاه (مثلاً دو GPU یا یک GPU و یک شتابدهنده دیگر) بدون دخالت حافظه CPU و بدون مسیریابی دادهها از طریق آن، مستقیماً با هم تبادل بافر کنند. نبود این ویژگی، پیچیدگی سیستم را بهشدت بالا برده و هزینههای عملکردی را به دلیل نیاز به سیگنالهای همگامسازی اضافی افزایش میدهد.
فراتر از CUDA استاندارد، انویدیا در حال ترویج NVLink Fusion است. این فناوری به شرکتهای ثالث اجازه میدهد IP مربوط به NVLink را روی تراشههای خود پیاده کنند. یک CPU سفارشی RISC-V میتواند از لینک NVLink C2C برای اتصال مستقیم و سریع به GPU استفاده کند؛ مشابه روشی که در تراشه GB10 برای اتصال CPU شرکت Mediatek به GPU انویدیا به کار رفته است.
اگرچه انویدیا ترجیح میدهد مشتریان از CPUهای خود انویدیا استفاده کنند، اما NVLink Fusion مسیری را برای کسانی باز میکند که میخواهند شتابدهندهها یا CPUهای سفارشی خود را با بالاترین پهنای باند به اکوسیستم انویدیا متصل کنند.
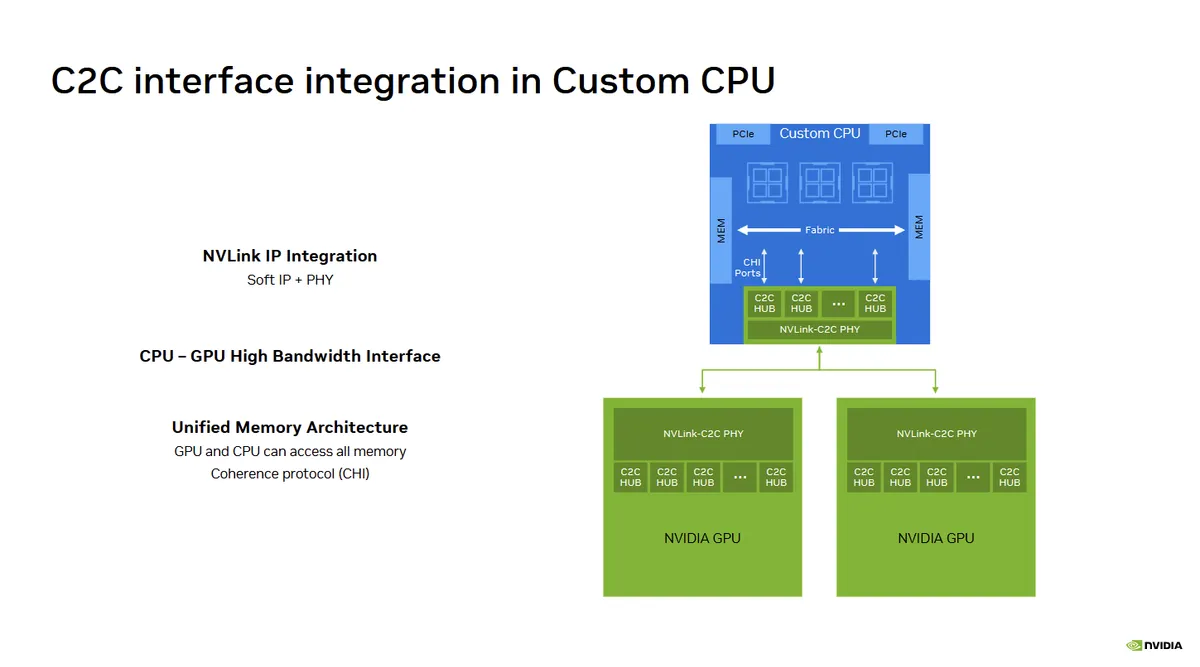
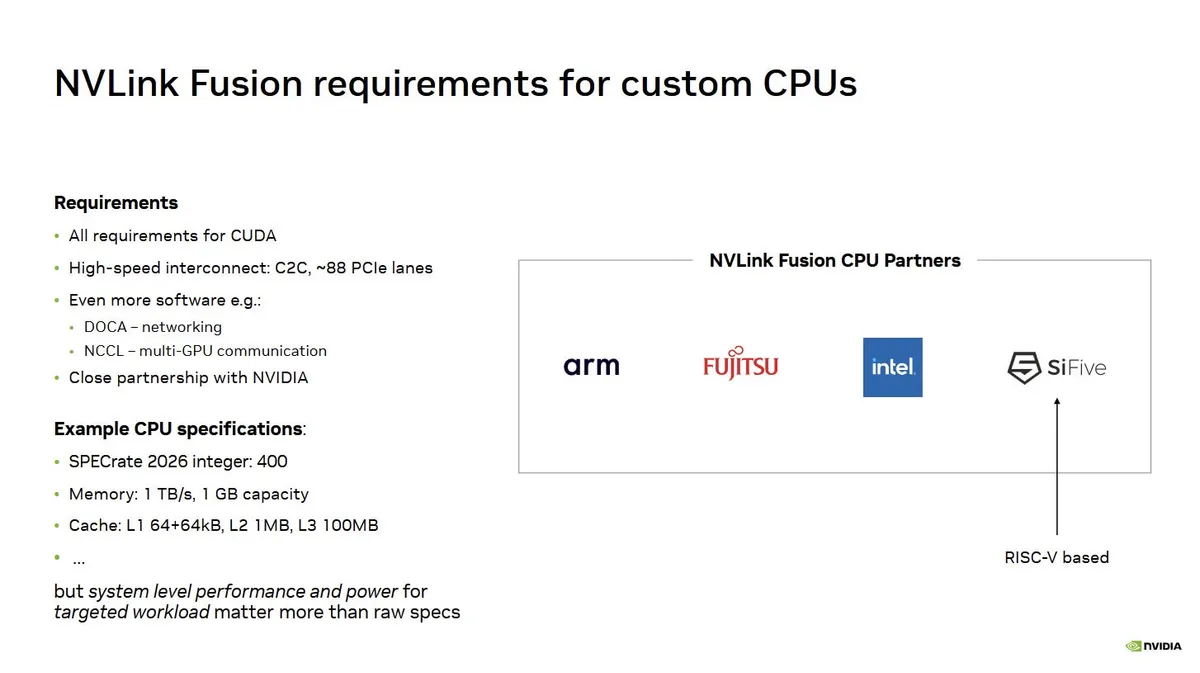
البته NVLink Fusion الزامات سنگینتری دارد. این فناوری علاوه بر تمام موارد مورد نیاز برای CUDA، پشتیبانی از فریمورکهای نرمافزاری پیشرفتهای مانند DOCA و NCCL را نیز میطلبد. این سطح از ادغام یک تلاش مهندسی پیچیده است که نیازمند یک شراکت نزدیک و تنگاتنگ با تیمهای انویدیا است. این سطح از همکاری احتمالاً مشابه رابطهای خواهد بود که انویدیا در پروژه GB10 با مدیاتک داشت. در همین راستا، تلاشهایی برای بهینهسازی لایههای نرمافزاری در جریان است، مانند سیستم CUDA Agent شرکت بایتدنس که سرعت کدنویسی کرنلهای GPU را بهطور چشمگیری افزایش داده است.
این تصمیم، شکاف عمیقی در اکوسیستم RISC-V ایجاد میکند. در حالی که ماهیت متنباز RISC-V برای علاقهمندان و توسعهدهندگان آماتور جذاب است، الزامات سختگیرانه انویدیا عملاً سختافزارهای رده مصرفکننده را بیرون میاندازد. اکثر بردهای فعلی RISC-V فاقد پشتیبانی از ACPI و همگامی PCIe هستند و به همین دلیل نمیتوانند CUDA را در شکل فعلیاش اجرا کنند.
بعید است که سختافزارهای مصرفکننده RISC-V در آینده نزدیک به این استانداردها برسند. در نتیجه، نخستین سیستمهای RISC-V مجهز به CUDA، سرورهای گرانقیمت و ردهبالا خواهند بود، نه کامپیوترهای تکبردی ارزانقیمت یا گجتهای کوچک.
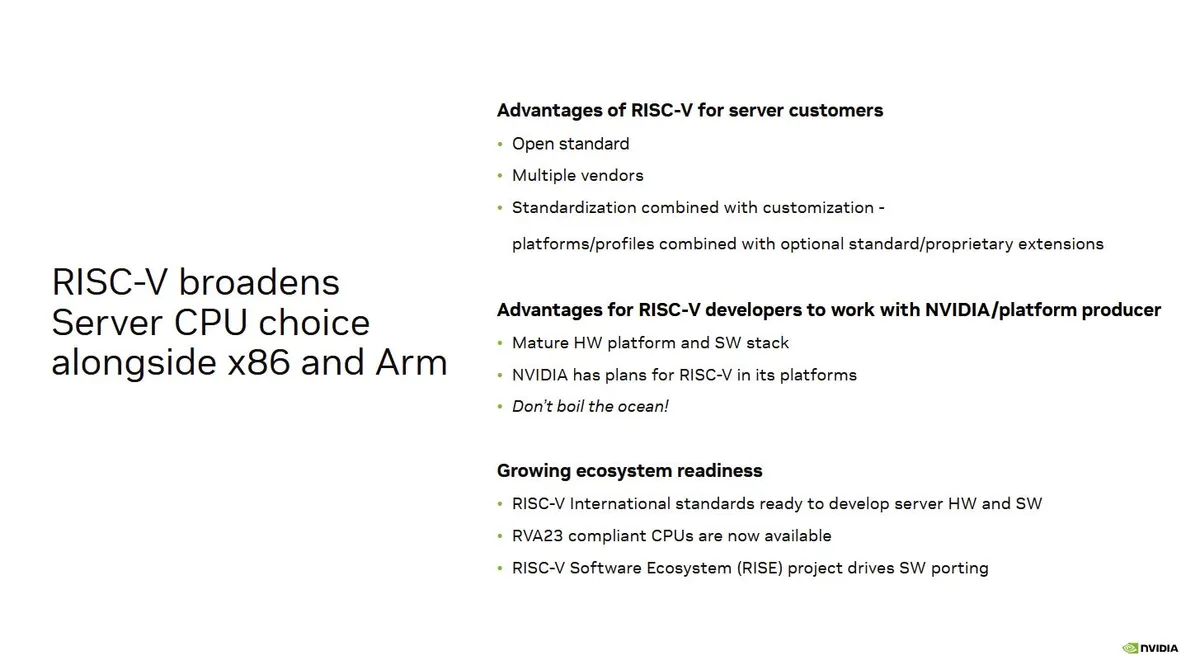
از منظر تجاری، انویدیا در حال محافظت از «خندق عملکردی» (Performance Moat) خود است. با رد کردن سختافزارهای ضعیف و عدم هدفگذاری روی «کمترین مخرج مشترک»، تضمین میکند که CUDA سریعترین راه محاسباتی باقی بماند، حتی زمانی که روی CPUهای غیرانویدیا اجرا میشود.
این استراتژی سازندگان RISC-V را مجبور میکند برای جذب توسعهدهندگان AI، به جای ساخت کنترلرهای ساده یا تراشههای جاسازیشده (Embedded)، به سراغ تولید سیلیکونهای ردهبالای سروری بروند تا بتوانند در بازار رقابت کنند.
با این حال، امید هست که انویدیا در آینده این سختگیریها را کاهش دهد. اگرچه نبود افزونههای برداری یا همگامی PCIe باعث افت عملکرد میشود، اما اینها لزوماً مشکلاتی غیرقابلحل نیستند. برای مثال، شاخههای پیشبینیپذیر میتوانند جایگزین Predication شوند و نامعتبر کردن کشها برای بارهای کاری با نسبت محاسبات به جابجایی داده بالا، قابل قبول باشد.
امید است که الزامات سختگیرانه فعلی صرفاً برای یک پورت اولیه سریع و کمریسک باشد. هدف نهایی جامعه فنی، نسخهای از CUDA است که روی طیف وسیعی از سیستمهای RISC-V قابل دسترسی باشد، نه فقط در طراحیهای خاص و گرانقیمت سازمانی.
نمایش شرکت SiFive در کنفرانس Hot Chips را دنبال کنید تا ببینید آیا بازدهی جفتسازی RISC-V و GPU، هزینههای سختافزاری بالا را توجیه میکند یا خیر.
گام بعدی شما
- اگر توسعهدهنده سختافزار هستید، مستندات پروفایل RVA23 را برای تطبیق با استانداردهای انویدیا بررسی کنید.
- نمایش شرکت SiFive در کنفرانس Hot Chips را دنبال کنید تا ببینید آیا بازدهی جفتسازی RISC-V و GPU، هزینههای سختافزاری بالا را توجیه میکند یا خیر.
- بررسی کنید که آیا نیازهای محاسباتی شما با NVLink Fusion همخوانی دارد یا CUDA استاندارد کافی است.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو