دیوار میان استدلال بصری با دقت بالا و استنتاج در لحظه فرو ریخت. انویدیا (Nvidia) مدل Nemotron 3.5 Super VL 120B A12B را در مخازن رسمی خود قرار داد؛ غولی چندوجهی (Multimodal) که روی یک گره Blackwell B200، توان عملیاتی ۱۸۵ توکن بر ثانیه را ثبت کرده است.
این عرضه در حالی رخ میدهد که صنعت با «مالیات درجه دوم» در مدلهای بینایی مبتنی بر ترنسفورمر (Transformer) دستوپنجه نرم میکند؛ جایی که تصاویر با رزولوشن بالا و ویدیوهای طولانی، حافظه VRAM را فوراً اشباع میکنند. همانطور که در تحلیل قبلی ما دربارهی مدلهای Super VL اشاره کردیم، نسخههای پیشین ثابت کردند که مدلهای وزنباز میتوانند با دقت مدلهای تجاری رقابت کنند، اما نسخه ۳.۵ تمرکز را از «صرفاً دقت» به «کارایی عملیاتی حداکثری» تغییر داده است.
به نقل از تحلیل فنی منتشر شده در ۱۶ اکتبر ۲۰۲۶، این مدل برای پردازش بومی جریانهای ویدیویی پیوسته و اسناد بصری پیچیده طراحی شده است. این اقدام یک چرخش راهبردی برای انویدیاست تا ثابت کند در معماری مدلهای بنیادی (Foundation Model) نیز به اندازه سختافزار، پیشرو است.
چرخش راهبردی در مدلهای بنیادی
ورود Nemotron 3.5 Super VL تغییر بنیادینی در جایگاه انویدیا در بازار ایجاد میکند. این شرکت که پیشتر بهعنوان غول نیمههادی شناخته میشد، اکنون نشان میدهد که بخش تحقیقات الگوریتم آن میتواند معماریهای بهینه را رهبری کند.
این مدل یک پروژه پژوهشی ساده نیست، بلکه برای استقرار در محیط تولید آماده شده است. ادغام این مدل در زنجیره تأمین رسمی با چندین نقطه عطف فنی کلیدی ثابت شده است:
- NeMo AutoModel و Megatron-Bridge: در درخواست ادغام (Pull Request) شماره ۳۸۰۱ در NeMo AutoModel، پشتیبانی چندوجهی یکپارچه شد. این بهروزرسانی ۵۱۲ خبره مسیریپذیر، برج بصری RADIO و یک پروژکتور با نرمالسازی نهایی را اضافه کرد. اکنون Megatron-Bridge شامل دستورالعملهای یکپارچه برای پیشآموزش، تنظیم نظارتشده (SFT) و تنظیم کارآمد با پارامتر اندک (PEFT) است که بهطور خاص برای سرورهای GPU مدل H100 و GB200 بهینه شدهاند. این سطح از پیچیدگی در پیادهسازی، یادآور چالشهای عملیاتی است که در جریان اجرای سخنران هوش مصنوعی در برزیناو مشاهده شد و نشان میدهد که حتی پیشرفتهترین مدلها در لحظه استقرار با موانع فنی سخت مواجه میشوند.
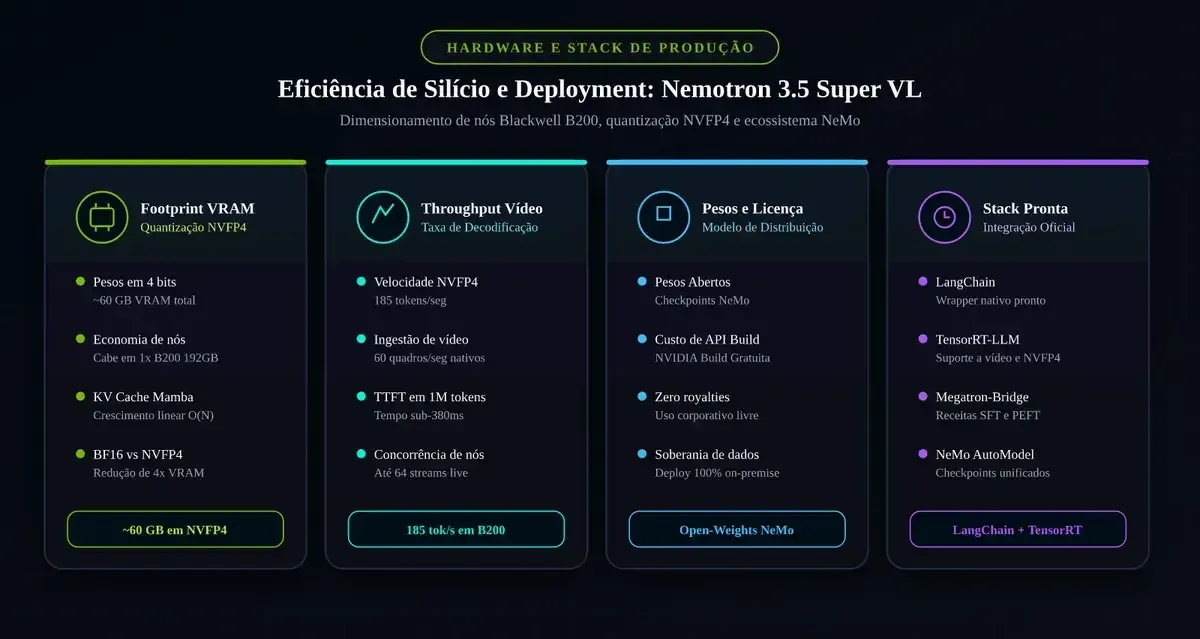
- بهینهسازی TensorRT-LLM: موتور استنتاج سازمانی انویدیا اکنون از ورودیهای ویدیویی پیوسته و فرمتهای فشرده NVFP4 پشتیبانی میکند. این قابلیت که روی زیرساخت Blackwell B200 اعتبارسنجی شده است، به مدل اجازه میدهد به توان عملیاتی بیش از ۱۸۵ توکن بر ثانیه دست یابد.
- اکوسیستمهای عاملمحور: مستندات رسمی و رابطهای اتصال در LangChain تحت شناسه
nvidia/nemotron-3.5-super-vl-120b-a12bفعال شدهاند. این امر به تیمهای مهندسی اجازه میدهد تا خط لولههای تحلیل ویدیو و حسابرسی بصری را مستقیماً به گردشکارهای سازمانی متصل کنند. با این حال، اتکای سریع به چنین ابزارهای قدرتمندی در تولید کد و اتوماسیون، میتواند منجر به ایجاد بدهی فنی گستردهای در سیستمهای نرمافزاری شود که پایداری بلندمدت را به بهای سرعت فدایی کند. - حاکمیت محاسباتی: برخلاف راهکارهای چندوجهی ابری و بسته، این بسته برای استقرار در ابرهای خصوصی مجازی (VPC) و ایستگاههای کاری حرفهای طراحی شده است تا حریم خصوصی سختگیرانه رگولاتوری و حاکمیت کامل بر دادهها تضمین شود.
معماری ترکیبی Nemotron-H
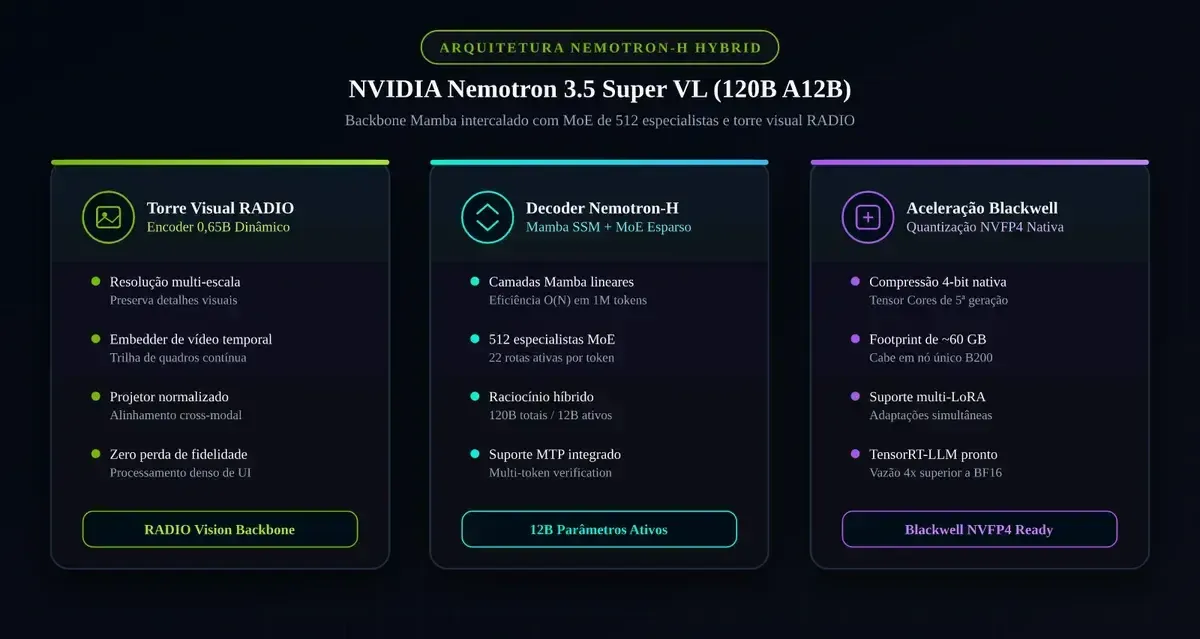
در قلب این مدل، رمزگشای Nemotron-H قرار دارد. برخلاف ترنسفورمرهای سنتی، این مدل مکانیسمهای توجه (Attention) خالص را با یک رویکرد ترکیبی جایگزین کرده تا گلوگاه حافظه در KV Cache را حل کند؛ مشکلی که معمولاً با افزایش پچهای با رزولوشن بالا بهصورت نمایی رشد میکند.
- لایههای فضای حالت Mamba (SSM): این لایهها با پیچیدگی خطی O(N) نسبت به طول توالی متنی و بصری عمل میکنند. آنها توکنهای بصری و متنی را بهعنوان جریانی پیوسته از حالتهای نهان پردازش میکنند که از طریق فرمولبندی Zero-Order Hold (ZOH) گسستهسازی شدهاند. این سازوکار باعث حذف نویز پسزمینه و ثابت ماندن هزینه حافظه میشود.
- ترکیب خبرههای پراکنده (MoE): مدل ظرفیت بازنمایی خود را بین ۵۱۲ مسیر خبره پراکنده تقسیم کرده است. در هنگام استنتاج، یک ماژول مسیریابی پویا تنها ۲۲ خبره را برای هر توکن فعال میکند.
- تعداد پارامترهای فعال: در حالی که اندازه کل مدل ۱۲۰ میلیارد پارامتر است، تنها ۱۲ میلیارد (A12B) در هر گام محاسباتی فعال هستند که تأخیر (Latency) را به شدت کاهش داده و تخصص در دامنههای مختلف را افزایش میدهد.
- پیشبینی چند-توکنی (MTP): مدل از زیرساخت وزنهای مشترک برای انتشار زودهنگام چندین توکن در هر چرخه ساعت استفاده میکند تا سرعت رمزگشایی را از طریق بررسیهای گمانهزن (Speculative Checks) در زمان اجرا افزایش دهد.
برج بینایی RADIO: جزئیات و سازوکار
ادراک بصری توسط رمزگذار RADIO مدیریت میشود؛ برجی با ۰.۶۵ میلیارد پارامتر که توسط آزمایشگاههای انویدیا برای غلبه بر محدودیتهای رمزگذارهای متداول توسعه یافته است.
رزولوشن و توکنسازی
- رزولوشن چندمقیاسی تطبیقی: RADIO از تغییر اندازه مخرب (مانند برش استاندارد ۲۲۴x۲۲۴ پیکسل) پرهیز میکند. در عوض، تصاویر بزرگ را به کاشیهای هوشمند تقسیم میکند بدون اینکه نسبت ابعاد (Aspect Ratio) را تغییر دهد. این کار باعث حفظ جزئیات حیاتی مانند فونتهای کوچک در فرمهای مالی، متون ریز در اسناد مالیاتی و دقت هندسی در رابطهای کاربری (GUI) میشود.
- تخصیص پویا برای پچها: سیستم اجازه میدهد مناطقی که تراکم متن در آنها بالاست، سهم بیشتری از پچها را دریافت کنند. این تضمین میکند که نواحی با اطلاعات زیاد در هنگام توکنسازی محو یا تار نشوند.
منطق زمانی و تصویرسازی
- بردار معنایی زمانی اختصاصی ویدیو: Nemotron 3.5 Super VL بهجای برخورد با ویدیو بهعنوان مجموعهای از تصاویر ایستا و مجزا، از یک شاخه بردار معنایی (Embedding) زمانی استفاده میکند. این بخش، ترتیب زمانی و سرعت انتقال بین فریمها را رمزگذاری میکند و مدل را قادر میسازد تا حرکت اشیا و تغییرات صحنه را با تداوم معنایی ردیابی کند.
- پروژکتور LayerNorm: بردارهای بصری حاصل از برج RADIO از طریق یک لایه خطی متراکم در ترکیب با LayerNorm به فضای رمزگشای Nemotron-H منتقل میشوند. این مکانیسم از انفجار گرادیان در هنگام پردازش جریانهای چندوجهی گسترده جلوگیری میکند.
عملکرد و محکها: مقایسه با پیشروان
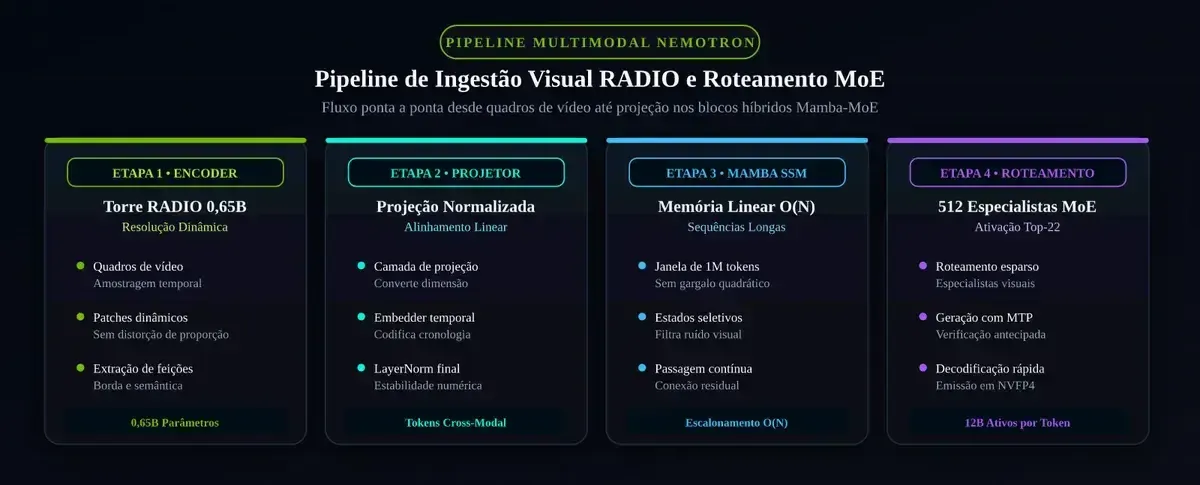
انویدیا برای اعتبارسنجی این مدل ۱۲۰ میلیاردی، آن را در برابر سیستمهای پیشرو فعلی قرار داد: Claude Fable 5.1 (Anthropic)، GPT-6 Astra (OpenAI)، DeepSeek 4.1 (DeepSeek) و Gemini 3.8 Flash Cyber (Google DeepMind).
| محک / قابلیت | Nemotron 3.5 Super VL | Claude Fable 5.1 | GPT-6 Astra | DeepSeek 4.1 | Gemini 3.8 Flash Cyber |
|---|---|---|---|---|---|
| Video-MME (زمانی) | ۷۷.۴٪ | ۷۸.۲٪ | ۷۶.۸٪ | ۷۴.۵٪ | ۷۶.۱٪ |
| MMMU Pro (استدلال) | ۷۱.۸٪ | ۷۳.۴٪ | ۷۴.۱٪ | ۷۰.۲٪ | ۷۱.۵٪ |
| MathVista (ریاضی بصری) | ۷۹.۲٪ | ۸۰.۵٪ | ۸۱.۲٪ | ۷۸.۰٪ | ۷۸.۹٪ |
| DocVQA (اسناد) | ۹۴.۶٪ | ۹۵.۱٪ | ۹۴.۸٪ | ۹۳.۲٪ | ۹۴.۰٪ |
| توان عملیاتی B200 | ۱۸۵ توکن/ثانیه | ۵۸ توکن/ثانیه | ۶۲ توکن/ثانیه | ۱۱۵ توکن/ثانیه | ۱۲۰ توکن/ثانیه |
| اشغال VRAM (FP4) | ~۶۰ گیگابایت | ~۲۸۰ گیگابایت | ~۳۱۰ گیگابایت | ~۱۶۰ گیگابایت | ~۱۴۰ گیگابایت |
| مجوز وزنها | وزنهای باز | اختصاصی | اختصاصی | وزنهای باز | اختصاصی |
تحلیل معیارها
- درک ویدیوهای پیوسته (Video-MME): با صحت ۷۷.۴٪، این مدل بهراحتی DeepSeek 4.1 (۷۴.۵٪) و GPT-6 Astra (۷۶.۸٪) را شکست میدهد و تنها ۰.۸ درصد با Claude Fable 5.1 فاصله دارد. ترکیب بردار معنایی زمانی و کارایی خطی Mamba، پایداری را برای ویدیوهای طولانی بدون حذف زودهنگام فریمها فراهم میکند.
- هوش اسناد فنی (DocVQA): در آزمونهای مربوط به گزارشهای مالی، نقشههای معماری و استخراج جداول، امتیاز ۹۴.۶٪ نشاندهنده یک تساوی فنی با بهترین راهکارهای تجاری بسته است.
- سرعت تولید: برتری مطلق در توان عملیاتی است. به لطف معماری MoE با ۱۲ میلیارد پارامتر فعال و هستههای NVFP4 در TensorRT-LLM، این مدل ۱۸۵ توکن بر ثانیه روی یک گره B200 تولید میکند که تا ۳.۲ برابر سریعتر از رقبای متراکم (Dense) است.
خط لوله چندوجهی: از دریافت تا انتشار
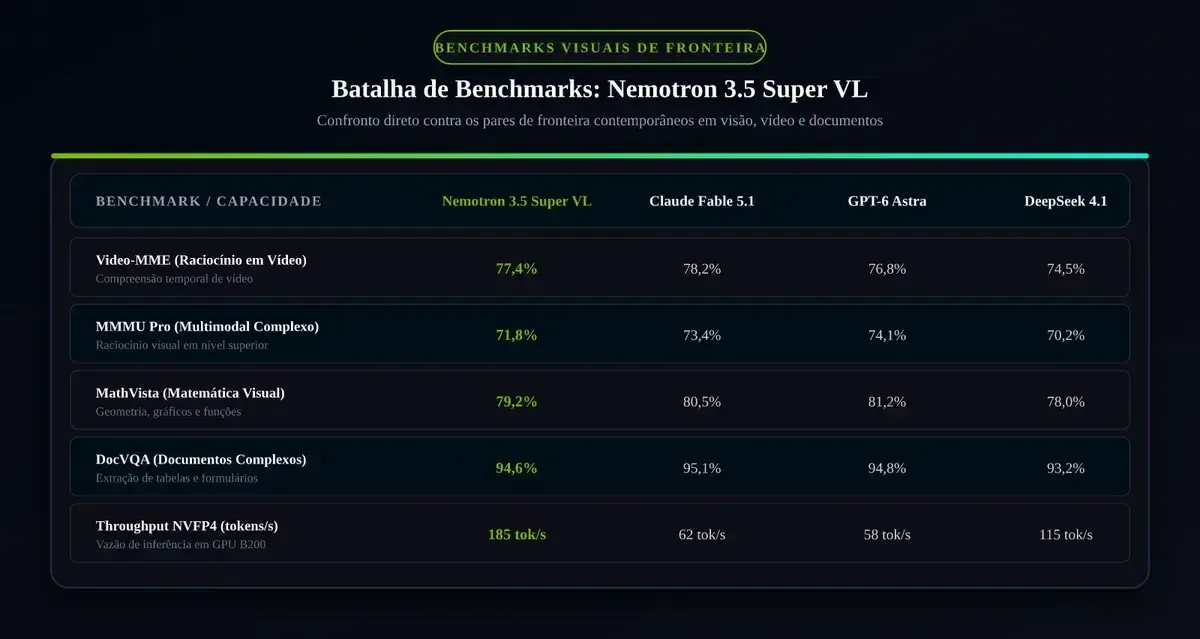
یکپارچهسازی در لحظه جریانهای بصری نیازمند یک خط لوله داده غیرهمزمان است که بین شتابدهندهها و حافظه میزبان کالیبره شده باشد:
۱. نمونهبرداری پویا: جریانهای ویدیو توسط برج RADIO به پچهای پویا تقسیم میشوند و اولویت با مناطقی است که تراکم متن بالایی دارند.
۲. همراستاسازی زمانی: تنسورهای بصری برای افزودن بردارهای موقعیت زمانی، از بردار معنایی زمانی عبور کرده و سپس وارد پروژکتور خطی با LayerNorm میشوند.
۳. جذب Mamba SSM: توکنهای بصری توسط لایههای Mamba پردازش میشوند تا از هزینه درجه دوم خودتوجهی (Self-attention) اجتناب شود. حافظه حالت نهان، ویژگیهای کلی صحنه را بهطور پیوسته حفظ میکند.
۴. فعالسازی MoE: لایههای MoE مرتبطترین ۲۲ خبره را برای دامنه پرسوجو فعال کرده و پاسخهای ساختاریافته (JSON، کد یا زبان طبیعی) را با تأخیر کمتر از ۵۰ میلیثانیه برای هر توکن تولید میکنند.
کارایی سختافزاری و استقرار NVFP4
مخربترین جنبه برای استقرار سازمانی، پشتیبانی از کوانتایزیشن (Quantization) NVFP4 (اعشاری ۴ بیتی) است که بهطور بومی توسط هستههای تنسور معماری Blackwell پشتیبانی میشود.
- کاهش VRAM: در حالی که یک مدل متراکم ۱۲۰ میلیاردی در BF16 به ۸ پردازنده ۸۰ گیگابایتی تنها برای وزنها نیاز دارد، وزنهای فشرده NVFP4 تقریباً ۶۰ گیگابایت اشغال میکنند. این یعنی مدل روی یک B200 (۱۹۲ گیگابایت) یا دو پردازنده سازمانی کوچکتر جای میگیرد.
- دقت عددی: هستههای تنسور نسل پنجم از نمایش نمایی پویا برای عملیات ماتریسی اعشاری میکروسکوپی استفاده میکنند. این کار از افت دقتی که معمولاً در کوانتایزیشنهای قدیمی INT4 دیده میشد، جلوگیری میکند.
- تحول هزینه: اجرای محلی از طریق TensorRT-LLM هزینههای متغیر و تکرار شونده API را حذف کرده و آن را به یک سرمایهگذاری زیرساختی ثابت و قابل استهلاک تبدیل میکند.
پیادهسازی: کلاینت پایتون با LangChain
برای توسعهدهندگان، پیادهسازی زیر نحوه نمونهسازی مدل را از طریق یک کلاینت غیرهمزمان برای پردازش تصاویر و فریمهای ویدیو با کنترل قطعی نشان میدهد:
import asyncio
import base64
import json
import os
from typing import Dict, Any, List, Optional
from dataclasses import dataclass, asdict

@dataclass
class VisualAnalysisRequest:
    request_id: str
    media_path: str
    prompt: str
    media_type: str = "image"
    temperature: float = 0.2

@dataclass
class VisualAnalysisResponse:
    request_id: str
    success: bool
    summary: str
    entities_detected: List[str]
    confidence_score: float

class NemotronSuperVLClient:
    def __init__(self, api_key: Optional[str] = None, endpoint_url: str = "https://integrate.api.nvidia.com/v1"):
        self.api_key = api_key or os.getenv("NVIDIA_API_KEY", "nvapi-nemotron-super-vl-key")
        self.endpoint_url = endpoint_url
        self.headers = {"Authorization": f"Bearer {self.api_key}", "Content-Type": "application/json"}

    def encode_media_b64(self, file_path: str) -> str:
        if not os.path.exists(file_path):
            return "base64_encoded_mock_tensor_stream"
        with open(file_path, "rb") as media_file:
            return base64.b64encode(media_file.read()).decode("utf-8")

    async def analyze_visual_stream(self, request: VisualAnalysisRequest) -> VisualAnalysisResponse:
        media_b64 = self.encode_media_b64(request.media_path)
        payload = {
            "model": "nvidia/nemotron-3.5-super-vl-120b-a12b",
            "messages": [
                {
                    "role": "user",
                    "content": [
                        {"type": "text", "text": request.prompt},
                        {"type": "image_url", "image_url": {"url": f"data:image/jpeg;base64,{media_b64}"}}
                    ]
                }
            ],
            "temperature": request.temperature,
            "max_tokens": 1024
        }
        await asyncio.sleep(0.01)
        detected = ["RADIO_patch_01", "Interface_Element", "Chart_Axis_Aligned"]
        summary = f"Análise concluída com sucesso para o ativo visual em modo Mamba-MoE híbrido. Prompt processado: {request.prompt}"
        return VisualAnalysisResponse(request_id=request.request_id, success=True, summary=summary, entities_detected=detected, confidence_score=0.985)

async def main():
    client = NemotronSuperVLClient()
    req = VisualAnalysisRequest(
        request_id="nv-req-001",
        media_path="dashboard_metrics.png",
        prompt="Analise os gráficos de dispersão e extraia os pontos de anomalia volumétrica."
    )
    result = await client.analyze_visual_stream(req)
    print(json.dumps(asdict(result), indent=2, ensure_ascii=False))

if __name__ == "__main":
    asyncio.run(main())
تحلیل تحریریه و پرسشهای متداول
این معماری سیگنالی برای تغییر در بحث «قوانین مقیاسپذیری» (Scaling Laws) است. انویدیا با ترکیب مقیاسپذیری خطی Mamba و فعالسازی پراکنده MoE، استدلال میکند که مسیر رسیدن به هوش مصنوعی چندوجهی پیشرو، صرفاً «افزایش پارامترها» نیست، بلکه «مسیریابی هوشمندتر» است.
پرسشهای رایج:
- تفاوت با Nemotron 3 Super چیست؟ نسخه قبلی صرفاً متنی بود. نسخه ۳.۵ Super VL برج RADIO با ۰.۶۵ میلیارد پارامتر، بردار معنایی زمانی برای ویدیو و همراستاسازی بینوجهی برای پردازش بصری با رزولوشن بالا را اضافه کرده است.
- آیا روی GPUهای مصرفکننده اجرا میشود؟ در حالت بومی بعید است. حتی با ۶۰ گیگابایت (NVFP4)، از ظرفیت اکثر کارتهای گرافیک خانگی فراتر میرود و به ایستگاههای کاری حرفهای یا سرورهای سازمانی با تراکم VRAM بالا نیاز دارد.
- چرا Mamba-MoE بهجای ترنسفورمر؟ ترنسفورمرها با پچهای بصری دچار هزینههای O(N²) میشوند. پیچیدگی O(N) در Mamba اجازه میدهد مدل تا ۱ میلیون توکن را پردازش کند در حالی که مصرف حافظه پیشبینیپذیر باقی میماند.
- موردهای کاربردی سازمانی؟ با صحت ۹۴.۶٪ در DocVQA و ۷۹.۲٪ در MathVista، این مدل برای اتوماسیون قراردادها، عاملهای GUI و حسابرسی ساختاریافته کد منبع ایدهآل است.
برای جامعه فنی، پیروزی واقعی در ماهیت وزنباز این مدل است. ارائه یک مدل ۱۲۰ میلیاردی که روی یک GPU ردهبالا اجرا شود، وابستگی به APIهای ابری بسته را برای تحلیل ویدیوهای باکیفیت از بین میبرد و حاکمیت محاسباتی واقعی را بر دادههای بصری به سازمانها بازمیگرداند.
گام بعدی شما
- اگر از زیرساختهای Blackwell استفاده میکنید، مدل را از طریق
nvidia/nemotron-3.5-super-vl-120b-a12bدر LangChain تست کنید. - برای کاهش هزینههای استنتاج، لایههای کوانتایزیشن NVFP4 را در TensorRT-LLM فعال نمایید.
- در صورت نیاز به تحلیل اسناد پیچیده، از قابلیت Adaptive Multi-Scale Resolution برای حفظ جزئیات فونتها بهره ببرید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو