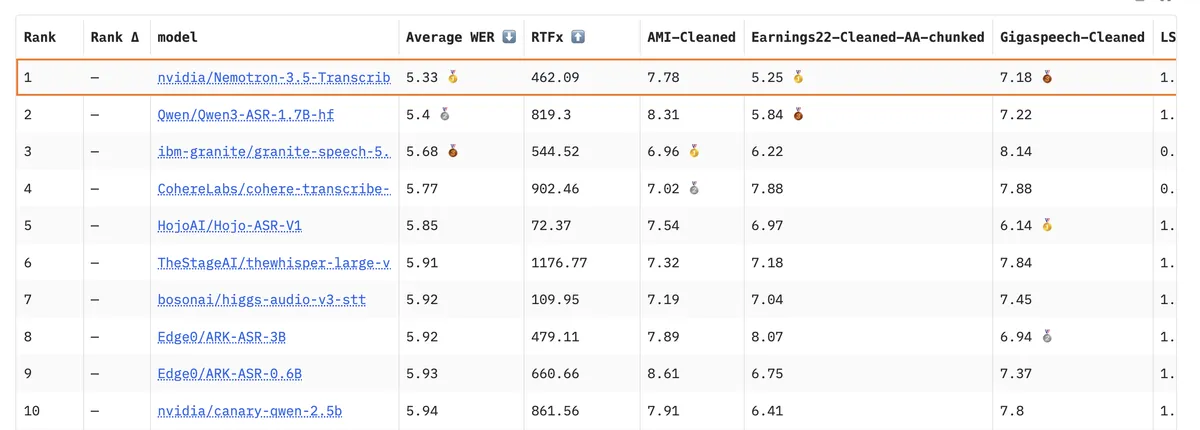
انویدیا مدل Nemotron 3.5 Transcribe را با وزنهای باز (Open Weights) منتشر کرد؛ مدلی که رونویسی، ترجمه، تفکیک گوینده و پرسشوپاسخ صوتی را در یک نقطهٔ بازرسی (Checkpoint) جمع میکند. این مدل با میانگین نرخ خطای کلمه (WER) ۵٫۳۳ درصد، در لیدربورد Open ASR هاگینگ فیس اول مدلهای وزنباز شد.
به گفتهٔ انویدیا، تنظیم دقیق (Fine-tuning) این مدل با دادههای پزشکی، خطای رونویسی را روی گویندگانی که در تنظیم دیده نشده بودند بهطور نسبی ۴۵٫۸ درصد کم کرد. خط لولهٔ داده Granary v2 هم همراه مدل بهصورت باز منتشر شده است.
یک مدل بهجای چند ابزار
بازشناسی گفتار سالها میان ابزارهای جداگانه تقسیم شده بود: یک مدل برای رونویسی، یکی برای ترجمه و یکی دیگر برای برچسبگذاری گوینده. توسعهدهندگان این ابزارها را به هم وصل میکردند و بهایش را با تأخیر، پیچیدگی و انتقال خطا از یک مرحله به مرحلهٔ بعد میپرداختند.
مدل تازهٔ انویدیا این مجموعه را در یک مدل پرامپتپذیر جمع میکند. این مدل از رونویسی در ۴۰ زبان، ترجمه در ۳۱ زبان و تفکیک گوینده در ۱۳ زبان پشتیبانی میکند. همهٔ این کارها روی یک واحد پردازش گرافیکی (GPU) اجرا میشود؛ از دستگاههای لبه تا سیستمهای Blackwell در مرکز داده. پشتیبانی از ۴۰ زبان برای رونویسی و ۳۱ زبان برای ترجمه، در حالی است که مایکروسافت مدل MAI-Transcribe-2 را برای ۶۰ زبان عرضه کرد و پوشش زبانی گستردهتری ارائه داد.
این عرضه در زمانی است که سازمانها عاملهای صوتی را وارد محیط عملیاتی میکنند. آنها به خروجی دقیق و قابل کنترل نیاز دارند، بیآنکه صدا را به APIهای خارجی بفرستند. مدلهای وزنبازی که به کیفیت APIهای اختصاصی برسند، اقتصاد استقرار درونسازمانی را تغییر میدهند. انویدیا در کنار مدل، Granary v2 را هم عرضه کرده است؛ خط لولهای باز برای گزینش و پالایش داده که نسخههای مختلف متن را میسازد و مدل یاد میگیرد آنها را بنا به دستور تولید کند.
معماری Nemotron 3.5 Transcribe و پوشش زبانی
Nemotron 3.5 Transcribe یک رمزگذار گفتار را با یک مدل زبانی ترکیبی از نوع Mamba–Transformer mixture-of-experts جفت میکند. از ۳۰ میلیارد پارامتر مدل، فقط حدود ۴ میلیارد برای هر توکن فعال میشود. همین فعالسازی پراکنده، مدل را روی مرز پارتو (Pareto frontier) شرکت Artificial Analysis برای صحت در برابر پارامترهای فعال قرار داده است.
- طول ضبط: تا یک ساعت
- تعداد گویندهها: تا هشت نفر
- رونویسی: ۴۰ زبان
- ترجمه: ۳۱ زبان، به انگلیسی یا از انگلیسی
- تفکیک گوینده: ۱۳ زبان
- پرسشوپاسخ صوتی: آموزشدیده به زبان انگلیسی
نتایج Nemotron 3.5 Transcribe در چهار محک
طبق اعلام انویدیا، این مدل در محکهای عمومی اصلی گفتار نتایج پیشرو ثبت کرده است:
- لیدربورد Open ASR هاگینگ فیس (انگلیسی): میانگین WER ۵٫۳۳ درصد و رتبهٔ اول میان مدلهای وزنباز
- لیدربورد Speech-to-Text شرکت Artificial Analysis: شاخص AA-WER برابر ۲٫۸۰ درصد و رتبهٔ اول مشترک میان مدلهای وزنباز، با حدود ۴ میلیارد پارامتر فعال؛ یعنی یکششم پارامترهای فعال مدلی که با آن همرتبه است
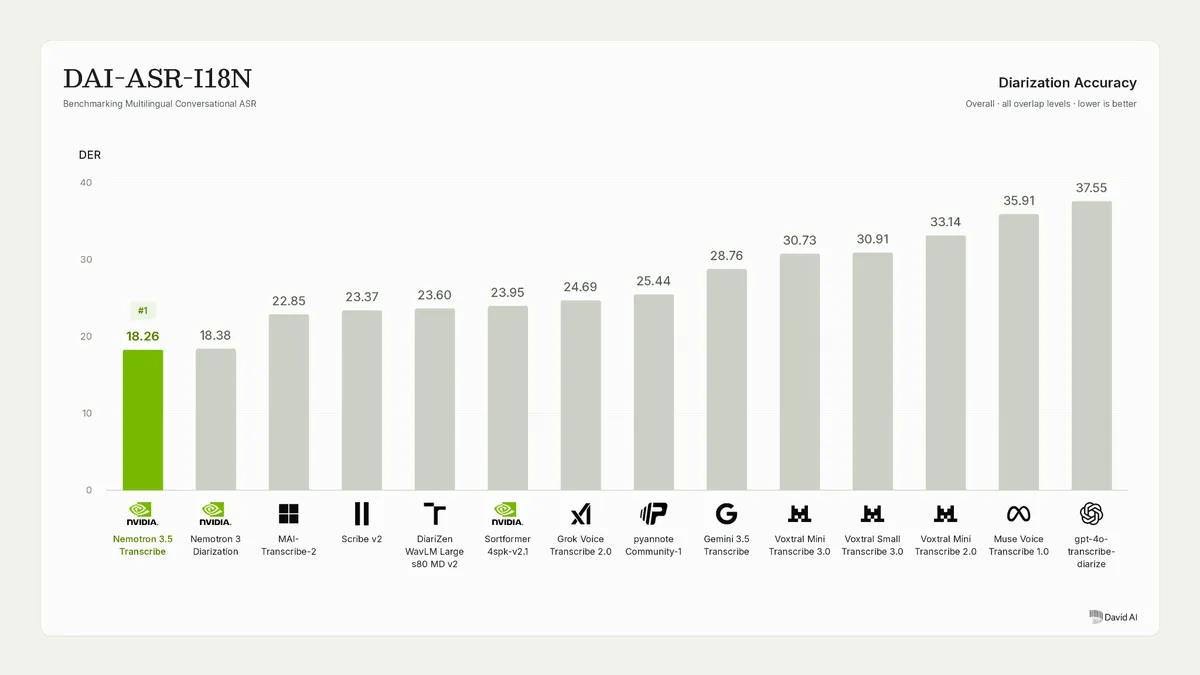
- محک DAI-ASR-I18N از David AI (۲۱ زبان): نرخ خطای تفکیک گوینده (DER) ۱۸٫۲۶ درصد؛ کمترین خطا میان ۱۴ سیستم آزمایششده
- محک Diarization-Bench v1 از VoiceArena (جلسههای کامل انگلیسی): cpWER برابر ۳۲٫۴ درصد و رتبهٔ اول میان ۱۴ سیستم، با کمترین کلمهٔ حذفشده (۸٫۳۲ درصد در برابر میانهٔ حدود ۳۱ درصد)
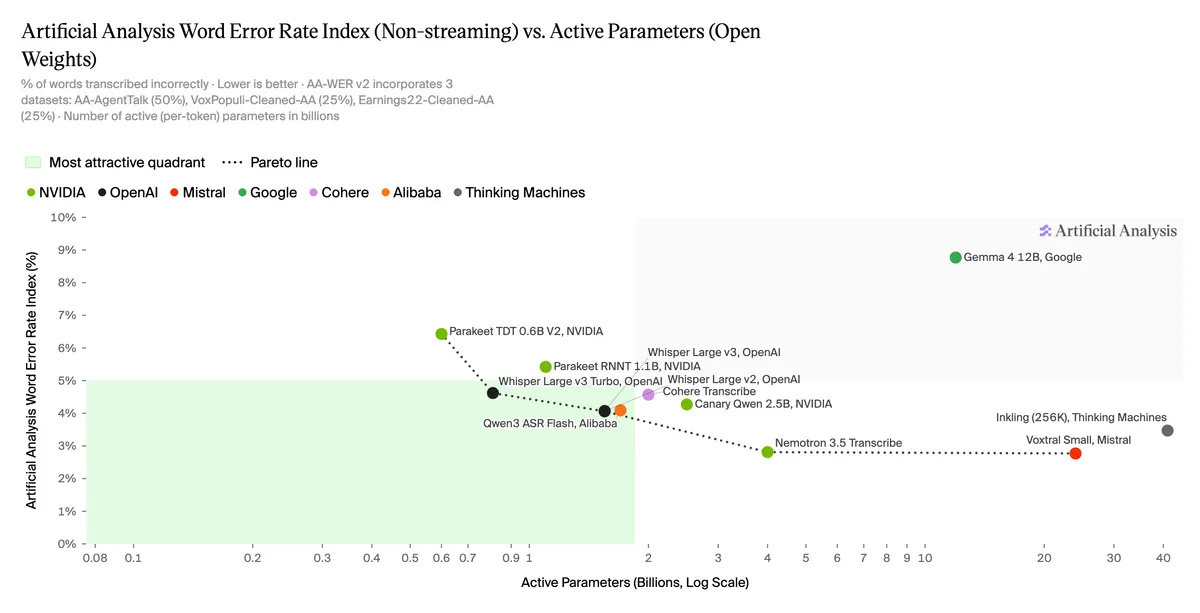
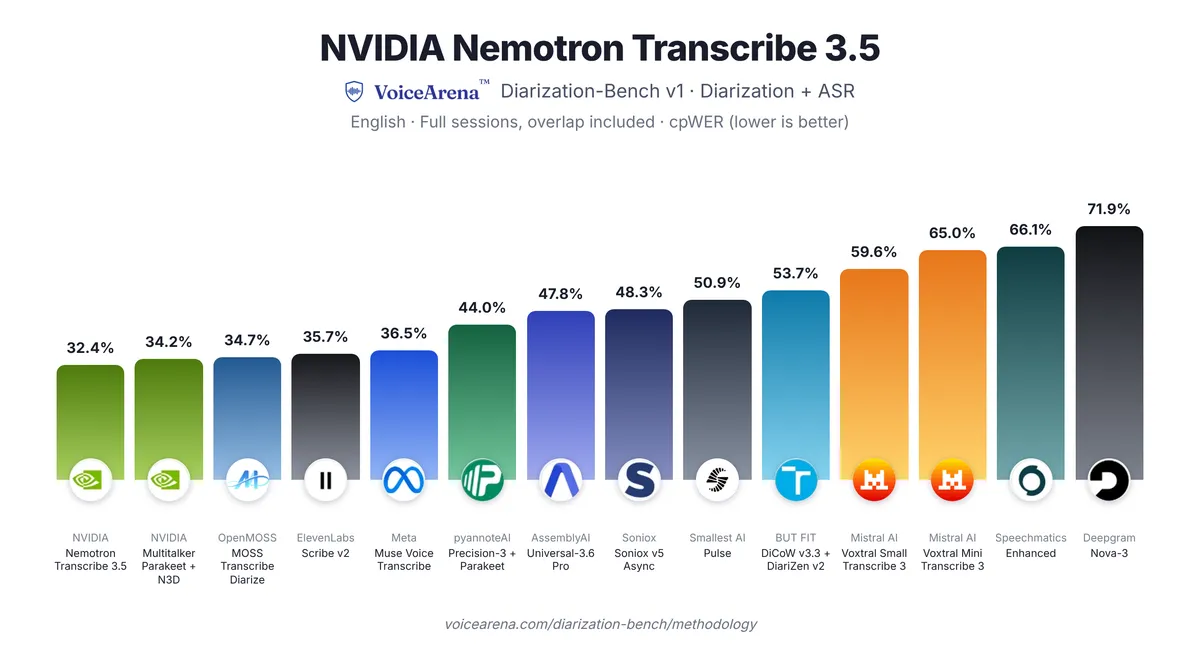
در مجموعهٔ AA-AgentTalk که از گفتار عاملهای صوتی ساخته شده و ۵۰ درصد شاخص AA-WER را تشکیل میدهد، Transcribe به WER ۱٫۸ درصد رسید. بهترین مدل وزنباز بعدی در این مجموعه ۲٫۳ درصد خطا داشت. ارزیابی Converse-STT شرکت Ocular AI هم Transcribe را بهترین مدل باز معرفی کرده و لیدربورد Voice of India از Josh Talks نتایج آن را در زبانهای هندی گزارش داده است. این نتایج در حالی به دست آمده است که تأخیر زیر یک ثانیه در ترجمهٔ زنده؛ محک ۱۲ ابزار پیشرو در سال ۲۰۲۶ نشان میدهد سرعت در ابزارهای صوتی و ترجمهای چقدر حیاتی است.
رقابت نزدیک با مدلهای دیگر انویدیا
در بخش تفکیک گوینده محک David AI، مدل Nemotron 3 Diarization با DER ۱۸٫۳۸ درصد نزدیکترین رقیب بود. در VoiceArena هم ترکیب NVIDIA Multitalker Parakeet و Nemotron 3 Diarization با cpWER ۳۴٫۲ درصد دوم شد. محک Diarization-Bench v1 جلسههای کامل انگلیسی، گفتار همپوشان و جلسههای ۲ تا ۸ نفره را پوشش میدهد.
- cpWER: خطای کلمه را پس از تطبیق برچسب گویندهها میشمارد؛ عدد کمتر بهتر است.
- DER: خطا در تعیین زمان صحبت هر گوینده را میسنجد؛ عدد کمتر بهتر است.
کنترل با پرامپت بهجای سرهمکردن ابزارها
یک نقطهٔ بازرسی واحد از یک فایل صوتی، بسته به دستور زبان طبیعی، خروجیهای متفاوتی میسازد:
- «این ضبط را رونویسی کن و هر گوینده را برچسب بزن.»
- «این صدا را به انگلیسی ترجمه کن.»
- «در این جلسه چه تصمیمهایی گرفته شد؟»
کارت مدل شامل پیشتنظیمهای پیشنهادی، راهنمای کامل پرامپتنویسی و جدول پشتیبانی هر کار به تفکیک زبان است. مدل از برچسب زمانی در سطح کلمه (Word-level Timestamps) هم پشتیبانی میکند.
برای اصطلاحات تخصصی، کاربران میتوانند پیش از سراغ تنظیم دقیق رفتن، زمینه را در پرامپت بدهند. نمونهٔ انویدیا برای حوزهٔ پزشکی این است: «این گفتوگوی پزشکی را به زبان اصلی رونویسی کن. اصطلاحات احتمالی: HbA1c، متفورمین. این اصطلاحات را فقط وقتی به کار ببر که صدا آنها را تأیید کند. املای استاندارد پزشکی را حفظ کن و اعداد را به شکل نوشتاری متعارف بنویس.»
نمونههای کاربرد
Agora، پلتفرم صوت و تصویر بلادرنگ، از برچسبهای زمانی سطح کلمه استفاده میکند تا متن کلاس را با بازپخش آن همزمان کند. به این ترتیب دانشآموزان میبینند چه چیزی، چه زمانی گفته شده است. Agora جزئیات ساخت این قابلیت را در وبلاگش شرح داده است.
انویدیا در ویدیویی، مدل را روی صحنهای از کمدی His Girl Friday محصول ۱۹۴۰ آزموده است؛ فیلمی که به دیالوگهای تند و پرهمپوشانی معروف است. Nemotron 3.5 Transcribe برای این صحنه زیرنویس میسازد و گویندهها را، حتی در دیالوگهای همپوشان، برچسب میزند. انویدیا توصیه میکند مثل هر مدل گفتاری دیگر، نامها، تغییر گوینده و پاسخها را با فایل اصلی مقایسه کنید.
Granary v2؛ خط لولهٔ باز داده پشت مدل
مانیفست عمومی Granary v2 شامل ۴۶۳٬۰۶۲ ساعت صدا در ۴۸ زبان و از ۱۶ پیکرهٔ منبع است. نسخهٔ اول این مجموعه ۲۵ زبان داشت. این ارقام مربوط به مجموعهدادهٔ منتشرشده است، نه کل دادههای آموزشی Transcribe یا وزن نمونهبرداری آن.
خط لوله برای هر ضبط سه شکل متن تولید میکند:
- نرمالسازی متن، کلمهبهکلمه: «پرداختم، اِ، بیستوپنج یورو.»
- نرمالسازی معکوس متن، با مکثها و تپقها: «پرداختم، اِ، ۲۵€.»
- نرمالسازی معکوس متن، بدون مکثها و تپقها: «۲۵€ پرداختم.»
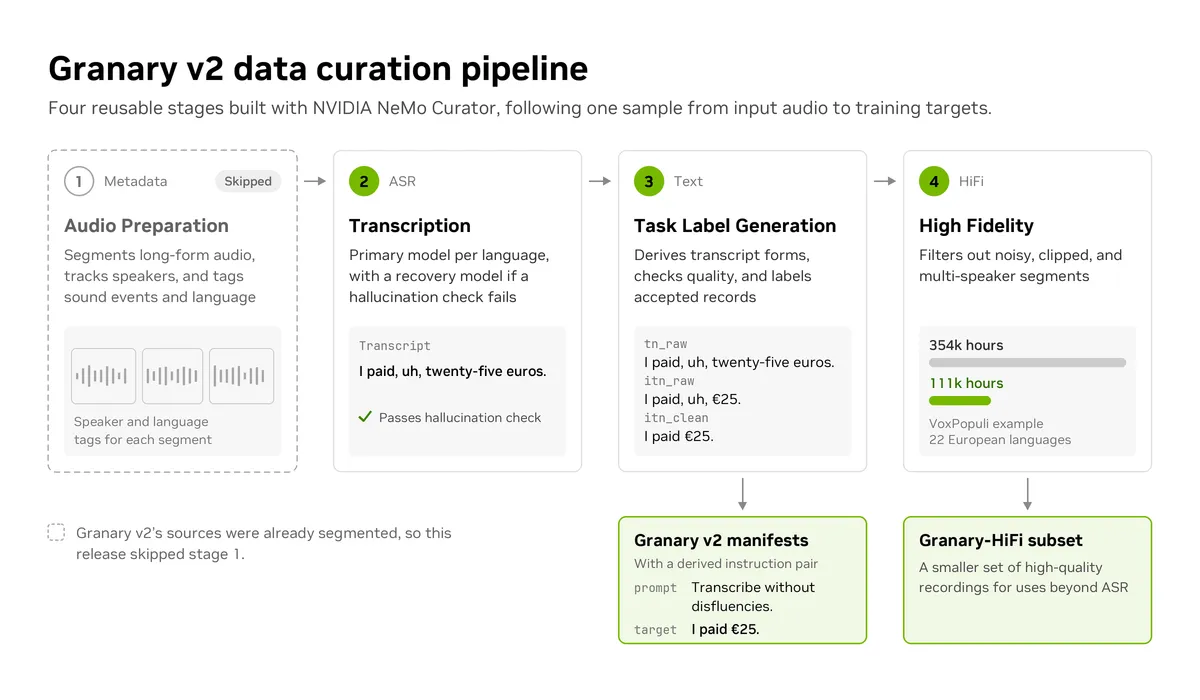
این خط لولهٔ چهارمرحلهای شامل Metadata، ASR، Text و HiFi است. هر زبان را به یک مدل ASR اصلی و یک مدل پشتیبان میسپارد، با بررسی توهم سراغ مدل پشتیبان میرود، نسخههای مختلف متن را میسازد و بخشهای پرنویز یا چندگوینده را کنار میگذارد. برای پیکرهٔ VoxPopuli، مرحلهٔ HiFi حجم داده را از ۳۵۴ هزار ساعت به ۱۱۱ هزار ساعت در ۲۲ زبان اروپایی کاهش داد.
توسعهدهندگان میتوانند خط لولهٔ NeMo Curator را با بکاندهای Ray و NVIDIA Dynamo روی ضبطهای خود یا پیکرههای عمومی مجاز اجرا کنند. راه دیگر، استفاده از مانیفستهای عمومی Granary v2 است.
مراحل خط لوله
- مرحلهٔ ۱، آمادهسازی صدا (Metadata): صدای خام یا طولانی را قطعهبندی میکند، گویندهها را در کل ضبط دنبال میکند و رویدادهای صوتی و زبان را برچسب میزند. منابع Granary v2 از قبل قطعهبندی شده بودند و این مرحله در این نسخه اجرا نشد.
- مرحلهٔ ۲، رونویسی (ASR): هر زبان را به مدل اصلی و مدل پشتیبان میسپارد و اگر مدل اصلی در بررسی توهم رد شود، مدل پشتیبان وارد عمل میشود. متنهای مرجع انسانی کمک میکنند املای معتبر حفظ شود و در عین حال شکل گفتاری و تپقها هم اضافه شوند.
- مرحلهٔ ۳، تولید برچسب کار (Text): نسخههای متن را میسازد و سپس نرخ کاراکتر، الگوهای توهم و میزان توافق با مدل یا مرجع انسانی را بررسی میکند. فقط رکوردهای پذیرفتهشده اصطلاحات سوگیری ASR زمینهمحور (contextual ASR biasing terms) و ترجمه دریافت میکنند.
- مرحلهٔ ۴، وفاداری بالا (HiFi): بخشهای پرنویز، بریده یا چندگوینده را حذف میکند و مجموعهٔ کوچکتری از ضبطهای باکیفیت را برای کاربردهایی فراتر از ASR نگه میدارد.
محتوای مانیفستها
مانیفستها سه شکل متن را با نامهای tn_raw، itn_raw و itn_clean در خود دارند. برچسبهای یادشده، راهنمای موجودیتها، جفتهای دستورالعمل مشتقشده، اطلاعات منشأ داده (provenance) و یک نشانگر کیفیت برای هر رکورد هم در آنها هست. صدای منبع را باید جداگانه و طبق مجوز اصلی هر پیکره دانلود کرد و شرایط منتشرشدهٔ این عرضه را رعایت کرد.
خط لوله جز رونویسی این خروجیها را هم تولید میکند:
- توضیح کوتاه صوتی
- بازگرداندن واژههای قرضی در گفتار دوزبانه (code-switching)
- جفتهای پرسشوپاسخ متکی بر گفتار
- اصطلاحات سوگیری ASR زمینهمحور
- ترجمه همراه با امتیاز کیفیت خودکار
مطالعهٔ موردی پزشکی: کاهش ۴۵٫۸ درصدی خطا
روی محک گفتار پزشکی هندی Eka Care، شامل ۳٬۶۱۹ کلیپ و بدون بخش آموزشی مشخص، روند بهبود چنین بود:
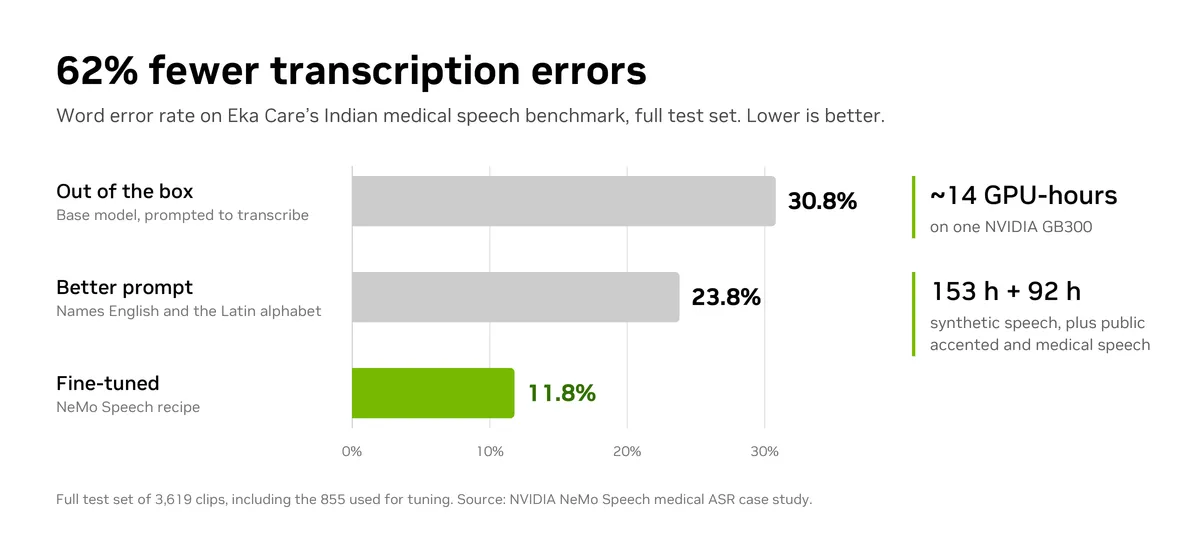
- WER مدل بدون تغییر: ۳۰٫۸ درصد
- با پرامپتی که زبان انگلیسی و خط لاتین را مشخص میکند: ۲۳٫۸ درصد
- پس از تنظیم دقیق: ۱۱٫۸ درصد (۶۲ درصد خطای کمتر از حالت پایه)
دستور تنظیم دقیق
دادههای تنظیم دقیق از سه منبع آمده است: حدود ۱۵۳ ساعت گفتار مصنوعی که با چند صدای TTS از متن پزشکی ساخته شد، ۲۹ ساعت انگلیسی با لهجه از Common Voice و ۶۳ ساعت ضبط پزشکی از MultiMed. هدفهای آموزشی در نوشتن ارقام، فاصلهٔ واحدها، باز کردن نام شرکتها و خط تیرهٔ نامهای تجاری تنوع دارند و دستورالعمل هر نمونه قاعدهٔ لازم را مشخص میکند. برخی پرامپتها گزینههای گمراهکنندهٔ نزدیک به درست دارند تا مدل یاد بگیرد هر املا را فقط وقتی به کار ببرد که صدا آن را تأیید کند.
در این روش، رمزگذار گفتار و لایهٔ projection آموزش میبینند و مدل زبانی با لورا (LoRA) تطبیق داده میشود. دو اجرای آموزشی با ترکیب دادههای متفاوت ادغام و بهطور یکنواخت میانگینگیری شدند. نقطهٔ بازرسی بر اساس نتایج رمزگشاییشدهٔ مجموعهٔ توسعه انتخاب شد، نه فقط زیان آموزش. کل فرایند تطبیق حدود ۱۴ ساعت-GPU روی یک NVIDIA GB300 زمان برد.
نتایج روی گویندگان دیدهنشده
پژوهشگران محک را بر اساس گوینده تقسیم کردند: ۸۵۵ کلیپ برای تنظیم، یعنی انتخاب پرامپت و نقطههای بازرسی، و ۲٬۷۶۴ کلیپ کنارگذاشته که برای هر سیستم نهایی فقط یک بار رمزگشایی شد. با خط لولهٔ امتیازدهی KARMA از Eka Care، تنظیم دقیق WER این کلیپها را از ۲۲٫۴۴ درصد در بهترین حالت پرامپت به ۱۲٫۱۷ درصد رساند. این کاهش نسبی ۴۵٫۸ درصدی روشنترین شاهد است که بهبود به گویندگان جدید هم تعمیم پیدا میکند.
- WER کلیدواژهها: از ۹٫۲ به ۶٫۵ درصد
- WER معنایی: از ۱۰٫۰ به ۷٫۶ درصد
- مقایسه روی همان گویندگان و همان امتیازدهنده: ۱۲٫۱۷ درصد در برابر ۱۳٫۷۹ درصد یک مدل باز تخصصی پزشکی و ۱۴٫۹۲ درصد یک مدل ASR عمومی پرکاربرد
- انگلیسی عمومی: WER در LibriSpeech test-clean اندکی از ۱٫۵۴ به ۱٫۶۹ درصد افزایش یافت
مدل تخصصی پزشکی همچنان در تطابق دقیق نام تجاری داروها و آزمایشهای تشخیصی جلوتر است. مطالعه گام بعدی را استفاده از ضبطهای واقعی پزشکانی میداند که نامهای تجاری را به زبان میآورند.
جزئیات تولید داده
در تولید دادهٔ مصنوعی، شکل نوشتاری هدف از شکل گفتاری آن جدا میشود: «HbA1c» برچسب است و «H B A one C» به سنتزکنندهٔ گفتار فرستاده میشود. صداهای مختلف TTS تنوع صوتی را بیشتر میکنند و ضبطهای واقعی لهجهها و شرایط ضبط گوناگون را اضافه میکنند. متن آموزشی از نظر تطابق کامل و دنبالههای هشتکلمهای مشترک با متن مرجع محک پالایش شد. مانند هدفهای صریح Granary v2، نمونهها در نوشتن ارقام و نامها تنوع دارند و دستورالعمل، قاعدهٔ لازم را مشخص میکند. سیستم نهایی با یک پرامپت ثابت برای قواعد نگارشی و یک بار اجرای مدل کار میکند، بدون بازیابی یا پسپردازش متن.
استقرار و تنظیم دقیق Nemotron 3.5 Transcribe
مدل روی یک GPU انویدیا اجرا میشود؛ از Jetson AGX Thor و DGX Spark تا GPUهای Blackwell مرکز داده. روی یک RTX PRO 6000 Blackwell Server Edition با Precision از نوع NVFP4، مدل ۱۰۰ ساعت صدا را در کمتر از سه دقیقه پردازش میکند. این عدد با کلیپهای ۳۰ ثانیهای و در همزمانی بالا اندازهگیری شده است.
- اجرا روی سرور با vLLM یا بهصورت محلی با NeMo-Speech.cpp
- سرویس میزبانیشده از Baseten، DeepInfra و Simplismart
- مناسب صدای ضبطشده، نه پخش زنده (live streaming)
برای تطبیق با یک حوزهٔ خاص، نقطهٔ شروع مانیفستهای Granary v2 روی هاگینگ فیس یا ModelScope و مطالعهٔ موردی پزشکی است. یک مهارت عامل کدنویسی (coding agent skill) کار را از انتخاب مدل پایه تا اعتبارسنجی آموزش، ادغام آداپتور (لایهٔ سازگارساز) و ارزیابی پیش میبرد. ModelScope هم امکان تنظیم دقیق با چارچوب ms-swift را برای کاربردهای چندوجهی تخصصی فراهم کرده است.
آموزشهای تنظیم دقیق، دستورها، منابع لازم و ابزارهای آموزش، خروجیگرفتن و ارزیابی را پوشش میدهند؛ از جمله ASR برای زبان جدید و گفتار دوزبانه. انویدیا توصیه میکند دستکم ۱۰۰ کلیپ واقعی برچسبخورده برای انتخاب نقطهٔ بازرسی نگه دارید. همچنین موجودیتهایی را که برنامهتان به آنها وابسته است، همراه با حفظ کیفیت گفتار عمومی ارزیابی کنید.
منابع منتشرشده
- نقطههای بازرسی مدل: روی هاگینگ فیس و ModelScope، بههمراه دموی تعاملی روی هر دو
- سرویسهای میزبانیشده: Baseten، DeepInfra و Simplismart
- مانیفستهای داده: Granary v2 روی هاگینگ فیس و ModelScope
- زیرمجموعهٔ High Fidelity: مانیفستها روی هاگینگ فیس و ModelScope و یک Space روی هاگینگ فیس
- مخزنها و آموزشها: مخزن NVIDIA NeMo Speech در GitHub، خط لولهٔ Granary v2 در NeMo Curator، راهنمای استقرار vLLM، راهنمای تنظیم دقیق گفتار و مهارت عامل تنظیم دقیق
- وبلاگ شرکا: Agora، Inflection AI، VoiceArena و Simplismart
- هوش مصنوعی محلی: تازههای اجرای محلی روی رایانهها و لپتاپهای NVIDIA RTX و DGX Spark
آنچه باید دنبال کرد
این عرضه یک مدل واحد، قابل کنترل و وزنباز در اختیار توسعهدهندگان میگذارد که در محکهای عمومی همتراز یا بهتر از APIهای اختصاصی است و روی سختافزار خودشان اجرا میشود. Granary v2 فرایند گزینش داده را شفاف و تکرارپذیر میکند؛ چیزی که در بازشناسی گفتار کمیاب است. مطالعهٔ پزشکی هم نشان میدهد روش تنظیم دقیق روی گویندگان جدید جواب میدهد، نه فقط روی کلیپهای آموزشی.
با عمومی شدن خط لوله و نقطههای بازرسی، باید منتظر نسخههای تنظیمشدهٔ جامعهٔ توسعهدهندگان برای حوزههای حقوقی و مالی و زبانهای کممنبع بود. پرسش بعدی این است که توسعهدهندگان با چه سرعتی مدل را با استنتاج تکهای (chunked inference) برای پخش زنده تطبیق میدهند.
گام بعدی شما
- دموی تعاملی را روی هاگینگ فیس یا ModelScope با فایلهای صوتی خودتان امتحان کنید و رونویسی، ترجمه و تفکیک گوینده را بسنجید.
- برای حوزهٔ تخصصی خود، مانیفستهای Granary v2 و آموزشهای تنظیم دقیق را بررسی کنید.
- پیش از استقرار، مدل را روی ضبط گویندگانی بیازمایید که در دادههای تنظیم نبودهاند.
گفتگو