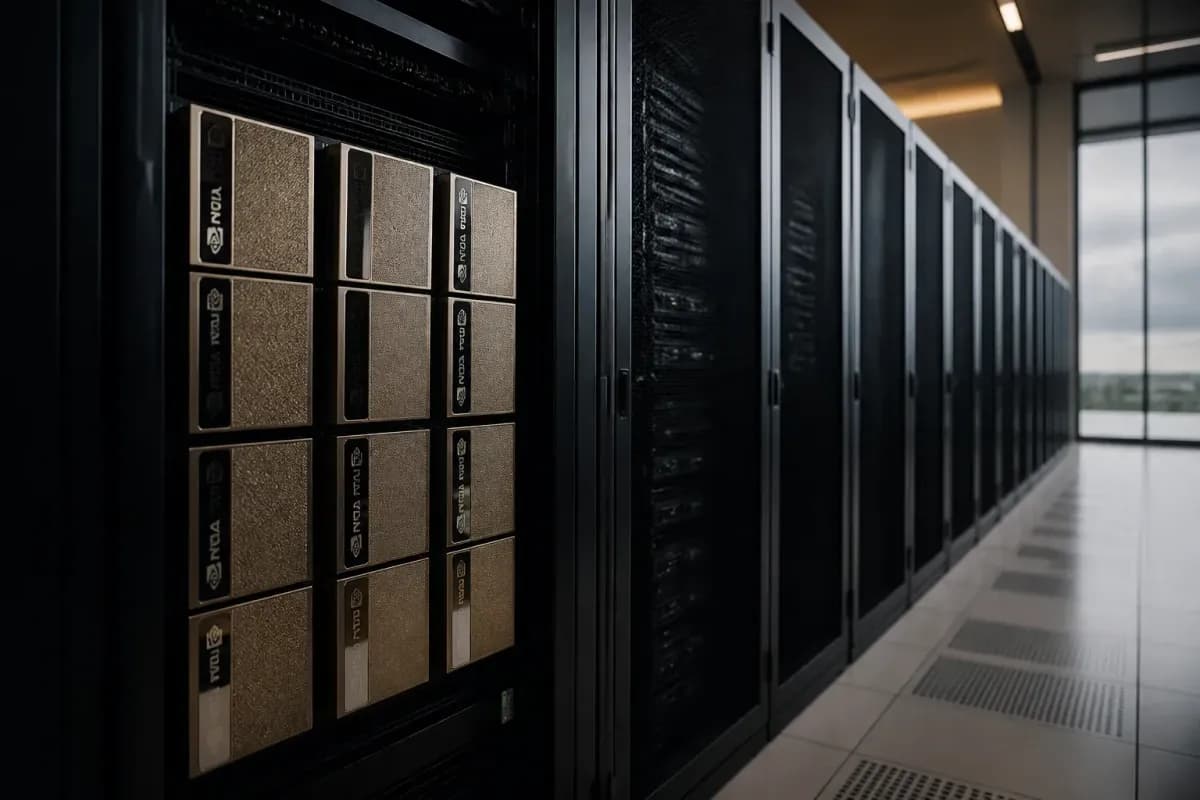
تصور کنید به جای خرید دهها کامپیوتر مجزا، یک ابرکامپیوتر واحد داشته باشید که تمام قطعاتش با سرعت نور با هم حرف میزنند. این دقیقاً همان تغییری است که اکنون در قلب زیرساختهای OpenAI رخ داده است.
انویدیا (NVIDIA) در گزارش سود سهام خود برای سه ماهه دوم ۲۰۲۶، OpenAI را به عنوان یکی از «سازندگان مدلهای فانوس دریایی» (Lighthouse model builders) توصیف کرد. طبق اعلام این شرکت در متن پیادهشدهی تماس سود سهام، OpenAI در حال استقرار سیستم GB200 NVL72 در مقیاس مرکز داده است تا از آن برای پیشآموزش (Pretraining) مدلهای نسل بعد و استنتاج (Inference) — یعنی همان لحظهای که مدل واقعاً جواب تولید میکند، شبیه به آشپزی بعد از یادگیری دستور پخت — در محیط عملیاتی استفاده کند. این چرخش نشان میدهد رقابت برای رسیدن به هوش مصنوعی پیشرو، دیگر بر سر این نیست که چه کسی بیشترین تعداد GPU را در اختیار دارد، بلکه بر سر داشتن یکپارچهترین سیستم است.
این گذار در حالی رخ میدهد که صنعت با سدّی در خوشههای شتابدهنده سنتی برخورد کرده است. سالها تمرکز بر افزودن تراشههای بیشتر بود، اما اکنون گلوگاه اصلی، تعامل بین ظرفیت محاسباتی و سیستمهای شبکهای است که آنها را به هم وصل میکند. همانطور که در تحلیل قبلی ما دربارهی تغییرات داخلی OpenAI و تأثیر گرگ بروکمن بر مسیر شرکت اشاره کردیم، این حرکت زیرساختی نشاندهنده یک شرطبندی بزرگ روی طراحی مشترک سختافزار و نرمافزار (Hardware-software co-design) برای حفظ برتری است.

برخلاف محصولات تکتراشهای، GB200 NVL72 یک معماری رکمقیاس (Rack-scale) است. این یعنی با مجموعهای عظیم از منابع محاسباتی، نه به عنوان قطعات جداگانه، بلکه به عنوان یک سیستم هماهنگ برخورد میکند. این یکپارچگی برای کل چرخه مدلهای پیشرو، از پیشآموزش در مقیاس کلان تا سیستمهای استنتاجی که به میلیونها کاربر سرویس میدهند، حیاتی است.
چرا زیرساخت رکمقیاس اهمیت دارد؟
برای شرکتی که مدلهای نسل بعد را میسازد، همراستایی بین محاسبات و اتصال (Connectivity) اولویت اول است. پیامد عملی GB200 NVL72 صرفاً دسترسی به شتابدهندههای بیشتر نیست؛ بلکه به OpenAI اجازه میدهد با مرکز داده به عنوان یک واحد محاسباتی منسجم برخورد کند.
تأیید انویدیا مدرکی عینی است که نشان میدهد زیرساخت آموزشی OpenAI شامل این کلاس از سیستمهای یکپارچه است. همچنین سیگنالی است که نشان میدهد انویدیا، OpenAI را کاربر کلیدی در انتقال بحرانی از فاز آموزش به استنتاج عملیاتی در محیط تولید میبیند. این تمرکز بر استنتاج در مقیاس بالا، چالشهای جدیدی را نیز به همراه دارد؛ برای مثال، هزینههای نظارت بر ایمنی در مدلهای پیشرو مانند Astra و GPT-5.6 اکنون بخش قابل توجهی از کل محاسبات استنتاجی را به خود اختصاص داده است.
نقشه راه زیرساختی
در حالی که GB200 ابزار تأییدشده فعلی OpenAI است، انویدیا با پلتفرم Vera Rubin مرزها را جابهجا میکند. معماری روبین به عنوان یک «کارخانه AI» کامل برای کل چرخه حیات، از پیشآموزش تا استنتاج عاملمحور (Agentic Inference) — یعنی مدلهایی که مثل شطرنجباز چند حرکت جلوتر را میبینند و برای رسیدن به هدف برنامهریزی میکنند — طراحی شده است.
اجزای کلیدی اکوسیستم روبین عبارتند از:
- رَکهای Rubin GPU و Vera CPU
- شبکهبندی Groq LPX و BlueField-4
- سوئیچهای Spectrum-6
به گزارش مایکروسافت آزور (Microsoft Azure)، استقرار بیوقفه رَکهای Vera Rubin NVL72 در «ابرکارخانههای AI» این شرکت در حال انجام است. این یعنی نسل بعدی زیرساختها به جای استقرار در محیطهای سفارشی و ایزوله، مستقیماً در دل محیطهای ابری تعبیه میشوند. این یکپارچگی در پلتفرم آزور نشان میدهد سازندگان مدلها از شتابدهندههای تکگانه به سمت سیستمهای مقیاس مرکز داده حرکت میکنند.
تفکیک نسلهای سختافزاری
باید بین این دو نسل تفاوت قائل شد تا ادعاهای متناقض شکل نگیرد و این دو در یک ادعای واحد ادغام نشوند. انویدیا صراحتاً OpenAI را به GB200 NVL72 مرتبط کرد، اما مستندات و تحقیقات فعلی هنوز استقرار خاص پلتفرم روبین در OpenAI را تأیید نکردهاند.
روبین مسیر آینده است، اما شواهدی از عملکرد، هزینه، مصرف انرژی یا در دسترس بودن مدلهای OpenAI که روی این سختافزار خاص آموزش دیدهاند، وجود ندارد. این دو، گامهای مرتبط در یک استراتژی گستردهتر هستند، اما جایگزین یکدیگر نیستند.
برای رهبران کسبوکار، این تغییر یعنی ظرفیت AI اکنون یک مسئله مهندسی سیستم است. معرفی سختافزار به تنهایی تضمینکننده ویژگی جدید یا کاهش قیمت برای کاربر نهایی نیست. در عوض، این سختافزارها بر این اثر میگذارند که یک ارائهدهنده با چه سرعتی میتواند روی مدل خود تکرار (Iterate) کند و با چه پایداریای آن را در مقیاس بالا ارائه دهد.
سه تغییر عملیاتی اکنون مشهود است:
- همگرایی حجمهای کاری: آموزش و استنتاج از نظر عملیاتی در حال یکی شدن هستند. انویدیا صراحتاً استفاده از GB200 NVL72 را هم به آموزش نسل بعد و هم به استنتاج تولیدی مرتبط میکند.
- یکپارچگی در مقیاس ابری: ابزارهای ابری مکانیسم اصلی تحویل شدهاند. مستندات استقرار روبین در آزور به پذیرش در مقیاس «ابرکارخانه AI» اشاره دارد.
- خندقه استراتژیک: مقیاس عظیم این سیستمها، سختافزار زیربنایی را به یک خندقه استراتژیک (Strategic Moat) برای تعداد کمی از شرکتها تبدیل میکند که توان مالی تأمین آنها را دارند.
در نهایت، ارزش تجاری برای سازمانها نه در دانستن نوع رَکهای OpenAI، بلکه در پیادهسازی گردشکارهای متناسب با نیازهای عملیاتی است. با تخصصیافتهتر شدن زیرساختها، سرعت توسعه مدلها احتمالاً افزایش مییابد، اما شرایط تجاری، قابلیت اطمینان و حاکمیت این سرویسها همچنان دغدغه اصلی خریداران است.
همانطور که ارائهدهندگان AI بر روی زیرساختهای تخصصیتر متمرکز میشوند، دیده شدن در پاسخهای تولید شده توسط AI در کنار عملکرد جستجوی سنتی به یک دغدغه استراتژیک تبدیل میشود. Scalevise به تیمها کمک میکند تا ارزیابی کنند برند و تخصص آنها چگونه در تجربههای اکتشاف AI ظاهر میشود، شکافها را شناسایی کرده و از طریق AI Visibility و GEO Checker، بهبودهای عملی را اولویتبندی کنند. این کار به تیمهای بازاریابی و محصول کمک میکند تا به جای فرضیات، با شواهد به پلتفرمهای در حال تغییر AI پاسخ دهند. یک اسکن AI Visibility را شروع کنید.
منتظر بنچمارکهای آتی در مورد توان عملیاتی (Throughput) و بهرهوری انرژی باشید، زیرا اولین موج مدلهای آموزشدیده با GB200 وارد محیط تولید میشوند. آزمون واقعی این خواهد بود که آیا این رویکرد رکمقیاس میتواند هزینه استنتاج عاملمحور را برای کاربر نهایی به طور قابل توجهی کاهش دهد یا خیر.
گام بعدی شما
- رصد بنچمارکهای توان عملیاتی (Throughput) و بهرهوری انرژی در مدلهای آموزشدیده با GB200.
- تحلیل اثر کاهش هزینههای استنتاج بر قیمت سرویسهای API در ماههای آینده.
- بررسی قابلیتهای استنتاج عاملمحور در مدلهای جدیدی که از معماری روبین بهره میبرند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو