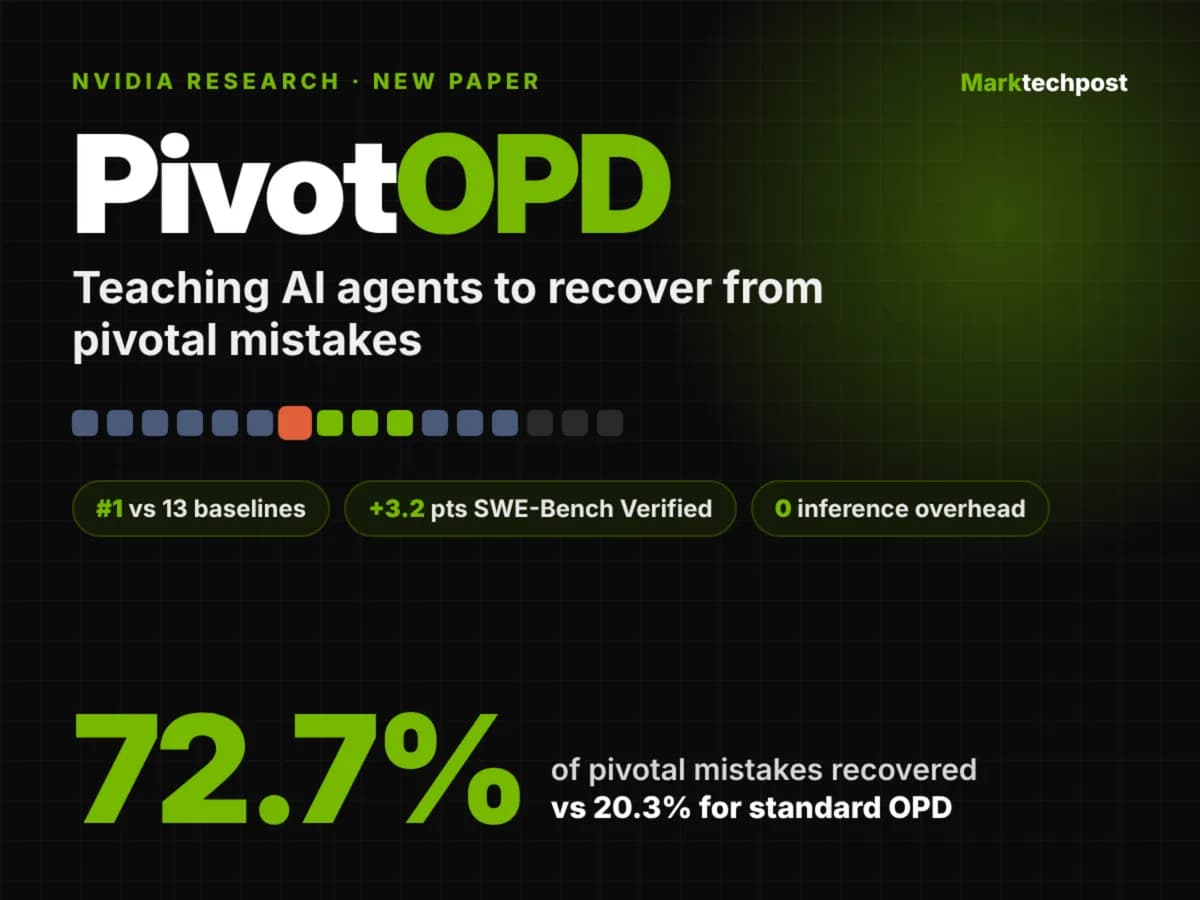
تصور کنید یک ربات برنامهنویس در گام دهم یک پروژه، اشتباهی کوچک در معماری دیتابیس مرتکب شود و تا گام سیام، بدون اینکه بفهمد کجا مسیر را گم کرده، به تلاشهای بیثمر ادامه دهد. این «نقطه کور» در آموزش عاملهای هوش مصنوعی است که اکنون انویدیا راهکاری برای عبور از آن یافته است.
طبق اعلام تیمی مشترک از انویدیا (NVIDIA)، دانشگاه پرینستون و دانشگاه مریلند در ۸ اکتبر ۲۰۲۶، متد PivotOPD معرفی شد. این روش یک سیستم تقطیر (Distillation) در حین اجرا (On-policy) است که بهطور خاص برای بازیابی عاملها در تعاملات چندمرحلهای طراحی شده تا یک اشتباه زودهنگام، کل مأموریت را به شکست نکشاند.
مشکل: اشتباهات محوری
بسیاری از عاملهای فعلی در آموزش دچار یک نقص ساختاری هستند: اگر تمام تلاشهای یک مدل برای انجام وظیفهای شکست بخورد، یادگیری تقویتی (Reinforcement Learning) سنتی هیچ سیگنالی برای بهبود ارائه نمیدهد. این موضوع در مورد «اشتباهات محوری» (Pivotal Mistakes) شدیدتر است؛ یعنی اقداماتی که یا مسئله را غیرقابل حل میکنند یا مسیر رسیدن به هدف را بهشدت طولانی میکنند.
بر اساس بررسیهای پژوهشگران روی مدلهای Qwen3 (در نسخههای 8B، 30B-A3B و 235B-A22B)، ۵۹٪ از تلاشهای شکستخورده (۱۵۵ مورد از ۲۶۲ مورد) حاوی چنین اشتباهاتی بودهاند. این خطاها معمولاً زود رخ میدهند، بهطوری که میانگین وقوع آنها بین گام ۸ تا ۱۲ از مجموع ۳۰ گام است. پس از وقوع یک اشتباه محوری، عاملها بهطور معمول ۱۸ تا ۲۱ گام دیگر را بدون هیچ اصلاحی هدر میدهند و در نهایت شکست میخورند.
چرا روشهای سنتی شکست میخورند؟
تقطیر سنتی در حین اجرا (OPD) برای بازیابی ناکارآمد است. اگرچه این روش نرخ شکست کلی در دادههای خارج از آموزش (Held-out) را از ۷۹٪ به ۵۶٪ کاهش داد، اما شکستهایی که پس از یک گام محوری رخ میدادند، تنها از ۵۱٪ به ۴۹٪ رسیدند. در واقع احتمال اینکه مدل در لحظه بحرانی، اقدام درست را نمونهبرداری (Sample) کند، در ۸ اجرای مختلف زیر ۱٪ باقی ماند.
یادگیری تقویتی مبتنی بر نتیجه (Outcome-based RL) نیز همین نقطه کور را دارد؛ اگر تمام تلاشهای یک گروه شکست بخورند، مزیت نسبی گروه (Group-relative advantage) برابر با صفر میشود و مدل هیچ جهتی برای بهبود پیدا نمیکند. این چالشها در واقع تکاملیافتهی مشکلاتی است که در سازوکارهای اصلاح خودکار رفتار عاملها برای کاهش نرخ خطاهای ابزاری بررسی شده بود.
PivotOPD این مشکل را با معرفی سه مؤلفه خاص در حلقه آموزش، که در یک بهروزرسانی واحد PPO ترکیب شدهاند، حل میکند:
- تشخیص محور (Pivot Detection): یک مدل معلم بزرگ، هر اجرای کامل و نتیجه نهایی آن را با نگاه به گذشته (Hindsight) بررسی میکند. این مدل گامهای کاندید را شناسایی کرده و یک «اقدام طلایی» (Gold Action) را نامگذاری میکند. اگر اقدام مدل شاگرد با این اقدام طلایی متفاوت باشد، آن گام به عنوان نقطه محوری علامتگذاری میشود. در محیط ALFWorld، این نقاط شناسایی شده در ۷۷.۸٪ از تلاشهای شکستخورده با نقاط محوریِ پیشبینی شده توسط اوراکل نمادین (Symbolic Oracle) مطابقت داشتند.
- تقطیر پیشگیرانه (Preventive Distillation): با استفاده از واگرایی KL معکوس، یک نسخه منجمد از مدل شاگرد که با اقدام طلایی راهنمایی شده است، پاسخهای خودِ شاگرد را مجدداً امتیازدهی میکند. این فرآیند مدل شاگرد را به شدت از ارتکاب آن اشتباه خاص دور میکند.
- تقطیر بازیابی (Recovery Distillation): مدل معلم، اقدامات بازیابی را برای حداکثر K گام پس از نقطه محوری تعیین میکند. یک «خود-معلم» (Self-teacher) که راهنمایی شده است، پاسخهای بازیابی را مینویسد و مدل شاگرد بدون راهنما، از طریق واگرایی KL مستقیم روی آنها آموزش میبیند. این رویکرد «پوشش گسترده» (Mass-covering)، اقداماتی را تقویت میکند که مدل شاگرد بهطور طبیعی هرگز آنها را نمونهبرداری نمیکرد.
عملکرد در محکهای ارزیابی
به گزارش Marktechpost، نتایج بهدستآمده خیرهکننده است. در مدلهای شاگرد Qwen3-1.7B، متد PivotOPD در محک ALFWorld به میانگین ۷۳.۷٪ رسید که ۵.۵ امتیاز بالاتر از خط پایه SDAR است. در پرسشوپاسخهای مبتنی بر جستوجو (Search-based QA)، این عدد ۴۴.۵٪ بود که ۵.۹ امتیاز بالاتر از RLSD است. همچنین در WebShop، این متد امتیاز را ۱.۲ واحد نسبت به RLSD افزایش داد، اما در نرخ موفقیت جهشی چشمگیر داشت و با رسیدن به ۷۶.۶٪، ۱۴.۱ واحد موفقتر از RLSD عمل کرد.
برای مدل بزرگتر Qwen3-8B، نتایج حتی درخشانتر بود: ۹۳٪ در ALFWorld، ۴۷.۴٪ در جستوجوی QA و ۸۱.۹٪ در WebShop. جالب اینجاست که حتی وقتی مدل Qwen3-8B به عنوان معلم خودش عمل کرد، امتیازات بنچمارک بهطور متوسط ۳.۹ امتیاز رشد کردند.
معیارهای بازیابی و کدنویسی
مهمترین عدد، نرخ بازیابی است. در بازپخش ۷۲ اشتباه محوری، PivotOPD توانست از ۷۲.۷٪ آنها بازیابی کند؛ در حالی که مدل پایه تنها ۸.۳٪، OPD سنتی ۲۰.۳٪ و تقطیر صرفاً پیشگیرانه ۴۵.۸٪ موفق بودند. همچنین زمان بازیابی در این متد به میانگین ۹.۷ گام رسید که به عدد بهینه (۶.۲ گام) بسیار نزدیک است.
علاوه بر عاملهای عمومی، این تیم متد را روی Nemotron-3.5-SFT در مجموعه داده SWE-Bench Verified پیاده کرد. با آموزش توسط Nemotron-3-Super، عملکرد مدل شاگرد از ۶۲.۸٪ به ۶۶.۰٪ افزایش یافت، در حالی که OPD سنتی تنها به ۶۳.۰٪ رسید (در حالی که عملکرد مدل معلم ۷۳.۰٪ بود).
هزینههای فنی و محدودیتها
این دستاورد از دیدگاه فنی، این فرض را که «بازیابی یک ویژگی نوظهور ناشی از مقیاس (Scale) است» تغییر میدهد. این نتایج ثابت میکند بازیابی یک مهارت یادگیرانه است که نیاز به تقطیر هدفمند دارد. در مقابل، برخی پژوهشها هشدار میدهند که حلقههای تکرار در حافظه عاملها میتواند منجر به تخریب دادهها شود، اما PivotOPD با رویکرد تقطیر هدفمند، این ریسک را مدیریت کرده است. از آنجا که PivotOPD فقط در مرحله آموزش اثر میگذارد، هزینه استنتاج (Inference) را افزایش نمیدهد و عامل نهایی در هر جایی که مدل پایه اجرا شود، بدون سربار اضافی کار میکند.
با این حال، این متد نیازمندیهای خاصی دارد:
- محیط: وابستگی کامل به محیطهای قابل بازپخش (Replayable) دارد.
- کیفیت معلم: نیازمند معلمی است که تشخیصاتش در ۷۷.۸٪ از موارد شکست با اوراکل مطابقت داشته باشد.
- محاسبات: آموزش روی گرههای NVIDIA H100 انجام شده است. برای مدل شاگرد 1.7B روی ۴ پردازنده H100، سربار محاسباتی نسبت به GRPO در حالت K=1 حدود ۱۲.۴٪ است، اما در حالت K=2 به دلیل نیاز به بازپخش محیط برای گامهای بازیابی بعدی، این رقم به ۹۴.۲٪ جهش میکند.
این تحول نشان میدهد جهش بعدی در قابلیت اطمینان عاملها، نه از طریق گسترش پنجره متنی، بلکه از طریق حلقههای آموزشی «نگاه به گذشته» (Hindsight) حاصل خواهد شد که شکست را به عنوان یک نقشه ساختاریافته برای اصلاح در نظر میگیرند.
گام بعدی شما
- اگر در حال توسعه عاملهای Agentic هستید، به جای افزایش اندازه مدل، روی پیادهسازی حلقههای بازبینی (Review Loops) برای شناسایی نقاط شکست تمرکز کنید.
- مستندات مربوط به تقطیر مدلهای Qwen3 را برای بهینهسازی مدلهای کوچکتر مطالعه کنید.
- بررسی کنید آیا محیطهای عملیاتی شما قابلیت Replay دارند تا بتوانید از متدهای مشابه PivotOPD استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو